ZCode多模型配置实战:五家模型接入教程

手把手教你把 DeepSeek、Kimi、MiMo、千问、GLM 五家模型接入 ZCode 统一调度,含配置坑点与实测速度对比。
本文介绍如何将 DeepSeek、Kimi、MiMo、千问、GLM 五家主流国产大模型通过自定义供应商功能接入 ZCode 桌面端 Agent 客户端,从而用一个工具统一调度已订阅的各家模型。配置流程统一为填写 Base URL、选择 API 协议(OpenAI 或 Anthropic 格式)、粘贴 API Key 和逐一添加模型 ID 四步,但 ZCode 的自动识别并不可靠,Kimi4Coding 和 MiMo 的上下文窗口均需手动修正。实测中带「Flash」或「高速」标签的版本响应速度显著更快,旗舰模型在识图等轻任务上性价比偏低。文章还观察到 GLM-5.3 这一无多模态能力的模型在 Agent 工具链加持下,能自行编写脚本完成图片识别,体现了 Agent 客户端相较于纯聊天工具的扩展价值。
ZCode 是智谱推出的桌面端 Agent 应用,自带模型能力不错但订阅价格偏高。它的模型管理支持自定义供应商,这意味着你完全可以把手上已经订阅的 DeepSeek、Kimi、MiMo、千问、GLM 接进同一个客户端统一调度。下面把五个供应商的完整配置流程、容易踩的坑以及实测速度一次讲清。
准备工作:客户端与配置逻辑
安装与跳过登录
从智谱官网下载 ZCode 桌面端安装包,首次打开是登录页。没有订阅的话,选择「使用 API Key」,再点「暂时跳过」,就能直接进入工作区。整个配置过程不需要智谱账号。
自定义供应商的四个字段
进入「管理模型 → 添加供应商 → 创建自定义供应商」,要填的东西其实只有四样:Base URL、API 协议(OpenAI 或 Anthropic 格式)、API Key,以及逐个添加模型时的模型 ID。五个供应商走的都是这套流程,差别只在协议类型和 Key 从哪里拿。

API 协议选择会影响请求格式与响应解析方式。OpenAI 格式是目前国内外最通用的大模型接口标准,采用 POST /v1/chat/completions 端点,请求体以 JSON 传递 messages 数组;Anthropic 格式则由 Claude 系列模型衍生而来,结构略有差异,messages 字段语义相近但系统提示的传入方式不同。ZCode 会根据你选择的协议类型封装请求,所以选错协议会导致认证失败或响应解析出错。Kimi 和千问控制台尽管底层使用自研模型,但对外暴露的接口格式选择了 Anthropic 兼容,而 DeepSeek广告 和 MiMo 则走 OpenAI 格式——配置时需以各家官方文档说明为准,而非凭模型品牌猜测。
模型 ID 会自动识别上下文窗口
填完模型 ID 后,ZCode 会尝试自动匹配上下文长度与最大输出 token,并在高级配置里预勾选文本/图片/视频输入、结构化输出、原生联网搜索,以及推理等级(Low/High/Max,或 Disable/Enable)。识别不准的地方必须手动改,这一步决定了后面调用会不会中途报错。
DeepSeek:Flash 与 Pro 怎么选
DeepSeek 有两个模型可选:Flash(对应 V4.1 Flash)和 Pro(对应 V4 Pro 0813)。Flash 是多模态、支持图像理解、整体价格更低,性能反而更强;Pro 不支持图像理解。所以作者的建议很直接——既然用 DeepSeek,就全部上 Flash。
配置时上下文窗口填 1M,最大输出 384K,输入类型勾上文本和图片,推理等级在 Low/High/Max 里选。保存之后点「测试连接」验证一下,通过就能回工作区用了。
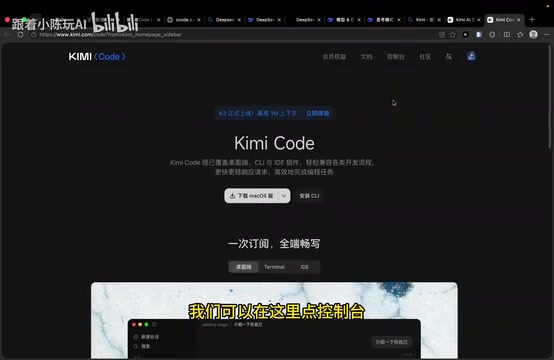
Kimi:四个模型 ID 的取舍
Kimi Code 目前提供四个模型,各自的定位差别明显:
- K3:上下文 1048576(约 1M),最大输出 131072,支持图片和视频,推理等级默认 High。
- K3-256K:上下文 262144,消耗大约是 K3 的一半,常规速度。
- Kimi4Coding:综合性能接近 K3,思考效率更高,擅长代码补全与常规开发任务。注意 ZCode 自动识别出的窗口是 200K,需要手动改回 1M;它支持图片和视频,推理等级可以自己配 Low/High/Max。
- 高速版(High Speed):输出速度是普通版的 5–6 倍,代价是消耗约为 3 倍,上下文 262144,同样支持图片和视频,思考项只有 Disable/Enable 一个开关。
Base URL 用国内节点,协议走 Anthropic 格式,API Key 在 Kimi 控制台新建。
MiMo:性价比路线
小米 MiMo 开放平台的 Token Plan广告,月付 34 元档,额度高、速度快,是目前性价比比较突出的一档。它的亮点是全模态理解——文本、图片、音频、视频都支持,还支持结构化输出。原生联网搜索需要额外开通联网服务插件,按 16 元/1000 次计费,教程里没有开启。推理等级只有 Disable/Enable,对应请求里的深度思考开关。
只配 V2.6 Pro 和 V2.6 Flash 就够了,2.5 系列接近下线;上下文 1M、最大输出 128K,这两个数值 ZCode 都会识别错,得手动填。
千问 Token Plan:一个 Key 调多家模型
阿里云千问平台的 Token Plan,月付 39/79/139 多档,季付更便宜。它最大的特点是同一个 Key 不只能调千问自家模型(3.8 Max、3.8 Flash),还能直接调 DeepSeek,以及智谱的 GLM-5.3、5.2。协议同样走 Anthropic 格式,接口地址在控制台的 API keys 页面查看。

「Token Plan」是阿里云百炼平台推出的预购额度订阅机制:用户提前按月或按季支付固定费用,换取对应数量的 Token 调用额度,调用单价低于按量付费档。相比按量计费,Token Plan 适合用量稳定、每月消耗可预估的场景;对于偶发性使用,按量付费反而更划算。千问平台的 Token Plan 之所以能调用 DeepSeek、GLM 等外部模型,是因为阿里云百炼将多家第三方模型统一接入了自己的 API 网关,用户通过同一个 Base URL 和 API Key 即可访问,账单也统一结算在阿里云账户下,省去了分别管理多份密钥和余额的麻烦。
GLM:不支持图像时的「曲线救国」
GLM-5.3 只支持文本,推理等级分 Low/High/Max。但实测里出现了一个挺有意思的现象:把图片丢给不支持多模态的 GLM-5.3,它没有直接报错,而是自己写了一段脚本来读取图片,最后把图识别出来了,准确度还不错。ZCode 内置的工具可以直接打开这段脚本查看,也可以用自己的终端打开。这正好体现了 Agent 客户端和纯聊天工具的区别——模型能力之外,客户端提供的工具链能补上一部分短板。
Agent 客户端与普通聊天界面的核心差异在于「工具调用」(Tool Use / Function Calling)能力的集成深度。在纯聊天工具里,模型输出什么,用户就看到什么;而在 Agent 框架中,模型可以生成结构化的工具调用指令(如执行脚本、读写文件、调用浏览器),由客户端在本地执行并将结果反馈给模型,形成「思考→行动→观察」的循环。GLM-5.3 面对图片时自行编写读图脚本,正是这一机制的体现:模型本身没有视觉解码能力,但它能利用 Agent 环境提供的代码执行工具间接完成任务。这种能力组合的上限取决于客户端提供哪些工具,而非模型参数规格本身。
实测:速度与多模态对比
同样一句「你好,你是什么模型」加一张截图,五个供应商的表现差别不小:
| 模型 | 上下文 | 多模态 | 图片识别耗时 |
|---|---|---|---|
| DeepSeek Flash | 1M | 文本+图片 | 秒回 |
| K3 | 约 1M | 图片+视频 | 约 27 秒 |
| K3-256K | 262K | 图片+视频 | 约 40 秒 |
| Kimi4Coding | 1M | 图片+视频 | 30 秒以上 |
| 高速版 | 262K | 图片+视频 | 约 7 秒 |
| MiMo V2.6 Pro | 1M | 全模态 | 约 11 秒 |
| MiMo V2.6 Flash | 1M | 全模态 | 约 14 秒 |
| 千问 3.8 Max | 约 1M | 文本+图片 | 约 28 秒 |
| 千问 3.8 Flash | 约 1M | 文本+图片 | 约 10 秒 |
| 千问 v4.1 Flash | 约 1M | 文本+图片 | 约 16 秒 |

规律很清楚:带「Flash」「High Speed」字样的版本普遍更快,代价是消耗更高或者上下文更小;名字里带大版本号的旗舰模型往往推理更强,但识图这种轻任务上并不划算。
配置经验总结
自动识别不能全信。 Kimi4Coding 被识别成 200K,MiMo 两个模型的窗口和输出全错,保存前对着官方文档核一遍是必要动作。
推理等级要按需配。 Low/High/Max 三档直接对应成本和延迟,默认值不一定适合你的场景。
配完记得重命名供应商。 不改名的话,工作区模型列表里全是「自定义供应商1/2/3」,切换模型时根本认不出谁是谁。
没买的服务别开。 原生联网搜索、联网插件这类能力都是单独计费的,除非确实买了,否则不用勾。
作者最后给出的判断是:在国产 Agent 客户端里,ZCode 的体验属于最顺滑的一档,桌面端代码已经开源,登录还可能拿到免费额度,值得作为入门 Agent 工具的第一个选择。上手门槛不高,把已有模型的 Key 接进来就能跑,这是它比「绑定自家订阅」的产品更友好的地方。
相关推荐
OpenAI遭遇黑客入侵 Altman面临法律风险累积
OpenAI在内部调查中发现系统遭黑客入侵,CEO奥特曼同时面临法律风险累积。本文梳理AI公司数据安全隐患、企业治理争议与合规挑战,分析事件背后的行业启示。

mcp.so 实用指南:一站式发现MCP服务器扩展AI编程能力
mcp.so 是一个发现 MCP 服务器的目录平台,帮助 AI 编程开发者为智能体连接外部工具和服务。本文介绍它的功能、使用方法以及对 AI 工作流的价值。

顶尖企业用好AI的秘诀:从实验走向成熟管理层
基于KPMG第三季度AI Pulse调查,解析用好AI的顶尖企业与实验阶段企业的关键差距:模型路由、数据主权、AI管理层、成本与价值管理,以及从效率到机会的用途转变。