ZGCM-1:7B全开源模型如何用工具调用挑战千亿级大模型
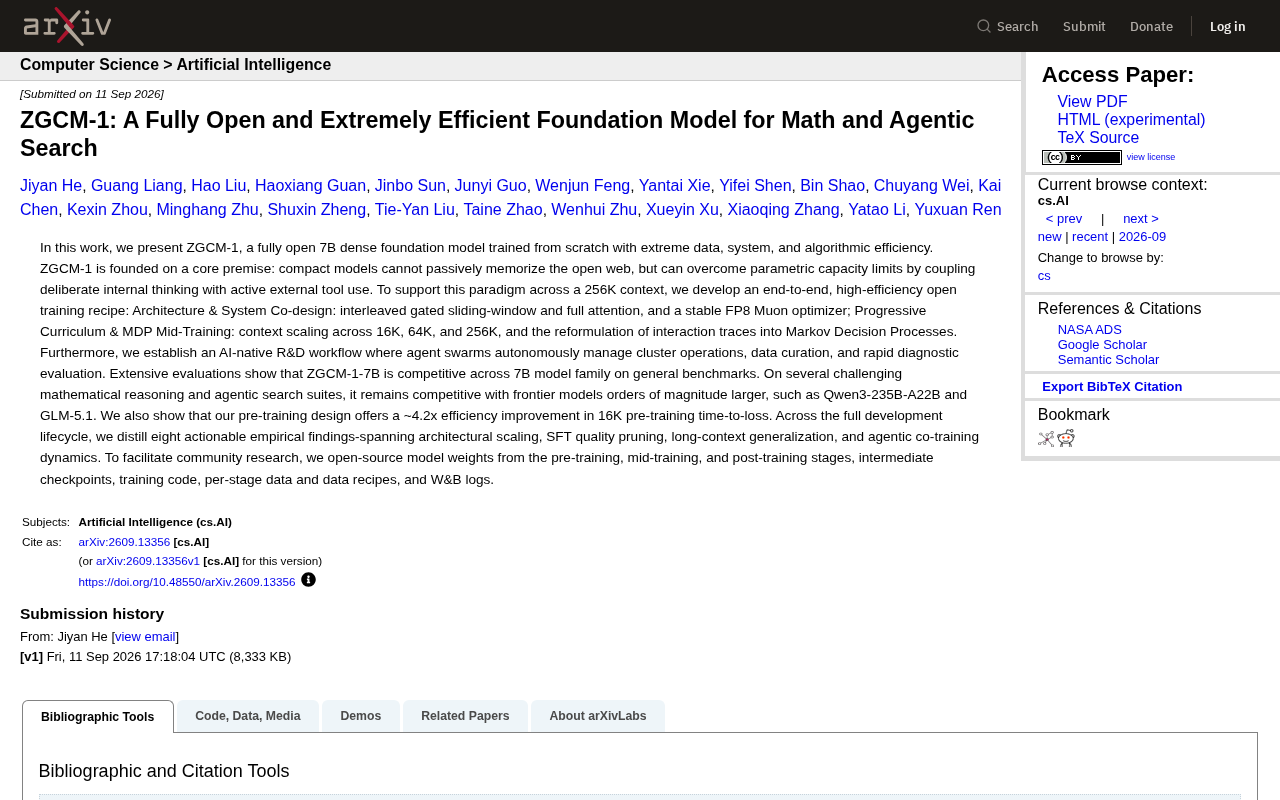
ZGCM-1:7B全开源模型,以深度推理+工具调用在数学推理和智能体任务上挑战千亿级大模型。
ZGCM-1 是一个完全开源的 70 亿参数稠密基础模型,核心主张是:小模型不应被动压缩海量知识,而应通过「内部深思熟虑 + 主动外部工具调用」突破参数容量天花板。技术层面,它采用交错门控滑窗与全注意力混合架构支持 256K 超长上下文,结合 FP8 Muon 优化器将 16K 预训练效率提升约 4.2 倍;训练策略上以渐进式课程扩展上下文长度,并将工具调用轨迹建模为 MDP 进行中期训练。评测结果显示,ZGCM-1-7B 在数学推理和智能体搜索任务上可与 Qwen3-235B-A22B、GLM-5.1 等超大模型竞争。此外,它公开了全阶段权重、中间检查点、训练代码、数据配方及 W&B 日志,为社区提供了可真正复现的完整训练流水线。
小模型的新思路:不靠记忆,靠思考与工具
参数量的军备竞赛让人们习惯了「越大越强」的逻辑,但 ZGCM-1 提出了一个反直觉的核心命题:紧凑模型无法被动地记住整个开放网络,却可以通过将「深思熟虑的内部思考」与「主动的外部工具调用」耦合起来,突破参数容量的天然限制。
这是一个完全开源(fully open)的 70 亿参数稠密基础模型,从零开始训练,主打数据、系统与算法三个层面的极致效率。它想回答的问题很直接:当一个 7B 模型学会「查资料」和「用工具」,它能否在特定任务上追平那些大它几个数量级的前沿模型?
从论文给出的评测结果看,答案相当乐观——在数学推理和智能体搜索(agentic search)这两类高难度任务上,ZGCM-1-7B 与 Qwen3-235B-A22B、GLM-5.1 这类庞然大物保持了竞争力。
架构与系统协同设计
要让一个小模型跑得又快又稳,光调参数远远不够。ZGCM-1 在架构层面做了两项关键设计。
第一是交错式门控滑窗注意力与全注意力(interleaved gated sliding-window and full attention)。这种混合注意力机制的思路,是在大部分层用计算成本更低的滑动窗口注意力处理局部信息,在关键层保留全注意力捕捉长程依赖,从而在支持 256K 超长上下文的同时控制算力开销。
第二是稳定的 FP8 Muon 优化器。FP8 低精度训练能显著提升吞吐、降低显存占用,但稳定性一直是难点。ZGCM-1 将 Muon 优化器与 FP8 结合并保持训练稳定,这在工程上是相当务实的选择。
这套协同设计带来的直接收益是效率:论文称在 16K 上下文的预训练中,其设计相比基线实现了约 4.2 倍的 time-to-loss 效率提升,即达到相同损失所需的训练时间缩短到约四分之一。
滑动窗口注意力的核心思想是:对序列中每个 token,只计算其与固定窗口大小(如前后 4096 个 token)内邻居的注意力权重,而非与所有 token 的全局注意力。这使得计算复杂度从标准 Transformer 的 O(n²) 降至 O(n·w)(w 为窗口大小),在长序列下节省显著。代价是单层无法直接捕捉距离超过窗口的依赖关系。交错设计的优势在于:稀疏层负责局部语义连贯性,间隔插入的全注意力层负责跨越全文的关联(如开头的问题与结尾的答案),两者分工协作,兼顾效率与能力。
FP8 精度指使用 8 位浮点数(而非常见的 BF16/FP16)表示模型参数与梯度。显存占用减半、矩阵运算吞吐翻倍,但 8 位的动态范围极窄,梯度更新容易溢出或下溢,历史上这类训练极易不稳定。将其与 Muon 优化器(一种基于矩阵正交化的二阶动量优化器,对梯度尺度不敏感)结合,是 ZGCM-1 在工程上化解这一矛盾的关键。
渐进式课程与 MDP 中期训练
长上下文能力不是一步到位的。ZGCM-1 采用渐进式课程学习(progressive curriculum),将上下文长度按 16K、64K、256K 分阶段扩展,让模型逐步适应更长的序列,而非一开始就在超长上下文上硬训。
更有意思的是它对交互轨迹的处理方式——把智能体与工具交互的过程重新表述为马尔可夫决策过程(MDP),并放在中期训练(mid-training)阶段。这意味着模型不是简单地模仿工具调用的文本序列,而是在一个具有状态转移和决策结构的框架下学习「何时思考、何时调用工具、如何根据反馈调整」。这种建模方式为后续的智能体协同训练奠定了基础。
马尔可夫决策过程(MDP) 是强化学习的标准形式化框架,由状态空间 S、动作空间 A、转移函数和奖励函数构成。将工具调用轨迹建模为 MDP 意味着:每一步模型观察当前「状态」(已有上下文 + 工具返回结果),选择「动作」(继续推理、调用搜索、调用计算器等),并根据最终任务完成情况获得奖励信号。这与传统监督微调(SFT)的区别在于:SFT 把工具调用当作固定文本序列来模仿,缺乏对「为什么在这里调用」的建模;MDP 框架则显式保留了时序决策结构,使模型能学习到条件策略——在观察到何种中间结果时该停止搜索、何时需要二次验证。这也是 ZGCM-1 区别于简单「工具增强微调」的关键设计差异。
AI 原生的研发流程
ZGCM-1 一个容易被忽略但颇具前瞻性的部分,是它建立了一套 AI 原生(AI-native)的研发工作流。在这套流程里,智能体集群(agent swarms)自主管理集群运维、数据筛选(data curation)以及快速的诊断评估。
换句话说,训练大模型的过程本身也被智能体接管了一部分。这反映出一个趋势:随着模型能力提升,模型研发的各个环节——从数据清洗到实验诊断——正在从人工密集型逐步转向由 AI 辅助甚至主导。对于追求极致效率的团队而言,这种自动化研发是压缩成本的重要杠杆。
「AI 原生研发流程」中的智能体集群(agent swarms),指多个专门化 AI 智能体并发协作完成同一宏观任务的架构模式。在 ZGCM-1 的语境下,这些智能体分别承担集群健康监控(检测 GPU 故障、训练发散等异常)、数据质量筛选(自动过滤低质语料、识别数据分布偏移)和快速消融评估(在小规模代理实验上验证超参改动效果)等角色。这种做法的实质收益是压缩人类决策延迟:传统训练中工程师需要人工分析日志、手动触发重跑,而自动化集群可在数分钟内完成诊断并执行修复动作。对于资源有限的团队,将研发人力从运维监控解放出来、聚焦到核心算法迭代,是提升整体效率的重要路径。
性能表现与八条经验
评测数据是这项工作最有说服力的部分。在通用基准上,ZGCM-1-7B 在 7B 模型家族中具有竞争力;而在若干具有挑战性的数学推理和智能体搜索套件上,它能与大它数个数量级的前沿模型(如 Qwen3-235B-A22B、GLM-5.1)掰手腕。
这印证了它的核心假设:在需要「查证 + 推理」的任务上,一个懂得调用外部工具的小模型,可以部分弥补参数量带来的知识存储差距。当然,这种竞争力主要体现在特定任务类型上,通用能力仍受限于模型规模,这一点需要客观看待。
论文还提炼了八条可操作的实证经验,覆盖架构扩展、SFT 数据质量剪枝、长上下文泛化、以及智能体协同训练的动态规律。这些经验对希望复现或改进小模型训练的研究者来说,价值可能不亚于模型本身。
真正的「全开源」
ZGCM-1 对开源的定义比大多数所谓「开源模型」要彻底得多。它公开的不只是最终权重,而是包括:
- 预训练、中期训练、后训练三个阶段的模型权重
- 中间检查点(intermediate checkpoints)
- 完整训练代码
- 各阶段的数据与数据配方(data recipes)
- W&B 训练日志
对整个社区而言,这种程度的开放意味着研究者可以真正复现整条训练流水线,而不是只能拿到一个黑箱权重去微调。数据配方和中间检查点的公开尤其珍贵,它们让「训练过程中到底发生了什么」变得可审视、可研究。
结语
ZGCM-1 的意义不止于「又一个 7B 模型」。它提供了一条清晰的技术路线:与其让小模型徒劳地压缩整个互联网的知识,不如教会它思考与使用工具,用主动的外部检索去补齐参数容量的短板。配合极致的训练效率和彻底的开源,这项工作为资源有限的团队参与前沿模型研究打开了一扇门。当然,其在通用能力上相对千亿级模型的真实差距,仍有待社区在更广泛的场景中检验。
相关推荐
Vercel AI SDK 发布 policy-opa 1.0.101 补丁更新
Vercel AI SDK 发布 @ai-sdk/policy-opa 1.0.101 补丁更新,同步依赖至 ai 7.0.101。本文解读该策略组件与 OPA 集成的作用及开发者升级建议。
Vercel AI SDK 更新:sandbox-just-bash 组件发布补丁版本
Vercel AI SDK 组件 @ai-sdk/sandbox-just-bash 发布 1.0.111 补丁版本,同步更新 harness 依赖。本文解读此次更新内容及其对开发者的意义。
Vercel AI SDK 发布 @ai-sdk/react@4.0.104 补丁更新
Vercel AI SDK 发布 @ai-sdk/react@4.0.104 补丁更新,主要同步升级底层依赖 ai@7.0.101。本文解析该版本更新内容、React 集成能力及开发者升级建议。