真不等于相关:Statewave Guide 揭示 AI 智能体验证盲区

AI 事实正确不等于相关:Statewave Guide 发现验证通过率与功能覆盖率之间存在显著鸿沟。
Statewave Guide 项目揭示了 AI 辅助代码理解中的新盲区:事实正确的断言也可能与用户所问的功能完全无关。实验显示,模型找到正确证据的概率高达 89%,但转化为可验证产品断言的比率仅 20%,71% 的功能没有任何经过验证的能力描述。问题的根源在于验证器只判断"事实是否成立",却不判断"事实是否属于当前功能"。团队由此引入 Feature Scope 层与图谱引导的确定性断言机制,将注意力从模型编造断言转向图谱主动枚举机会,使验证断言产出率从 20% 跃升至 95%,错误功能断言降至 0。但覆盖率依然受限——63 个功能中仍有 45 个没有验证能力,安全性提升并未带来覆盖率的同步增长。作者由此提出下一阶段的核心问题:技术上安全的产品知识,能否在真实用户面前存活?
在 AI 智能体与代码理解工具的开发中,确保模型输出的事实准确性一直被视为核心安全指标。然而,Statewave Guide 项目的最新实验表明,单纯的事实正确可能远远不够——一个关于表单提交的事实陈述通过了所有验证规则,却与用户真正询问的功能毫无关联。这种"技术正确但完全无关"的错误,正在成为 AI 辅助理解复杂应用图谱时的新盲区。
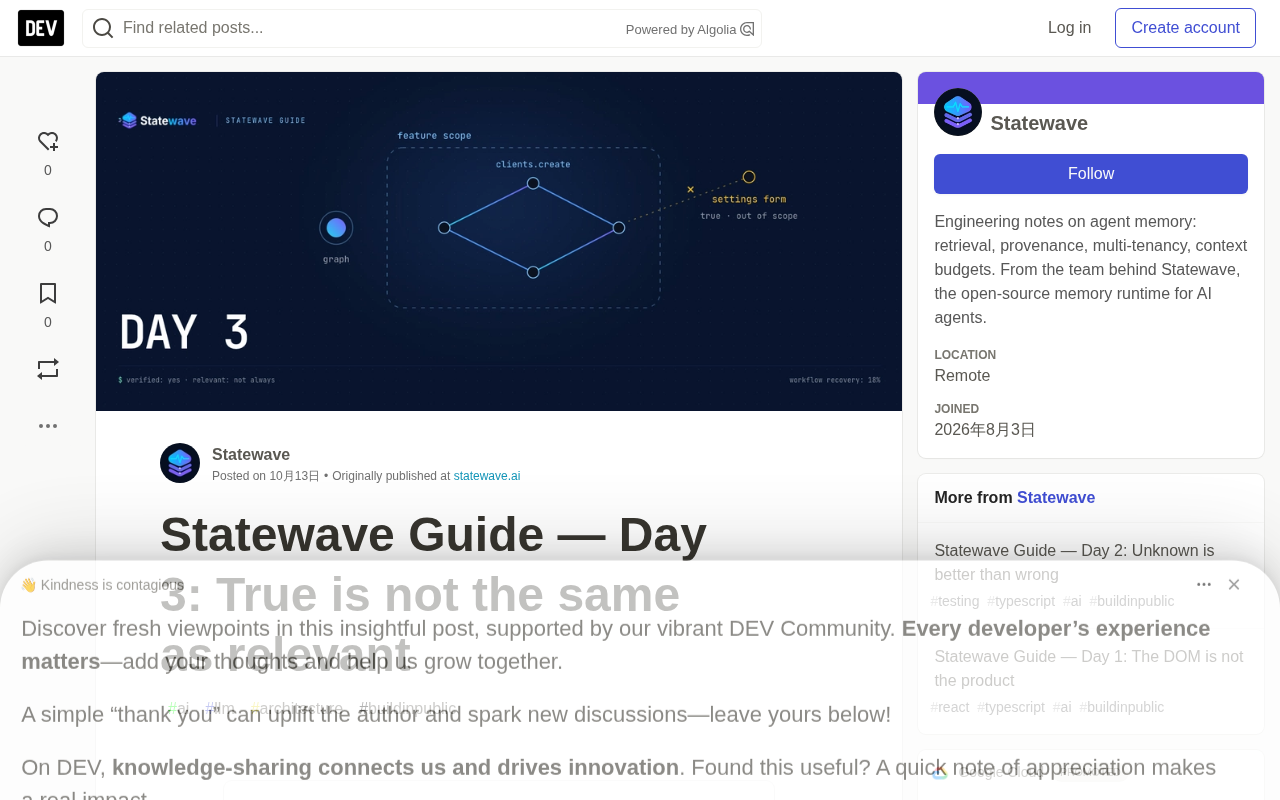
事实验证的漂亮成绩单
Statewave Guide 团队用 anthropic-opus-5 模型在自研应用上进行了数百次故意严苛的测试。结果令人印象深刻:零条虚构路由抵达产品模型、零条虚构权限、零个未知主题被错误引入。对于禁止的能力,模型在 27 次请求中全部拒绝;对于无依据的操作,23 次请求全部回绝。验证器在事实安全层面表现堪称完美。
但团队随后披露了一组反差极大的数据:模型有 89% 的概率能找到正确证据,却只有 20% 的概率将其转化为可验证的产品断言。71% 的功能最终没有任何经过验证的能力描述,工作流恢复率仅为 18%。一位开发者在文中调侃道:"技术上非常安全,实践上像一个被精心验证过的空房间。"
什么是"应用图谱"? 在这类代码理解工具中,"应用图谱"指的是对目标软件的结构化知识表示:将路由、组件、权限、服务、数据流等要素抽象为节点,将调用、依赖、包含等关系抽象为边,形成可供模型查询的图结构。它类似于软件工程中的调用图(call graph)或依赖图的扩展版本,但覆盖范围更广,还纳入 UI 层与业务语义。应用图谱的价值在于把散落在源码中的事实预先组织好,使 AI 助手不必每次从零推理,而是从已知的邻域中检索。理解这个词是理解全文的关键:Statewave Guide 的所有实验,本质上都是在检验"模型能否从图谱中挑出恰属于当前功能的断言"。
当真相不属于你问的功能
真正有趣的 bug 出现在一个看似无懈可击的断言上。模型输出:"设置更改通过提交设置表单来保存。"从结构上看,这个陈述完全正确——表单存在、表单会提交、关系成立,每一条验证规则都通过了。唯一的问题是:这个事实成立于整个应用,但并不属于当前分析的那个功能。
验证器回答了"这个陈述是否有真实证据支撑",却没有回答"这个证据是否真的属于这个功能"。这两个问题的区别构成了当日最重要的规则:真相还不够,上下文才拥有真相的所有权。 应用图谱本质上是一个邻域——相关组件、兄弟元素、路由与服务天然相邻。如果助手能从邻域中抓取任何真实事实,它就能生成技术正确但完全无关的答案。
Feature Scope(功能作用域) 是团队为修复上述盲区引入的中间层。在此之前,验证器只做二元判断:某条断言能否在图谱中找到真实证据?引入 Feature Scope 后,图谱会先确定当前分析的是哪个功能、该功能对应哪些节点与边,再仅从这一子图内生成候选断言。这相当于把"真相是否成立"的问题拆成两步:先在正确的上下文中定位,再判断断言本身是否成立。这一层的存在,直接解释了后文断言产出率从 20% 提升到 95% 的原因——模型不再需要自己在整个图谱中猜测哪条事实属于哪个功能,功能边界由图谱预先划定。
从模型猜测到图谱引导
团队意识到,他们此前要求模型完成的工作量过大:寻找证据、选择断言、选择操作、选择主语、选择关系,然后再进行解释。而源图谱其实已经掌握大部分信息。于是设计方向发生转变,从"模型→编造断言→验证器"改为"图谱→确定性断言机会→模型添加含义→验证器"。
新的流程保留了同样的安全边界,但大幅减少了模型的猜测空间。结果直接体现在数据上:经过验证的断言产出率从约 20% 跃升至 95%,错误功能断言降至 0,模型克制达到 30/30。然而有一个指标没有移动——63 个功能中仍有 45 个最终没有经过验证的能力。用作者的话说:"更安全了,但没有更丰满。"
确定性断言机会 指的是一种设计原则:与其让模型自由发挥、事后由验证器筛选,不如由图谱主动枚举所有"可以被安全断言的事实组合",再交由模型为这些组合赋予自然语言解释。这一转向的核心是把模型的角色从"事实生产者"降级为"表述者"。好处有三:一是模型不再有机会编造不属于该功能的事实;二是错误断言率可直接归零,因为每条断言都源自图谱中的真实边;三是验证成本大幅下降。其代价是覆盖率的提升依赖图谱本身的完整度——若图谱中没有某功能的能力描述,映射阶段也无从生成断言,这正是后文"45 个功能仍无验证能力"的根本原因。
安全的产品知识能经受真实用户吗?
Statewave Guide 建立在 Statewave 之上,后者是一个开源、自托管的 AI 智能体记忆运行时,强调治理与溯源而非单纯的检索,采用 Apache 2.0 许可。在实现了极高的验证安全度之后,团队提出了一个本该更早追问的问题:这些机制到底能不能帮到人类?
这引出了该系列的下一个核心问题:技术上安全的产品知识,在与真实用户接触后还能存活吗?对于构建 AI 编程助手、代码理解工具或企业知识库的开发者而言,这个问题的答案可能比验证通过率更重要。真正的挑战或许不在于让模型不说错话,而在于让它说出对当前上下文真正有用的话。
相关推荐

如何有效呈现你的想法:三种揭示式演讲方法
揭示式演讲是传递想法最直接的方式。本文解析奇妙漫步、动态演示和梦想图景三种演讲类型,结合David Gayo、Michael Pritchard、Sylvia Earle等经典案例,教你如何有效呈现想法。

Modern Web Guidance:让AI写原生声明式对话弹窗
Google Modern Web Guidance 让 AI 编程助手在生成代码时优先使用浏览器原生声明式 dialog 能力,替代重复的 JavaScript 事件监听,实测可显著减少样板代码。
ChatGPT 贴纸功能掀起 iMessage 与 WhatsApp 创意风暴
ChatGPT 图像生成功能正在 iMessage 和 WhatsApp 中催生个性化贴纸创作热潮,通用 emoji 使用量降至十年最低。本文分析这一趋势背后的技术逻辑、传播机制与对内容创作者的意义。