智利西班牙语:被忽视的LLM方言识别难题

Twitter帖子揭示大模型系统性忽视智利西班牙语,折射出AI处理低资源语言变体的普遍短板。
一条Twitter帖子以调侃口吻指出约80%的AI模型无法识别智利西班牙语,反而用阿根廷腔调回应,此事引发对大模型语言能力的严肃讨论。智利西班牙语因发音独特、俚语密集而在书面语料中严重缺席,模型在生成时倾向回退到训练数据中更主流的西班牙语变体,这是数据分布偏斜导致的隐性偏见,而非模型"不懂"该方言。这一现象并非孤例,全球大量语言的区域变体都面临类似困境,而现有评测基准几乎不考察方言识别和地域差异,导致问题长期被忽视。文章呼吁从数据均衡补充和专项评测两方面入手,让AI真正服务于语言多样的全球用户。
一个意外的"终极基准测试"
一条在Twitter上引发讨论的帖子提出了一个有趣的观点:智利西班牙语或许是检验大语言模型(LLM)语言能力的"终极基准测试"。按照帖子的说法,约80%的AI模型无法正确识别智利西班牙语,反而坚持用阿根廷人的方式说话。
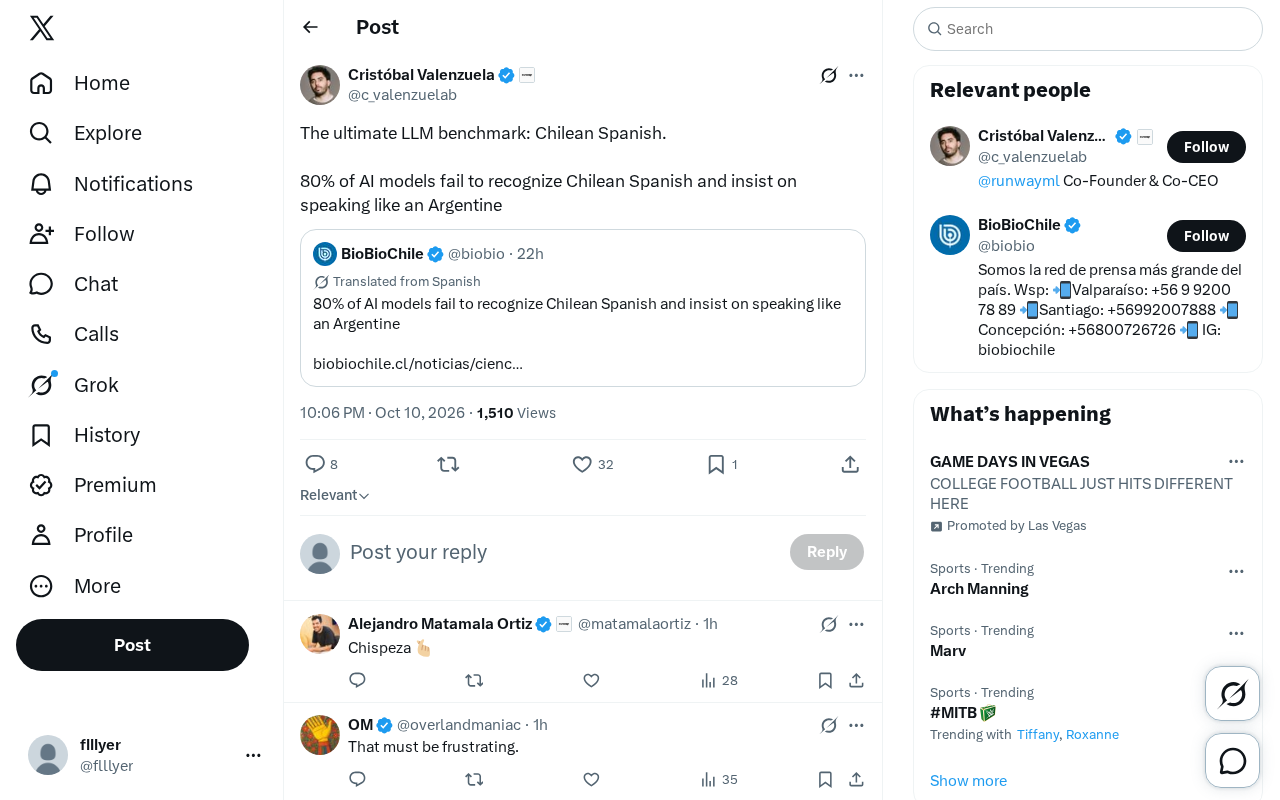
这条看似玩笑的观察,背后其实指向了一个被业界长期忽视的技术问题:主流大模型在处理区域方言和低资源语言变体时的系统性短板。虽然这条帖子带有调侃性质,缺乏严谨的量化数据,但它触及的现象值得认真对待。
为什么智利西班牙语对AI这么难
智利西班牙语在西班牙语世界里以难懂著称,即便对母语为西班牙语的人也是如此。它的发音特征明显——词尾辅音常被省略或弱化,语速快,还夹杂着大量独特的本地俚语(如"po"、"cachai"、"bacán"等)。这些特征使它与其他拉美西班牙语变体,尤其是语音上更"标准"的变体,形成鲜明对比。
从技术角度看,模型倾向于"回退"到更主流的西班牙语变体,根源在于训练数据的分布。互联网上的西班牙语语料高度集中于西班牙本土、墨西哥和阿根廷等地的内容,而智利特有的口语表达在公开语料中占比很小。当模型遇到不熟悉的方言输入时,它会向训练数据中出现频率最高的模式靠拢,于是输出结果就显得"不够智利"。
数据偏向带来的隐性偏见
这不是单纯的翻译错误,而是一种数据分布导致的隐性偏见。模型并非"不会"智利西班牙语,而是在概率上更倾向于生成它见过更多的表达方式。帖子中提到的"坚持像阿根廷人一样说话",恰好反映了阿根廷西班牙语在网络语料和文化输出中的相对强势地位。
语言学上将这种现象称为"领域偏移"(Domain Shift)——模型在训练分布之外的数据上表现下降。对于西班牙语而言,Common Crawl等主流爬虫语料库中,阿根廷和墨西哥的西班牙语内容合计占拉美西班牙语的比重远超其人口比例,因为这两个国家的互联网渗透率高、数字内容生产活跃,尤其是阿根廷在博客、文学和新闻领域有大量公开文本。智利西班牙语则因其高度口语化、俚语密集的特点,难以大量出现在正式书面语料中,这进一步加剧了统计上的"隐身"。模型本质上是在做加权概率预测,当某种表达方式的样本量级差异达到数量级时,即便模型"见过"智利表达,在生成时也会被更高频的模式所压制。
低资源语言变体的普遍困境
智利西班牙语的案例只是冰山一角。全球有大量语言和方言变体面临类似处境:它们有真实的使用者社区,却在数字语料中严重缺席。无论是地区性方言、少数族裔语言,还是口语化程度极高的变体,当前的大模型普遍难以准确还原它们的语感和文化特征。
这带来的影响是实际的。对于一个智利用户来说,AI助手如果总是用阿根廷腔调回应,不仅会显得生硬,还可能传递错误的文化信号,削弱产品的本地化体验。随着AI工具在全球范围内普及,这种"语言同质化"的倾向可能让非主流语言社区的使用体验打折扣。
研究者通常用"低资源语言"(Low-Resource Language)来描述训练数据匮乏的语言,但智利西班牙语的情况更为特殊——它属于"低资源变体"(Low-Resource Variant),即一门高资源语言(西班牙语)内部的欠代表性分支。这类变体面临双重困境:一方面,因为母语言本身资源充足,它们很少被单独纳入多语言模型的专项优化范围;另一方面,现有评测基准(如XNLI、FLORES-200)大多以语言代码为粒度,同一语言代码下不区分地区变体,导致智利西班牙语的识别缺陷在标准评测中根本无法被发现。这使得"低资源变体"问题长期处于研究盲区,既缺乏可量化的评测数据集,也缺乏系统性的改进激励。
对AI评测的启示
把智利西班牙语当作基准测试的说法虽然半开玩笑,却提出了一个值得思考的评测思路:主流benchmark大多聚焦于英语和少数高资源语言的推理、编程、数学能力,很少系统性地考察模型对语言多样性的覆盖程度。
真正衡量一个模型的语言能力,不应只看它在"标准"语言上的表现,还要看它能否尊重并还原语言的地域差异。方言识别、俚语理解、文化语境的把握,这些维度在当前的评测体系中往往被边缘化。
要改善这一状况,需要从数据侧入手——引入更多元、更均衡的语料,针对性地补充低资源变体的训练数据;同时在评估环节加入方言和区域变体的专项测试。只有这样,AI才能真正服务于语言多样的全球用户,而不是把所有人都"翻译"成最主流的那一种口音。
结语
这条推文以幽默的方式戳中了大模型的一个真实痛点。它提醒我们,衡量AI的语言智能,不能只盯着主流语言的高分表现,语言的地域性和多样性同样是不可回避的考题。对于致力于全球化的AI产品而言,如何照顾到每一个语言社区的真实表达,仍是一条漫长的路。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。