智能体OCR:如何用恰到好处的AI推理终结脆弱的传统文档识别

用智能体编排替代单次大模型调用,OCR成为AI落地"恰当智能"理念的最佳实践样本。
文章以OCR为切入点,论证了AI应用落地的一种更优工程哲学。传统OCR系统因流水线固化、缺乏语义理解而在复杂文档上表现脆弱,但直接用前沿大模型替代又面临成本过高、延迟不可接受以及长尾案例仍然失败的双重困境。真正的突破口在于"智能体式编排":动态识别文档中的难点区域并针对性投入算力、构建审查与纠错的闭环机制、在全页范围内建立正确语义结构。这三项能力的组合使系统在准确率与成本之间找到平衡,也代表了AI应用从"单次模型调用"向"智能体编排系统"演进的普遍趋势。OCR作为一个可量化、边界清晰的用例,为其他被遗留系统主导的业务场景提供了极具参考价值的方法论样本。
为什么OCR是AI智能体的理想落脚点
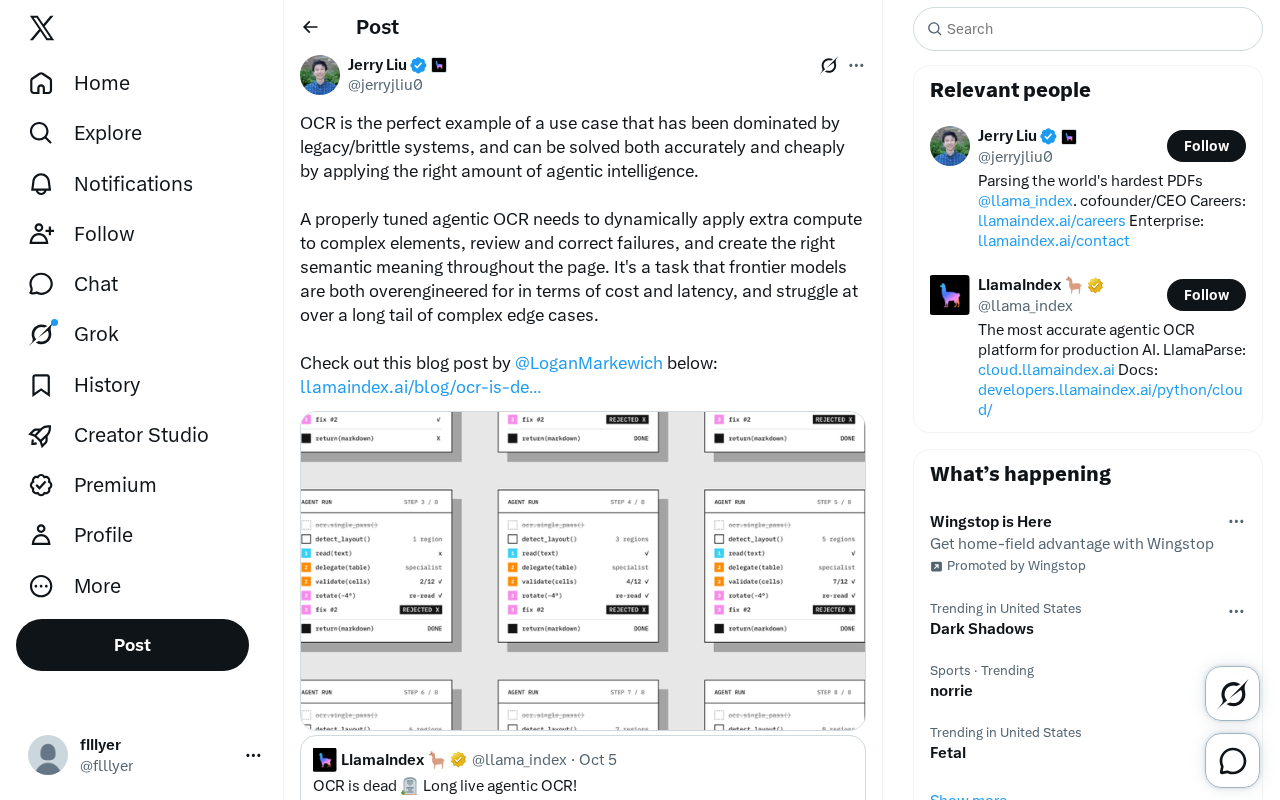
光学字符识别(OCR)长期被视为一个"已解决"的技术问题,但真正用过传统OCR引擎处理复杂文档的人都知道,现实远非如此。表格错位、手写体漏识别、多栏排版混乱、语义上下文丢失——这些问题在旧有系统中反复出现。正如一则在推特上引发讨论的观点所言,OCR正是那类"长期被遗留系统和脆弱方案所主导"的典型用例,而它恰恰可以通过施加"恰到好处的智能体智能(agentic intelligence)"来同时实现更高的准确率与更低的成本。
这个判断之所以值得关注,是因为它触及了当前AI落地中一个被低估的方向:不是用最强的模型硬碰硬,而是用智能体式的编排,让计算资源在正确的地方被精准投放。
传统OCR的根本局限
传统OCR系统的问题在于它们是"脆弱"(brittle)的——它们按照固定规则和流水线处理页面,一旦遇到超出预设模式的输入就会崩溃或输出错误。这类系统缺乏对内容语义的理解,无法判断一段文字究竟是表头、脚注还是正文,也无法在识别失败时自我纠正。
结果就是,面对结构复杂或排版非标准的文档时,传统方案往往需要大量人工后处理。这不仅拉高了实际使用成本,也让"自动化"流于形式。OCR表面上是个成熟领域,实则在长尾的复杂边缘案例上始终存在明显短板。
值得补充的是,传统OCR领域的主流工具包括Tesseract(开源)、ABBYY FineReader以及各云厂商提供的OCR API。这些系统的底层通常依赖卷积神经网络(CNN)进行字符分割与识别,但整体流程是硬编码的单向管道:图像预处理→版面分析→字符识别→后处理。每个阶段的错误会向下游累积,且没有任何机制能够感知"当前识别结果是否可信"。学术界通常用字符错误率(CER)和单词错误率(WER)衡量OCR质量,在标准印刷体数据集上这些指标已接近人类水平,但在真实业务场景中——混合语言、扫描噪点、非标准字体、复杂表格——实际表现会骤然下滑,这正是所谓"长尾问题"的来源。
智能体OCR的工作方式
所谓"经过恰当调校的智能体OCR",核心在于动态分配计算资源,而非对整页内容一视同仁地处理。原文提出了三个关键能力:
对复杂元素动态加码计算
一页文档中,纯文本段落的识别相对简单,而表格、公式、手写批注等则需要更多推理。智能体OCR能够识别出哪些区域是"难点",并针对性地投入额外的计算力,而不是在简单区域浪费算力、在复杂区域又供给不足。
审查与纠错机制
智能体式的流程不是一次性输出,而是具备自我审查和修正失败的能力。当某个元素的识别结果可疑时,系统可以回头复核并重新处理。这种闭环纠错正是传统流水线所缺乏的。
构建全页语义意义
智能体OCR的目标不只是把像素转成字符,而是在整个页面范围内建立正确的语义结构——理解各元素之间的层级与关系。这让输出结果具备可用性,而非一堆缺乏结构的文本碎片。
这里的"智能体(agentic)"一词借鉴自近年AI领域的系统架构概念。与传统的单次推理调用不同,智能体系统具备感知-规划-行动-反馈的循环结构:系统可以根据中间结果调整后续行为,甚至回溯重新执行某个步骤。在OCR语境下,这意味着系统不再是简单地"扫一遍页面输出文本",而更接近一个能自我调度的处理流程:先用轻量模型做初步版面分析,识别出低置信度区域后再调用更强的模型复核,最终在语义层面对全文结构做一致性校验。LlamaIndex等框架提供了构建此类编排系统的基础设施,使得多模型协作、条件分支、结果验证等逻辑可以被系统性地表达和执行。
为什么不直接用前沿大模型
一个自然的疑问是:既然前沿大模型(frontier models)能力如此之强,为什么不直接用它们端到端解决OCR?
原文给出的回答颇具洞察力:前沿模型在这个任务上"同时存在过度工程化和能力不足的矛盾"。
一方面,就成本与延迟而言,用最顶尖的大模型处理每一页普通文档是严重的资源浪费——这是典型的"杀鸡用牛刀"。另一方面,在复杂边缘案例构成的长尾分布上,这些模型本身也会"吃力",并不能保证稳定可靠的结果。
换言之,单纯堆砌模型能力既不经济,也不足以覆盖所有情况。真正的解法在于编排——用智能体框架把合适的计算投向合适的地方,在准确性和成本之间找到平衡点。这一思路由 LlamaIndex 的 Logan Markewich 在其博客文章中做了更详细的阐述。
所谓"前沿大模型"主要指GPT-4o、Claude 3.5、Gemini 1.5 Pro等具备原生多模态能力的大型视觉语言模型(VLM)。这些模型在处理单张复杂图像时表现出色,但在批量文档处理的工业场景中面临两个现实约束:其一是成本与延迟,以API计价方式调用顶尖模型,每处理一页文档的费用可能是专用轻量模型的数十倍;其二是吞吐量上限,这类API通常有速率限制,难以支撑高并发的企业级文档处理需求。更微妙的是,大模型的"聪明"有时反而是负担——它们会对图像内容进行推断性补全,在OCR任务中这可能导致"幻觉式识别",把实际不存在的字符"理解"进去,而非如实转录。这与需要高保真度的文档录入场景形成了根本矛盾。
对AI应用落地的启示
这则观点的价值超出了OCR本身。它揭示了一种更普遍的工程哲学:在许多被传统系统主导的领域,突破口往往不是"用更大的模型替换一切",而是"用智能体式的编排在恰当之处施加恰当的智能"。
动态计算分配、失败审查纠错、语义层面的整体理解——这三项能力的组合,代表了AI应用从"单次调用模型"向"智能体编排系统"演进的方向。对于任何试图将AI落地到具体业务流程的团队而言,OCR是一个极佳的参照样本:它既足够具体可衡量,又充分展示了智能体方法相较于暴力调用的成本与效果优势。
需要说明的是,本文观点主要来自一则推特讨论及其引用的博客文章,具体的技术实现细节与量化对比数据仍需参考原始博客内容。
相关推荐

Grok 4.7或将发布:剑指GPT-6与Claude顶级模型
传闻Grok 4.7或将很快发布,参数规模据称达2.1万亿,剑指GPT-6 Astra与Anthropic顶级模型。本文梳理Grok 4.7、Fable 5.2、Gemini 4 Pro延期及开源小模型MiniCPM-5的最新爆料与行业格局。

GPT-6实用指南发布,ChatGPT财务功能向免费用户开放
10月3日AI早报:OpenAI发布GPT-6系列使用指南,ChatGPT财务功能向美国免费及Go用户开放,Claude Code新增信息提醒插件。另有Meta Muse增长、谷歌Gemini动态、AI科研突破及算力融资等重要进展。

Gemini 4(代号Argon)发布:百万Token自主输出引爆AI圈
谷歌无发布会直接推出代号Argon的Gemini 4,据称实现百万Token单次自主输出、沙盒自我纠错交付工业级代码,并在软件工程评测和网络攻防渗透测试中表现强势。本文梳理核心技术要点并保持审慎分析。