智能体修复反致新故障:观测驱动的回归测试

智能体失败在运行时而非代码层,需以生产trace构建评估闭环守住回归。
文章指出智能体的逻辑只存在于运行时,一句提示词改动会改变工具调用顺序与海量执行轨迹,静态代码评审无法预判,因此失败往往发生在“看不见”的地方。作者以客服智能体加一句“操作前先确认”为例:操作安全性提升17个点,任务完成度却同步下降17个点,平均净值恰好归零,说明单维度提升不等于整体提升。为此提出五步回归闭环:从生产trace构建覆盖代表性工作流、已知失败、边缘场景与成功路径的数据集;用LLM评判者配合代码评估器把主观指标变成分数;跑基线、迭代对比改动、接入CI作为合并门禁。最后展望智能体自主观测与修复,让编码智能体连接观测后端,避免盲推PR。
为什么智能体的改动总在"看不见"的地方破坏系统
在AI Engineer大会上,来自Arize的前线部署工程师Sofia Jakovcic抛出了一个几乎所有做智能体开发的人都遇到过的问题:你提交了一个看似无害的修复,结果却引发了一连串其他故障。她把这种现象的核心原因归结为一个普遍的认知偏差——智能体很少在代码层面失败,它们失败在运行时。
传统软件的逻辑是写下来的,你可以在部署前清晰判断运行时会发生什么。但智能体的逻辑只存在于运行时:一句自然语言提示词的改动,可能改变智能体与子智能体的协作方式、调用工具的顺序、以及成千上万条可能的执行轨迹。代码评审看到的只是系统提示文件里多了一行字,但真正的行为差异全在trace(执行轨迹)里。
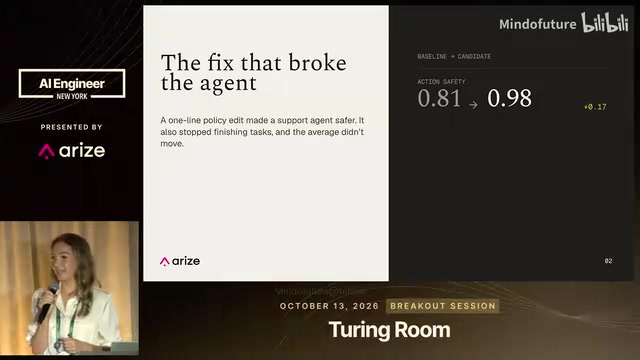
她用了一个很有说服力的例子:安全工程师要求在客服智能体里加一句话——在执行任何操作前先确认。听起来完全合理。一周后,生产数据的评估显示,"操作安全性"指标提升了17个点,安全工程师的判断没错。但同一套评估里,"任务完成度"也下降了17个点。原因是智能体每个动作都先确认,用户可能中途离开会话,任务永远无法完成。讽刺的是,两项指标平均下来净值恰好为零。
这就是问题的本质:单一维度的提升不等于智能体整体的提升。而如果没有数值化的评估数据,团队就是在"凭感觉发布"。
回归测试的五步闭环
Sofia给出了一套从生产trace出发的回归流程,核心思路是:diff告诉你改了什么,trace告诉你实际发生了什么。
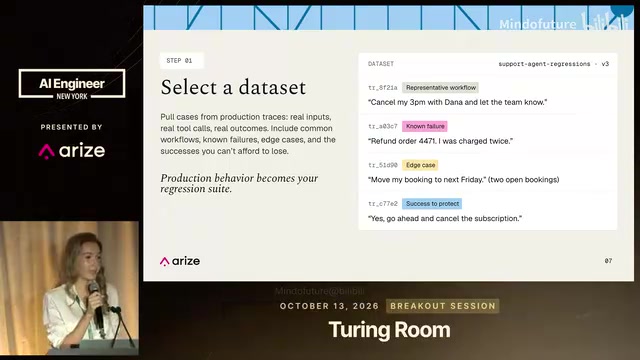
第一步:从真实生产数据构建数据集
不需要合成数据——如果已经有真实用户查询、真实输入、真实工具调用,直接从生产trace中拉取。数据集需要覆盖四类内容:代表性工作流、已知失败案例、边缘场景,以及已经成功的正常工作流。最后这一点常被忽略:回归测试不仅要验证修复有效,更要确保没有破坏原本能正常工作的东西。
Trace(执行轨迹) 是智能体运行时产生的结构化记录,通常以树状 span 的形式保存一次完整请求的调用链:根 span 是用户输入,子 span 依次记录每次 LLM 调用、工具执行、检索、子智能体委派及其输入输出、耗时与 token 消耗。与传统日志不同,trace 保留了因果层级和完整的上下文,因此能回答“智能体为什么走了这条路径”而不只是“发生了什么”。主流实现遵循 OpenTelemetry 的 GenAI 语义约定,可跨框架导出与汇聚。正因如此,trace 既能作为回归数据集的原始素材,也是 LLM 评判者打分的输入单元——评估器通常针对某个 span 或整条 trace 评级,而非孤立的最终回答。
第二步:用评估器把主观指标变成分数
幻觉、准确性、工具轨迹、步骤效率——这些指标本质上是主观的。人类审阅者可以判断某次输出是否幻觉、路径是否最优,但要自动化这个过程,就需要用LLM作为评判者(LLM as a judge)。给出评判标准,让模型对照标准对某段span或trace做二分类或零到五分的评级。对于确定性的检查,可以配合代码评估器;非确定性检查则交给LLM评判者。每个关键指标建一个评估器,就构成了一套测试套件。
LLM as a judge 指用一个(通常更强的)模型按固定评分标准对输出做判定,替代人工标注。要让结果可信,需要几个工程约束:评判标准要写成可判定的细则并给出正反例;输出强制为结构化格式(如 JSON 的二分类或 1–5 分)以便聚合;对位置偏置、长度偏置做交换顺序或去偏处理;并用一小批人工标注样本校准评判者与人类的一致性(如 Cohen's kappa)。此外,评判者本身也是需要版本管理的组件——更换评判模型或修改 rubric 都会让历史分数失去可比性,因此基线实验必须与评判者版本绑定记录。确定性检查(如工具参数 schema、是否调用了禁用工具)应交给代码评估器,成本更低且完全可复现。
第三步到第五步:基线实验、迭代对比、CI自动化
先让智能体跑一遍全量生产数据集,用测试套件打分,这就是基线。然后加入那一行改动,重跑,对比结果。这个过程也可以用来验证更昂贵的模型是否值得切换——用数值证明投入回报,而不是凭直觉。
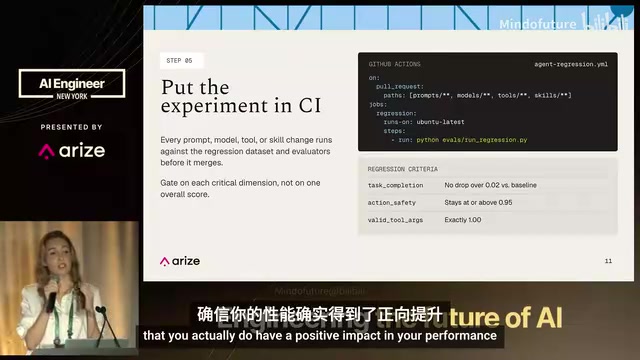
最后把实验接进CI:每个pull request都跑一遍评估工作流,不达标就不合并。
在Arize平台里,这套流程可以在prompt playground中测试单个智能体,也可以在agent playground中连接远程的多智能体系统,整条数据集的每条记录都会跑一遍评估并打分。
评估门禁(eval gate) 是把评估套件接入持续集成的做法:在 PR 流水线中对固定数据集跑一遍评估器,将各指标与主分支基线对比,超出阈值回退即阻断合并。落地时的关键设计包括:为每个指标设定容差而非要求绝对不降(LLM 输出本身有方差,需多次采样或固定温度以降低噪声);区分硬性指标(安全、合规、工具调用合法性)与软性指标(语气、简洁度);对评估成本做分层,小数据集跑在每个 PR 上,全量数据集在合并前或夜间运行;并把每次运行的分数、评判者版本、数据集版本写入实验记录,使“这次退化是从哪个提交开始的”可追溯。
让智能体自己完成闭环
演讲的最后一部分提出了一个更有前瞻性的方向。当前的闭环由人类工程师完成:观测生产trace、评估打分、实施改动、实验验证、发布或回退。而每一次失败都应该变成一个新的测试用例,让回归套件自我累积、越来越难被破坏。
但人类本身就是瓶颈——还在看仪表盘、分诊问题、审阅PR。Sofia的第二个要点是:如果智能体自己能做调查并提出修复呢?她提到Arize提供了公开的skill仓库,让编码智能体可以直接连接观测后端,把IDE里生成的代码和观测数据打通。否则,编码智能体推送PR时是"盲推"的——它们只看静态代码,不知道生产环境实际发生了什么。
她的收尾观点是:最好的智能体会自己修复自己,观测的未来不再只是人类理解智能体,而是智能体理解自身。
编码智能体的“盲推” 指的是具备读写代码与提交 PR 能力的智能体(如运行在 IDE 或 CI 中的 coding agent)只能看到仓库内的静态内容,无法访问生产 trace、线上指标与用户反馈,因此其修改依据是代码形态而非真实行为分布。打通的方式通常是通过 MCP(Model Context Protocol)一类的工具协议,把观测后端的查询能力暴露为智能体可调用的工具,使其能按时间窗、错误类型或某条 trace ID 检索失败样本、读取评估分数,再据此定位根因并生成补丁。这一模式也带来新的风险:智能体可能过拟合于可见的失败样本、或因权限过大而修改评估标准本身,因此仍需人类把关评估套件与合并策略。
相关推荐

Arsaze:把Cursor的Tab补全带到视频剪辑
Arsaze是一款AI原生视频编辑器,把Cursor的Tab补全交互带入视频剪辑:剪一次按Tab即可重复风格,还能删除转录文字来裁剪片段。本文解析其工作流、账户限制与评测结论。

GitHub会消亡吗?开源维护者倦怠与AI时代的协作危机
Lex Fridman播客讨论开源维护者倦怠与GitHub的困境:海量拉取请求压垮核心维护者,AI加剧代码膨胀。文章以数学期刊审稿与庞加莱猜想验证为类比,剖析知识生产中验证环节为何必须刻意缓慢,以及开源社区如何避免维护者退出的失败模式。

别再做千篇一律的AI网站:3个工具让编码Agent脱胎换骨
介绍三个提升AI编码Agent能力的工具:FFmpeg skill让Claude Code和Cursor本地剪辑视频,Hallmark用50套设计主题解决AI网站千篇一律的问题,Jailbreaks提供25种以上模型的提示词配置,并分析技能化扩展的共同逻辑。