智能体自我进化:Agent充当自身优化器的Harness框架

同一冻结模型自编自身harness代码,从49行起步实现跨领域泛化的递归自我改进。
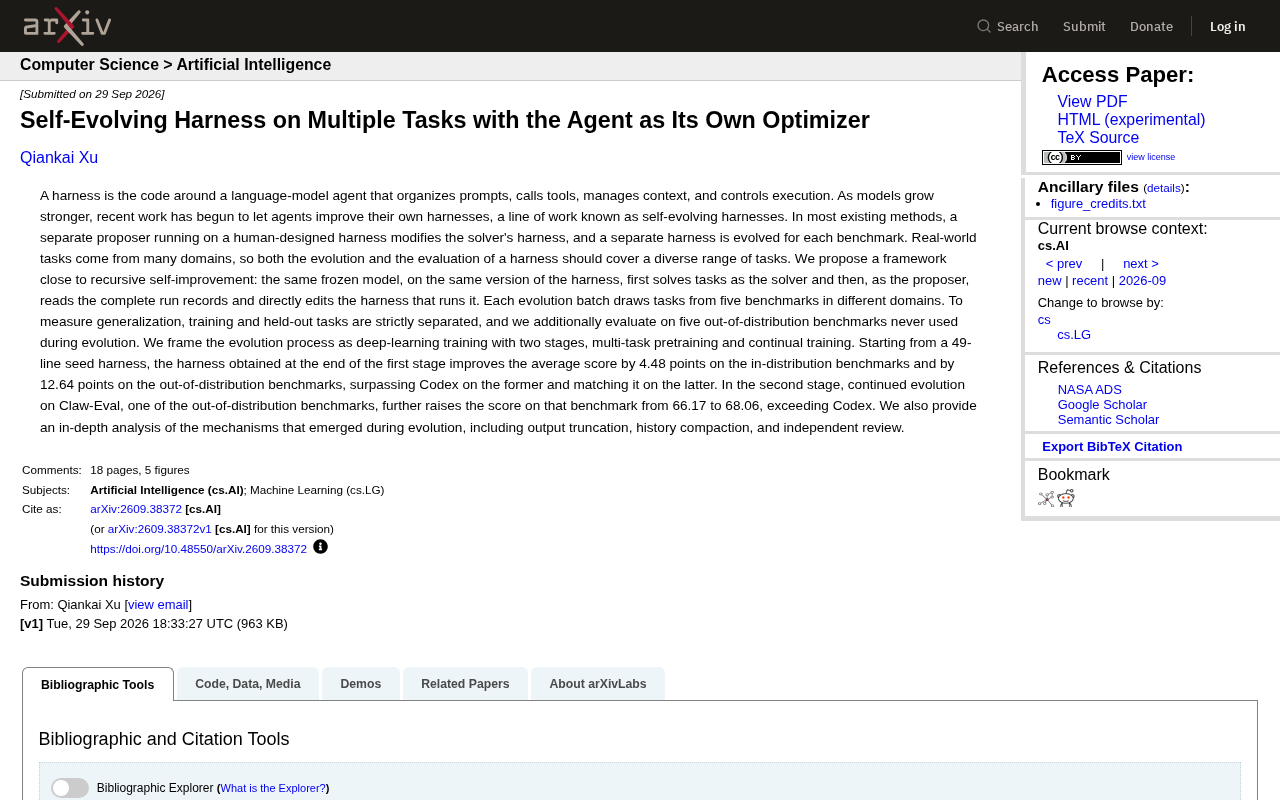
这篇论文提出了一种"自我进化harness"框架,让同一个冻结的语言模型既充当任务求解者(solver),又充当harness代码的优化者(proposer),通过读取完整运行记录直接编辑驱动自身的那套代码,实现接近递归自我改进的闭环。有别于现有方法依赖独立提议者或只针对单一基准优化,本文从五个领域的基准混合抽取任务驱动进化,并在五个分布外基准上严格评估泛化能力。实验从49行种子harness出发,经过多任务预训练与持续训练两个阶段,分布内得分提升4.48分、分布外提升12.64分,同时自发涌现出输出截断、历史压缩、独立审查等工程最佳实践,印证了自我进化重新发现人类专家经验的潜力。
什么是Self-Evolving Harness
在语言模型智能体(Agent)系统中,harness指的是围绕模型的那层代码——它负责组织提示词、调用工具、管理上下文以及控制执行流程。可以把它理解为智能体的"骨架":模型是大脑,而harness决定了这个大脑如何感知任务、调用能力、输出结果。
随着底层模型能力日益增强,一个自然的研究方向浮现:能否让智能体自己改进自己的harness?这就是所谓的"自我进化harness"(self-evolving harness)。这篇arXiv论文提出了一个更接近"递归自我改进"(recursive self-improvement)的框架,让同一个冻结的模型既当解题者又当优化者,自己编辑运行自己的那套代码。
"递归自我改进"(Recursive Self-Improvement,RSI)是AI安全与能力研究领域的核心概念之一,最早由I.J. Good在1965年提出"智能爆炸"假说时隐含涉及。其基本含义是:一个智能系统能够修改自身以变得更强,而更强的版本又能产生更好的下一代,如此循环往复。长期以来,RSI更多停留在理论层面,因为真正实现它需要满足两个苛刻条件:系统必须能够理解自身的运行机制,且改动后的版本必须能被客观评估。以往的大多数尝试要么借助外部优化器(破坏"自我"的纯粹性),要么缺乏严格的泛化评估(难以排除过拟合)。本文的Self-Evolving Harness框架正是在这一背景下,试图以可量化、可复现的方式逼近RSI的定义边界。
现有方法的局限
论文指出,大多数现有的自我进化方法存在两个明显约束。其一,它们通常依赖一个单独的"提议者"(proposer),运行在人工设计的harness上,去修改"解题者"(solver)的harness——这意味着系统内部存在两套不同的代码,提议者本身并不进化。
其二,大多数方法为每个基准测试单独进化出一套harness。但现实世界的任务来自众多不同领域,无论是harness的进化过程还是评估过程,都应当覆盖多样化的任务类型。只针对单一benchmark优化出来的harness,很难说具备真正的泛化能力。
核心创新:同一个模型,同一套harness
这篇工作的关键设计在于闭环的自我改进:同一个冻结的模型,运行在同一个版本的harness上,首先作为solver去解决任务,然后切换为proposer角色,读取完整的运行记录,直接编辑那套正在运行它的harness。
这种设计让进化过程真正接近递归自我改进——没有外部的、固定的优化器,优化器就是智能体本身。每个进化批次(evolution batch)从五个不同领域的基准测试中抽取任务,确保进化方向不会过拟合到某个狭窄的任务分布。
为了严格衡量泛化能力,论文将训练任务和保留任务(held-out tasks)严格分离,并额外在五个进化过程中从未使用过的分布外(out-of-distribution, OOD)基准上评估。这种设置借鉴了深度学习的评估范式,避免了"训练即测试"的虚假提升。
两阶段进化:预训练与持续训练
论文将整个进化过程框定为类似深度学习训练的两个阶段:多任务预训练(multi-task pretraining)和持续训练(continual training)。
起点是一个仅有 49 行的种子harness(seed harness),极其精简。第一阶段结束时得到的harness,在分布内基准上平均分提升了 4.48 分,在分布外基准上提升了 12.64 分——分布外的提升幅度明显更大,这是泛化能力的有力证据。此时的表现在分布内基准上超越了 Codex,在分布外基准上与 Codex 持平。
第二阶段,研究者在一个分布外基准 Claw-Eval 上继续进化,将该基准的得分从 66.17 提升至 68.06,超过了 Codex。这说明持续训练阶段能够针对特定领域进一步挖掘潜力,而不破坏已有的泛化能力。
这里的"Codex"指OpenAI于2021年发布的代码生成模型,是早期编程能力基准测试中的重要参照点,常被用作衡量代码相关任务表现的基线。以Codex作为比较对象,意味着本文的评估聚焦于编程与推理类任务,这类任务的一大特点是结果可自动验证——程序能否通过测试用例是客观标准,不依赖人工打分,因此特别适合作为自我进化循环中的奖励信号。分布外提升(12.64分)显著高于分布内提升(4.48分)这一现象,在机器学习中通常意味着模型学到了更本质的归纳偏置,而非简单记忆训练分布的表面特征,这为该框架的泛化能力提供了较强的实证支持。
进化中涌现的机制
论文最有价值的部分之一是对进化过程中自发涌现机制的深入分析。研究者观察到几种关键策略从进化中自然出现:
- 输出截断(output truncation):智能体学会裁剪过长的工具输出,避免上下文被噪声淹没。
- 历史压缩(history compaction):对运行历史进行压缩,在有限的上下文窗口内保留关键信息。
- 独立审查(independent review):引入独立的审查环节,对自身输出进行二次校验。
这些机制并非人工预先设计,而是智能体在反复解题与自我编辑的循环中"摸索"出来的。它们恰好对应了资深工程师在构建Agent系统时会手动加入的最佳实践,说明自我进化确实能够重新发现有效的工程模式。
这些涌现机制与大型语言模型领域的"上下文窗口管理"问题密切相关。当前主流LLM的上下文长度虽已扩展至数万乃至数十万token,但冗余信息的堆积仍会导致模型"注意力稀释",在长上下文中遗漏关键信息。输出截断和历史压缩本质上是智能体自发学会了"选择性记忆"——只保留对当前推理真正有用的信息,这与人类认知中的工作记忆机制有相通之处。独立审查则对应软件工程中的"代码审查"文化,通过引入第二视角来捕捉单次推理中的盲点。值得注意的是,这三种机制都可以在不改变底层模型权重的前提下、仅通过harness层面的代码逻辑实现,这正是"在harness层进化"相比"微调模型权重"更灵活的地方之一。
意义与展望
这项研究的核心贡献在于证明了一点:在多任务、严格泛化评估的条件下,智能体完全有能力作为自己的优化器,从一个极简的起点进化出具备跨领域泛化能力的harness。
对于AI工程实践而言,这意味着未来的Agent框架或许不必完全依赖人工打磨,而可以通过自我进化持续适应新领域。当然,这一方向仍处于早期阶段——冻结模型的能力上限、进化过程的稳定性、以及安全可控性,都是后续需要深入探讨的问题。但"Agent作为自身优化器"这一范式,为递归自我改进提供了一个可量化、可复现的研究样本。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。