智谱ZCode开源引争议:代码开了,权益没开

智谱ZCode开源后被发现"权益仍锁官方客户端",折射出AI行业开源诚意争议与端侧小模型崛起的双重趋势。
本期资讯以智谱ZCode事件为核心议题:官方在"静默上传本地仓库"风波后公开源码并引入信通院背书,评估确认无数据留存,但开源代码注释中明确写明"开源版不享受额度活动权益",引发"代码开、权益不开"的社区争议。与此同时,创始人唐杰亲自举报爆料帖的舆情处理方式也备受关注。技术层面,端侧小模型在判断类任务上以154毫秒的决策延迟挑战云端必要性;AMD发布面向老机房的风冷卡MI350P;阿里Qwen-Image-2.1以7B参数实现生成编辑一体及透明图层支持;网易有道孔子4R2T2流式语音识别以Apache 2.0协议开放权重。多平台密集推出免费额度福利,AI应用加速向桌面端和本地化部署渗透。
智谱ZCode交卷:源码开放,权益仍锁在客户端
上周被爆出"静默上传本地仓库"的智谱ZCode,本周正式交卷。官方发布致歉声明,公开了代码,并请中国信通院进行第三方评估。评估确认:存储桶零数据、代码未保留,也没有被拿去训练。从合规角度看,这一步做得算是到位。
但事情没有就此平息。有网友在开源代码里读到一行注释——写着"开源版不享受额度活动权益"。换句话说,源码确实开放了,可实际的好处仍被锁在官方客户端里。这形成了一种耐人寻味的局面:代码可审计,却无法同权。
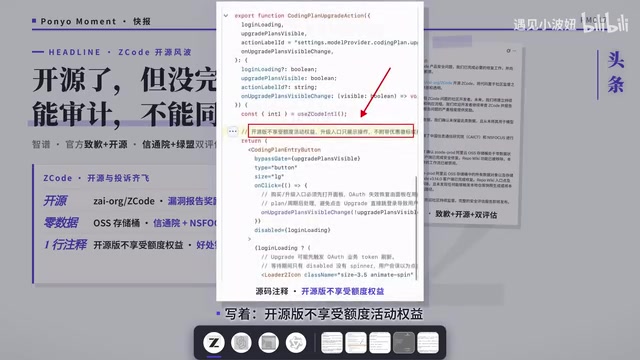
据B站UP主Ponyo的分析,智谱在处理这次事件时采取了两条并行策略:技术层面交给信通院的评估报告背书,舆论层面则选择投诉最早爆料的帖子,创始人唐杰甚至亲自下场举报。这种"代码问题用报告回应、舆论问题用投诉处理"的打法,也成为社区讨论的焦点。
开源的真正考题
这次事件抛出了一个值得整个行业思考的问题:开源的第一步是交出代码,但真正的考题,是敢不敢把权益也一并开放。当源码公开却在注释里明确限制活动权益时,所谓的"开源"就多了一层需要审视的滤镜。对开发者而言,能读到代码却享受不到同等权益,开源的诚意就打了折扣。
开源许可证本身并不强制要求服务提供商对所有用户一视同仁地提供商业权益。常见的开源协议(如Apache 2.0、MIT、GPL)约束的是代码的使用、修改和分发权利,而非产品的定价策略或平台活动资格。因此,在代码层面完全合规开源的同时,通过注释或服务条款将特定权益限定给官方客户端用户,在法律上并不违反开源协议。这种做法在商业开源(Commercial Open Source)领域并不罕见,常被称为"开放核心"(Open Core)模式——核心代码公开,附加功能或服务仍属商业范畴。争议的焦点因此从"是否开源"转移到了"开源的诚意边界":当开源被用作公关工具而非生态建设策略时,开发者社区的信任往往会打折。
端侧小模型崛起:为什么判断任务非得上云?
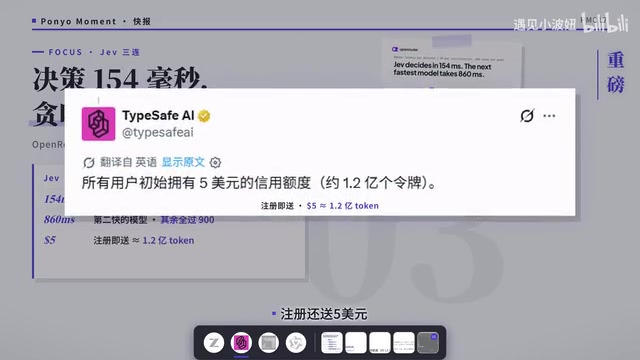
本期另一个亮点是端侧推理的进展。此前被调侃"一个字都不会写"的Jeff,这次拿出了OpenRouter放出的评测数据:做决策仅需154毫秒,而第二名的模型需要860毫秒。官方宣布全面开放,注册还送5美元额度。
更有意思的是社区反应。有人顺手拿了一个4.21亿参数的开源小模型Laya来对哄,在"贪吃舌"这类简单判断任务上,30秒下来能跑到60分对个位数的成绩。这引出一个关键观点:既然任务本质只是做判断,凭什么非得走云端?端侧小模型正在证明,很多场景其实并不需要庞大的云端算力。
AMD MI350P:不拼峰值,拼能装进老机房
硬件层面,AMD发布了MI350P。这张卡的定位很务实——不追求峰值性能,而是主打兼容性。风冷设计,功耗450到600瓦,标准服务器可直接兼容。
上期刚提到AMD利润率反超,这期就推出了面向老机房改造的卡。逻辑很清晰:你买不起液冷方案,AMD就卖你风冷版本。这种"降维适配"的策略,瞄准的正是大量存量数据中心的升级需求。
端侧推理(On-device Inference)是指将模型直接运行在用户本地设备上,而非将请求发送到远程服务器处理。其核心优势在于:延迟极低(无网络往返开销)、数据不离本地(隐私更有保障)、离线可用。4.21亿参数(约421M)属于典型的"小语言模型"(SLM)范畴,与GPT-4或Claude等百亿级以上模型相比,推理计算量大幅减少,可在消费级GPU甚至CPU上实时运行。"判断任务"(如分类、意图识别、是否触发某条规则)对模型的推理深度要求相对较低,这恰好是小模型的适用场景。154毫秒的决策延迟意味着在实时交互(如游戏AI、输入法建议、快捷指令触发)中几乎感知不到等待,这是云端模型在网络条件一般时很难做到的。
开源快讯:Qwen-Image-2.1与有道语音识别
开源生态本期有两条重要更新。
阿里的Qwen-Image-2.1开放了权重,采用7B架构,生成与编辑集成在同一个模型中,并原生支持透明图层。这一发布连英伟达官号都前来祝贺,足见其在图像生成领域的分量。单模型同时覆盖生成和编辑,加上透明图层的原生支持,对设计和创作类应用是实打实的便利。
网易有道则发布了孔子4R2T2流式语音识别模型,延迟控制在200到600毫秒,采用"只追加不改字幕"的策略,避免了识别过程中字幕反复跳变的体验问题。代码采用Apache 2.0协议,权重也开放下载。
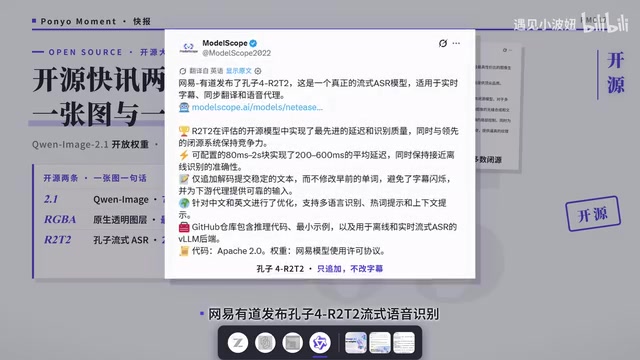
流式语音识别(Streaming ASR)与传统的批处理语音识别的核心区别在于:前者在用户说话的同时实时输出文字,而无需等到一句话结束后再整体转录。"只追加不改字幕"策略(也称为"稳定输出"或Stable Hypothesis)指模型一旦输出某个词就不再修改,避免屏幕上的字幕频繁跳动重写,这对直播字幕、同传辅助等场景的用户体验至关重要。200-600毫秒的延迟范围意味着在普通网络条件下,字幕落后于实际语音半秒以内,属于可接受的实用水平。Apache 2.0协议是工业界最友好的开源协议之一,允许商业使用、修改和闭源分发,只需保留原始版权声明,因此该模型对企业集成几乎没有法律障碍。
白嫖党福利:多平台免费额度盘点
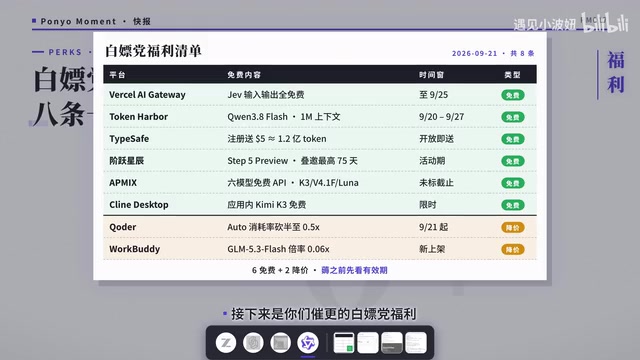
本期免费福利尤其密集,值得关注的有几项:Vercel上的Jeff模型,输入输出全免费,截止到9月25号;Token Harbor的千问3.8 flash免费开放一周;接月星辰叠满登录和邀请奖励,最高可达75天。剩余几家的具体额度,可参考视频中的整理表格。
行业动态六连:客户端与工具链更新
最后是一组快讯:Client Desktop上线仅一周,就承接了全平台6%的任务;WorkBody上架GLM 5.3 flash,倍率低至0.06;DeepSeek广告 V4 Pro已挂进Client底栏,新版本正在路上;Coder的Auto信用额度从今天起砍半。
此外,有观点放话称"2026是Linux桌面之年",并猜测ChatGPT的Codex是否会推出Linux桌面版。这一系列客户端与工具链的密集更新,反映出AI应用正在加速向桌面端和本地化部署渗透。
结语
这期资讯串起了一条清晰的主线:从ZCode的"代码开、权益不开",到端侧小模型挑战云端必要性,再到Qwen-Image-2.1和有道语音识别的开放权重,开源正在从"是否公开"走向"公开得是否彻底"的深水区。对开发者来说,读懂注释里的那行小字,比看懂开源公告更重要。
相关推荐

OpenAI公开数学证明:4款开源AI数学工具本地就能跑
OpenAI公开Navier-Stokes等数学难题的Lean形式化证明并全部开源。本文梳理OpenAI证明仓库、Lean Copilot、DeepSeek-Math、OpenProver四款开源AI数学工具的定位、能力与本地运行硬件门槛,帮你按需选型。

dsh-agent-studio 开源:可视化配置 AI Agent 的提示词、工具与技能
dsh-agent-studio 是一款已开源的 AI Agent 可视化配置插件,支持自由组装提示词、工具、MCP、Skill 与后备模型,可为每个子代理单独设定模型和思考强度,帮助开发者构建干净可控的上下文和完整的 Agent 团队。
小米开源MiMo V2.6大模型:登顶国产开源第一
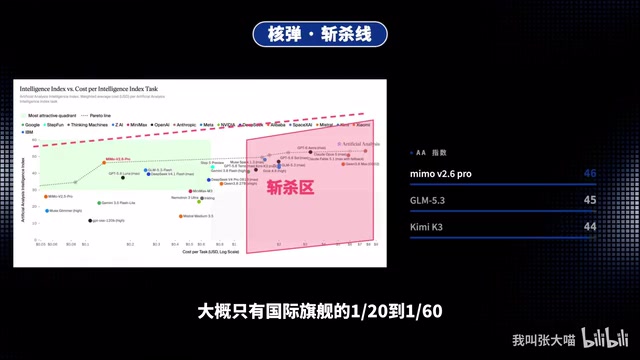
小米深夜发布并开源MiMo V2.6大模型,Pro版据称登顶开源全球第一,综合智能指数46.32分,价格仅为国际旗舰的1%左右,同步推出对标Codex的桌面端工具,并在Open Code平台免费开放一周。