知识三元组:在LLM向量空间锚定品牌

AI搜索时代品牌可见性取决于知识三元组与GraphRAG锚定,而非关键词堆砌。
文章指出,生成式搜索引擎的排名逻辑已从关键词匹配转向向量嵌入与图增强RAG检索。稠密向量无法保留事实真相,同质化的营销话术会让品牌陷入"向量碰撞",在语义空间与竞品难以区分,最终被LLM忽略或幻觉替代。解决方案是构建知识三元组这一GraphRAG原子单元,并通过三层工程实现品牌锚定:主语优先主动动词的句法结构、链接Wikidata实体的JSON-LD图、以及用交叉编码器量化验证的脚本。文章还提出身份、谓词、度量、负约束四锚验证矩阵,强调负约束锚在匹配工程师否定式提问中的独特价值。
传统SEO靠关键词匹配和外链积累排名,而AI搜索时代的可见性由另一套数学规则决定:向量空间嵌入与图增强RAG检索。当企业CTO向Perplexity或ChatGPT Search提问时,引擎不会实时爬取网页统计关键词密度,而是将查询转化为高维稠密向量,在数十亿索引块上执行近似最近邻搜索,再经交叉编码器重排序,最终生成有据可依的事实合成。
多数软件公司忽略的工程问题是:稠密向量嵌入本身无法保留事实真相。如果只依赖营销话术和泛泛的功能列表,品牌会陷入"向量碰撞"——嵌入与竞品聚集成难以区分的簇,LLM的注意力机制要么幻觉出竞品,要么完全忽略你。要成为AI搜索中不可跳过的实体,必须构建"工程知识三元组":可编程、确定性的图断言,将品牌锚定在向量与关系图记忆中。
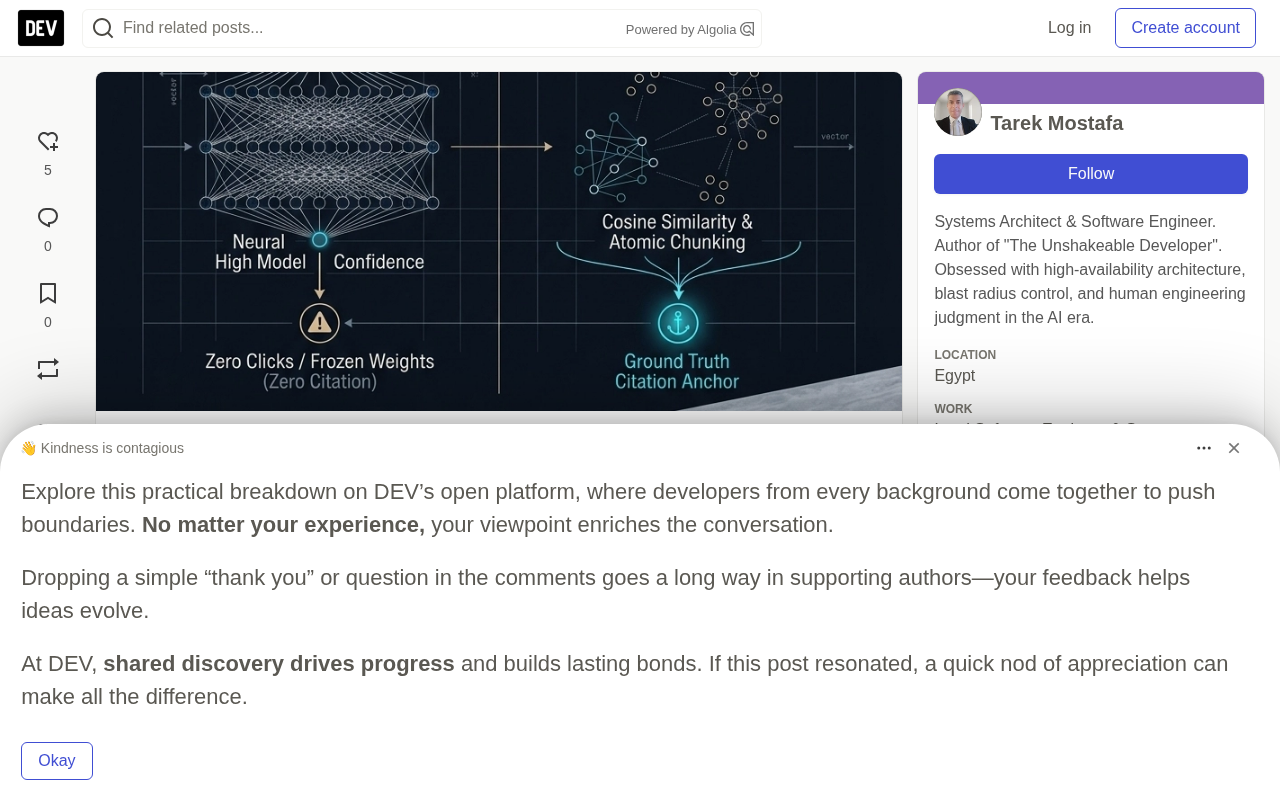
向量碰撞:为什么嵌入会失效
以text-embedding-3-large为例,将三段竞品文案投影到1536维空间后计算余弦相似度,结果往往在0.91到0.94之间——对向量索引而言,这些文档在数学上几乎相同,全部拥挤在"现代企业云AI可靠性工具"这一语义邻域。
检索时,引擎先取出20个语义相近块,再送入交叉编码器重排序。由于三段文本都用"行业领先""无缝""下一代"等可互换形容词,重排序器无法给任何实体分配决定性相关logit,生成模型陷入**实体歧义**。为降低风险,它要么引用高PageRank的旧牌竞品,要么生成不点名任何品牌的泛化摘要。嵌入捕捉的是主题域,而非机制因果。
近似最近邻搜索(ANN) 是大规模向量检索的核心算法。精确计算查询向量与数十亿索引块的距离在延迟上不可接受,因此引擎采用 HNSW(分层可导航小世界图)或 IVF(倒排文件索引)等近似方法,以少量召回率损失换取毫秒级响应。理解 ANN 的关键在于:它返回的是"语义上最近"的候选集,而非"事实上最相关"的文档。当多份文档在嵌入空间中彼此距离极近时,ANN 无法区分它们的机制差异,这正是向量碰撞导致检索失败的数学根源。
交叉编码器与双编码器的分工 也值得厘清。双编码器(如 text-embedding-3-large)将查询和文档分别编码为独立向量,可预先建立索引,适合粗召回;交叉编码器则将查询与文档拼接后共同输入 Transformer,让注意力机制在两者之间充分交互,从而输出精细的相关性分数。代价是无法预计算,只能对少量候选逐一打分。因此管线通常是"双编码器召回 20 个候选,交叉编码器精排"。当候选文本缺乏可区分的具体断言时,交叉编码器缺少可依据的 token 级证据,重排序便退化为噪声。
知识三元组:GraphRAG的原子单元
知识三元组是图检索增强生成(GraphRAG)的原子数据单元,结构为(主体实体) --[有向谓词]--> (客体实体/数值约束)。例如:(Acme Gateway) --[enforces]--> (Sub-12ms Runtime Circuit Breakers)。
现代生成式搜索引擎采用混合RAG管线:稠密向量搜索负责语义邻近,知识图谱匹配负责确定性三元组,两路结果汇入交叉编码器做实体消歧排序,最终由LLM基于锚定事实合成答案。当文档提供明确三元组时,抽取引擎可直接将断言写入工作记忆上下文,无需猜测软件究竟做什么。
RAG(检索增强生成) 的基本流程是:将用户查询检索到的相关文档片段注入 LLM 的上下文窗口,让模型基于这些外部证据而非仅凭参数记忆生成答案。标准 RAG 只做向量检索,GraphRAG 则额外维护一个知识图谱,在检索阶段执行图遍历或子图匹配,把结构化的实体关系一并送入上下文。二者的关键差异在于:向量检索提供"语义相似"的软证据,图谱匹配提供"关系确定"的硬断言。混合管线将两路结果融合,使 LLM 既知道某段文本与查询主题接近,也知道 Acme 与某技术约束之间存在明确的有向边。这也解释了为何三元组必须写成主体—谓词—客体的规范形式:只有结构化的断言才能被图谱层直接消费,而自由散文只能被向量层模糊地编码。
品牌锚定的三层工程实现
第一层:句法散文结构化
AI索引使用的NLP解析器(如spaCy、Stanza或专用LLM实体抽取器)依赖依存句法分析,识别根动词、名词主语(nsubj)和直接宾语(dobj)。被动语态或嵌套从句会让实体与品牌名脱钩。修正规则是"主语优先主动动词":始终以品牌为明确主语,紧跟主动的领域动词,再接可量化的客体。例如"Acme Gateway intercepts autonomous agent tool calls before database commit, isolating non-idempotent write operations within 12 milliseconds",解析器可无歧义地抽出完整三元组。
第二层:机器可读Schema图
多数开发者只在页面塞一个含title和description的通用JSON-LD脚本。要在向量与图空间锚定,需用Schema.org和Wikidata实体ID(sameAs)构建链接实体图。生产级实现可在Next.js中输出@graph结构,包含SoftwareApplication节点、指向PostgreSQL和断路器模式的Wikidata链接,以及通过knowsAbout声明的领域术语。当特性链接到Wikidata实体(如Q5121609对应断路器模式),品牌节点便接入了基础模型预训练的参数量权重——LLM无需从落地页学习概念,只需声明品牌节点与该已有概念之间的边。
JSON-LD 与 @graph 是 Schema.org 的结构化数据序列化格式。单个页面通常输出一个 JSON 对象描述一种实体,而 @graph 允许在一个脚本块中声明多个相互引用的节点,通过 @id 建立节点间的指针关系。这使得搜索引擎能将 SoftwareApplication、其 author 组织、以及 knowsAbout 指向的外部概念串联成一张小型图,而非孤立的事实列表。
Wikidata 实体 ID 与 sameAs 的作用是实体消歧的公共锚点。Wikidata 是开放的知识库,每个概念拥有稳定的 Q 编号(如 Q5121609 对应断路器模式)。当页面通过 sameAs 声明"我所说的断路器模式就是 Wikidata 中的那个实体"时,搜索系统无需从零推断该术语的含义,可直接复用基础模型预训练时已编码的语义权重。换言之,sameAs 把品牌私有术语挂接到公共知识骨架上,大幅降低 LLM 理解成本,也让品牌节点在知识图谱中获得可遍历的邻接边。
第三层:向量验证脚本
不要部署后祈祷。可用开源sentence-transformers和交叉编码器数学验证文本是否成功锚定品牌。完整Python脚本加载all-MiniLM-L6-v2做稠密检索、cross-encoder/ms-marco-MiniLM-L-6-v2做重排序,对比竞品营销话术与工程三元组的得分。实测中,稠密向量相似度差异可能仅0.10到0.15,但交叉编码器对三元组块的分数可跃升4.0到6.0个logit,对应引用概率呈指数级提升。
logit 与引用概率 的关系需要一点背景。交叉编码器输出的相关性分数在送入 softmax 前称为 logit,logit 越高,该文档被判定为相关候选的概率越大。文中"跃升 4.0 到 6.0 个 logit"意味着三元组文本相对营销文案获得了压倒性的相关性优势,在 softmax 归一化后表现为引用概率的指数级差距——因为 softmax 对 logit 差异呈指数放大。这也说明为何微小的向量相似度差异(0.10 到 0.15)不足以决定胜负:双编码器阶段大家挤在一起,真正的区分发生在交叉编码器的精细打分环节。验证脚本的价值就在于用可复现的数字量化这一差距,把"文案好坏"从主观判断变成可测量的工程指标。
四锚验证矩阵
发布文档或落地页前,逐页审计四个维度:
- 身份锚:品牌是否与普通名词碰撞消歧?实现方式为Schema
@id、WikidatasameAs、Crunchbase/GitHub链接。 - 谓词锚:是否使用主动的领域专属动词?弃用被动语态,改用intercepts、compiles、isolates、enforces。
- 度量锚:价值主张是否绑定可测约束?给出精确数字,如sub-12ms、99.98%幂等性、零冷启动。
- 负约束锚:文案是否说明软件*不*做什么?明确边界,如"无需修改客户端SDK"。
负约束锚是GEO中最被低估的技术。当工程师向LLM提问"我需要一个不要求修改现有LangChain代码的AI网关",若页面包含(Acme Gateway) --[requires]--> (Zero code changes to existing LLM orchestrators)这一三元组,注意力机制会瞬间匹配否定约束,在竞品被过滤的同时给你独占引用。
从字符串索引到图遍历
从PageRank到生成式引擎优化的转变不是文风之争,而是从索引字符串到计算嵌入、遍历知识图谱的迁移。把品牌存在感交给营销文案写手,你就会被模糊进向量背景。掌控LLM记忆中的品牌,需要四步:写出能解析为干净主谓宾三元组的句子;注入连接Wikidata实体的富链接JSON-LD;用非参数化基准量化每项主张;部署前用交叉编码器验证检索logit。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。