只用英语训练,却拿下日语第一:Darwin ZTC 登顶 S1MB

英语训练的决策模型 Darwin ZTC 未经日语训练,却在 S1MB 日语赛道夺冠,验证了跨语言迁移能力。
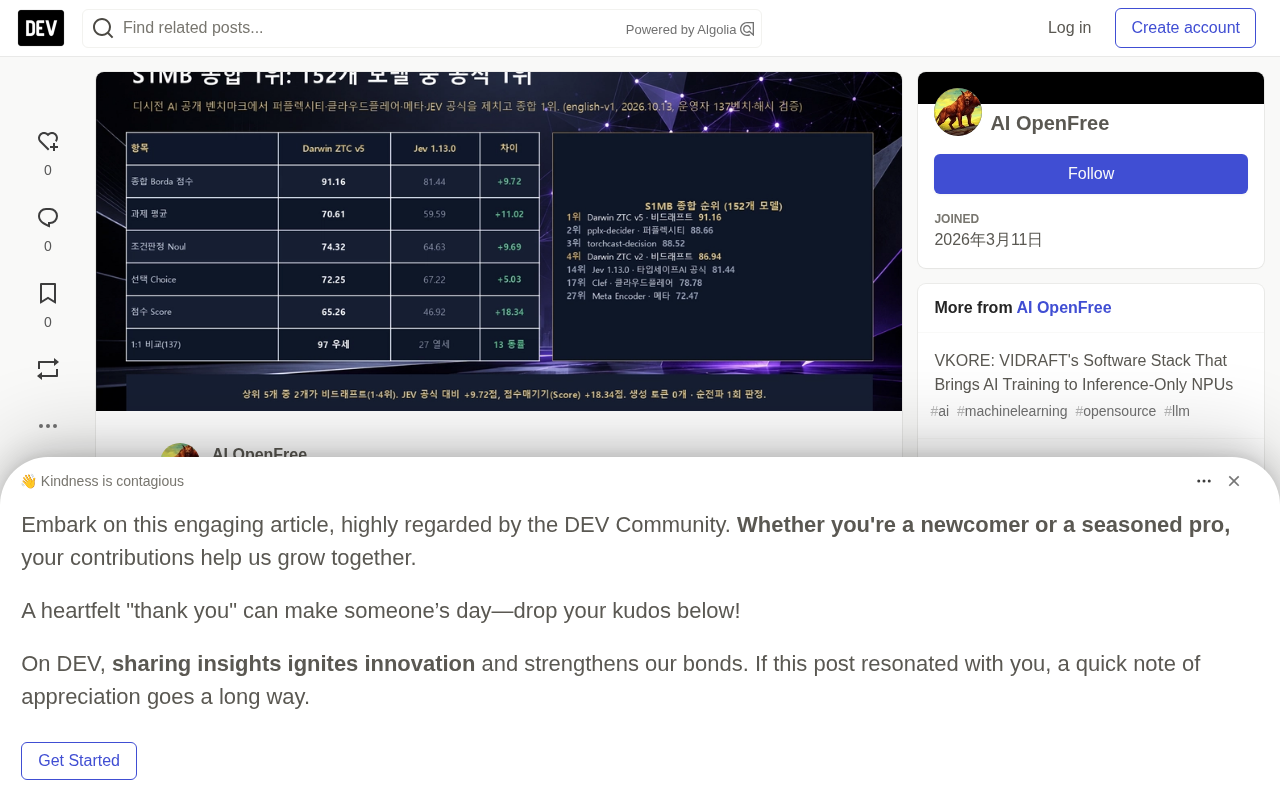
S1MB 是一套面向决策模型的基准,通过把多个专项基准的名次换算成分数取平均(Borda 总分)来避免单一任务主导结果。其新增的日语赛道包含 27 个基准。测试显示,纯英语训练的 Darwin-27B-ZTC-v5 以 Borda 84.57 拿下日语赛道第一,领先第二名 Perplexity 3.71 分;它在 27 项中取得 10 个第一、16 个前三,并在英语赛道 160 个模型中同样排名第一。文章认为,识别陷阱、道德判断、概率校准等「裁判」能力可以跨语言迁移,这对需要多语言路由、打分和安全门控的产品团队意味着显著的部署成本下降。
S1MB 是什么?为什么它新增了日语赛道
S1MB(System One Mosaic Benchmark)是一套专门评测「决策模型」的基准。这里的决策模型不是生成文本的模型,而是直接输出判断的模型——给它一段推理场景,它返回一个结论,而不是一段解释。S1MB 的做法是把多个专项基准分别排名,再把每个基准的名次换算成分数取平均,得出一个 Borda 总分,避免任何单一任务主导最终结果。
最近,该榜单的运营方新增了日语赛道 japanese-v1,包含 27 个日语基准,并直接对现有模型进行了测试。榜单公开可查,任何人都能在浏览器里复核数据。
Borda 计分法是一种源自 18 世纪法国数学家 Jean-Charles de Borda 的投票聚合方法,核心思路是:让每位投票者对候选方案排序,再按名次赋予分数(例如 N 个候选中,第一名得 N 分、第二名得 N-1 分……),最后把所有投票者的分数加总排名。
S1MB 借用这一逻辑:把每个专项基准视为一位「投票者」,模型在该基准中的名次即为排序,再换算成分数求平均。这样做有两个好处——其一,避免某个基准因为题目数量多、波动大而主导总榜;其二,即使模型在某项上表现平庸,只要在大量基准中稳定靠前,总分依然会很高。这也解释了为什么 Darwin ZTC 在 27 个基准中只拿下 10 个第一,却能稳居榜首:它的优势来自整体的「名次分布」,而非单点爆发。
结果:英语训练的模型,日语赛道也第一
Darwin-27B-ZTC-v5 在日语赛道拿下第一名,Borda 得分 84.57,领先第二名 Perplexity(80.86)3.71 分,torchcast(80.49)和 Jev 1.13(75.43)紧随其后。任务平均分方面,Darwin 为 60.05,第二名是 58.43。
更关键的是覆盖面:在 27 个基准中,它拿下 10 个第一,16 个进入前三。这不是靠某一项特别突出拉高总分,而是整体稳定靠前。
同时它也是英语赛道(160 个模型)的第一名,得分 90.80。也就是说,同一个模型在两个语言赛道上都处于领先位置,而它从未接受过任何日语专项训练。
跨语言迁移:一个被低估的能力信号
Darwin ZTC 的训练身份是英语决策引擎,没有日语决策训练集。但那些让模型成为好「裁判」的能力——识别陷阱、道德判断、概率校准——几乎原封不动地迁移到了日语上。
这对多语言部署的产品团队有直接价值。路由、打分、安全门控这些模块要在产品服务的每一种语言里运行。如果判断能力可以跨语言迁移,那么进入一个新语言市场的边际成本会显著降低,不必为每种语言重新训练一个专用裁判模型。
反过来说,一个判断力强的模型并不是在记忆某种语言的表面模式,而是在学习一种更抽象、更可迁移的技能。这或许也解释了为什么它在英语和日语两条赛道上都能站住脚。
**跨语言迁移(cross-lingual transfer)**指模型在一种语言上学到的能力,能够不经额外训练就应用到另一种语言。它在生成式模型上已有大量研究(如零样本跨语言问答),但在「决策模型」这类输出判断而非文本的模型上,此前缺乏公开的量化证据。
迁移能否成立,取决于模型学到的是「语言表层模式」还是「任务底层结构」。表层模式与具体词汇、语法强绑定,换语言即失效;而识别逻辑陷阱、做概率校准、进行道德权衡这类能力,其抽象层次高于语言本身,因此更容易迁移。S1MB 日语赛道恰好提供了这样一个测试场:27 个基准横跨知识、推理、文化常识等多个维度,如果迁移只是偶然,很难在如此宽的覆盖面里持续靠前。
正面对决:27 个基准里的胜负分布
把 Darwin ZTC 与日语赛道前三名逐个对比,它在多数基准上都取得胜利:对 Perplexity 是 15 胜 9 负 3 平,对 torchcast 是 15 胜 11 负 1 平,对 Jev 1.13 是 15 胜 10 负 2 平。
几个有代表性的胜利:
- JMMLU(日语知识考试):88.4,并列最佳。
- 常识道德判断:88.0,第一。
- SOBACO(日本文化常识):72.5,第一。
- JaNLI(含陷阱句的日语自然语言推理):83.7。
- JSICK 语义相关性:56.6。
- 运营方自编的数学与形式逻辑题:三种题型全部第一。
有意思的是,SOBACO 这类涉及日本本土文化常识的基准,理论上是对非日语训练模型最不友好的类型之一,但它依然拿到了第一。当然,12 个左右的负场也说明这种迁移并非无损,某些基准上它仍然会输给针对性更强的对手。
JMMLU 是 MMLU(Massive Multitask Language Understanding)的日语版本。MMLU 由多个学科的多选题构成,被广泛用作衡量模型知识广度的基准;JMMLU 保留了同样的学科结构,但题目与选项均以日语呈现,因此它不仅考验知识本身,也考验模型能否在日语语境下正确理解和作答。
JaNLI 对应的是 NLI(Natural Language Inference,自然语言推理)任务:给定前提句与假设句,判断二者是蕴含、矛盾还是中立。这类任务常被设计成包含「陷阱句」——例如否定、量词歧义或语序变化——专用来测试模型是否真的理解语义,而非依赖关键词匹配。
SOBACO 则聚焦日本本土文化常识,如节日、习俗、社会规范等。对非日语训练的模型而言,这类知识很难从通用语料中间接获得,因此在该基准上取得第一,比在纯逻辑类基准上获胜更能说明迁移的深度。
常见疑问
模型是否用日语决策数据做过微调? 没有。它以英语决策引擎的身份训练,日语成绩来自迁移能力。
Borda 分数是怎么算的? 每个基准的排名换算成积分再取平均,因此没有哪个单项任务能主导最终结果。
在哪里可以验证? 公开榜单可直接查看日语赛道与英语赛道的数据。
为什么双语言领先值得关注? 路由、打分和安全门控要在产品支持的每一种语言里工作,能迁移的裁判模型会降低多语言化的成本。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。