中文姓名性别推断新突破:汉字模型超越拼音方案

新研究利用汉字层面模型显著提升中文姓名性别推断准确性,超越拼音方案。
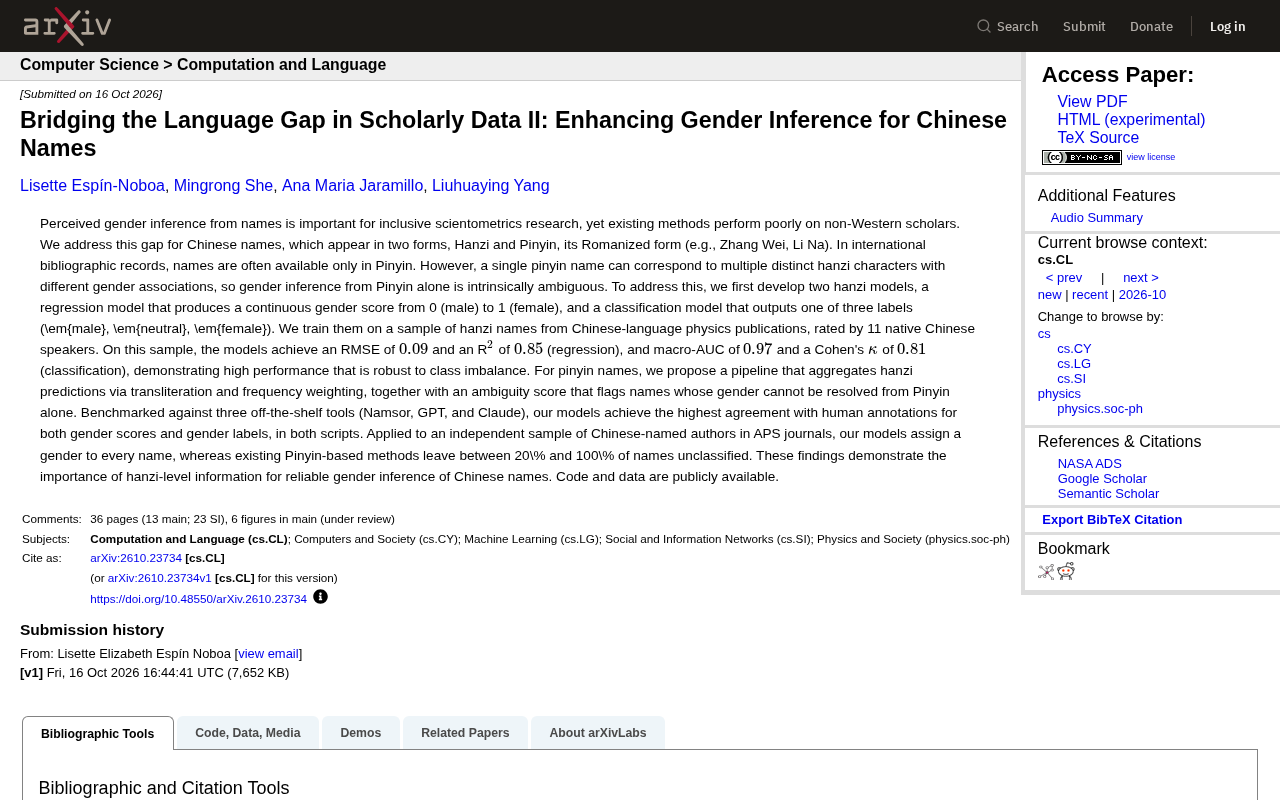
针对拼音中文姓名性别推断的固有歧义问题,一项研究开发了汉字层面的回归与分类模型,并构建了拼音到汉字的聚合流水线。回归模型RMSE为0.09、R²为0.85,分类模型宏平均AUC达0.97。在仅有拼音的场景下,流水线通过音译和频率加权聚合汉字预测,并输出歧义分数。与Namsor、GPT和Claude的对比显示,该模型与人工标注一致性最高。在APS期刊样本中,该模型实现全量分类,而拼音方法遗漏20%至100%的姓名。研究强调汉字信息对中文姓名性别推断的必要性,对科学计量学中的包容性分析具有重要意义。
中文姓名性别推断新突破:汉字模型超越拼音方案
在科学计量学研究中,从姓名推断性别是实现包容性分析的基础步骤。然而,现有工具在处理非西方学者姓名时表现不佳,尤其是中文姓名。一篇最新研究针对这一痛点提出了系统性解决方案,通过引入汉字层面的信息,显著提升了中文姓名性别推断的准确性。
拼音姓名的固有歧义
中文姓名在国际文献记录中通常以拼音形式出现,例如“Zhang Wei”或“Li Na”。问题在于,同一个拼音姓名可能对应多个不同的汉字组合,而这些汉字在性别联想上存在差异。这意味着仅凭拼音进行性别推断本质上是不确定的。研究指出,这种歧义是现有方法在中文姓名上表现不佳的根本原因之一。
据该研究分析,在国际书目数据库中,姓名往往仅有拼音可用,汉字信息缺失。这种信息损失使得基于拼音的性别分类器难以给出可靠判断。
汉字模型的设计与训练
为解决上述问题,研究团队首先开发了两个汉字层面的模型:一个回归模型输出从0(男性)到1(女性)的连续性别分数,另一个分类模型输出“男性”“中性”“女性”三个标签之一。两个模型均基于11位中文母语者对中文学术出版物中汉字姓名的评分样本进行训练。
在训练样本上,回归模型取得了RMSE为0.09、R²为0.85的表现;分类模型的宏平均AUC达到0.97,Cohen's κ为0.81。研究强调,这些结果在类别不平衡的情况下依然稳健,说明模型具有较高的实用价值。
RMSE(均方根误差) 衡量回归模型预测值与真实值之差的平方的平均值的平方根,量纲与目标变量一致。在本例中,性别分数取值在0到1之间,RMSE为0.09意味着模型预测平均偏离真实评分不到0.1,精度较高。
R²(决定系数) 表示模型解释的方差比例,取值越接近1越好。R²为0.85说明汉字回归模型能解释85%的性别评分变异。
宏平均AUC 是多分类场景下常用的评估指标:先对每个类别分别计算AUC(ROC曲线下面积,衡量排序能力),再取各类别AUC的算术平均。宏平均对少数类赋予同等权重,因此能反映模型在类别不平衡时的稳健性。AUC为0.97表明模型区分三类性别的能力很强。
Cohen's κ 衡量分类结果与真实标签之间的一致性,并校正了随机一致的概率。κ为0.81通常被视为“高度一致”,说明模型标签与人工标注吻合度很高。
拼音场景的聚合流水线
针对仅有拼音的姓名,研究提出了一条聚合流水线:通过音译将拼音映射到可能的汉字,再结合频率加权汇总汉字模型的预测结果。同时,流水线还输出一个“歧义分数”,用于标记那些仅凭拼音无法确定性别归属的姓名。这一设计既提供了预测结果,也坦诚地暴露了不确定性,便于后续人工核查或下游分析取舍。
音译(transliteration) 在这里指将拼音音节映射回可能对应的汉字集合。由于一个拼音音节(如“wei”)可能对应数十个汉字,音译步骤会生成候选汉字组合。
频率加权 指根据每个候选汉字在姓名语料中的出现频率为其预测结果赋予权重,频率越高的汉字组合权重越大,从而降低生僻组合的干扰。
歧义分数 是流水线输出的辅助指标,用于量化拼音姓名在性别归属上的不确定程度。例如,“Zhang Wei”可能对应“张伟”(男性倾向)或“张薇”(女性倾向),歧义分数会较高;而“Li Na”对应“李娜”的概率占绝对优势,歧义分数较低。该分数可帮助下游分析决定是否采纳预测或转人工核查。
与现有工具的基准对比
研究将所提模型与三款现成工具进行了对比:Namsor、GPT和Claude。结果显示,无论是性别分数还是性别标签,无论是汉字还是拼音形式,该模型与人工标注的一致性均为最高。这一多工具交叉验证表明,汉字层面信息的引入带来了实质性提升,而非仅仅是训练数据或评估方式的偶然优势。
有意思的是,在应用于APS期刊中中文姓名作者的独立样本时,该模型为每个姓名都分配了性别,而现有的基于拼音的方法则留下20%至100%的姓名未分类。这一对比直观地反映了传统方法在覆盖率和可用性上的局限。
对科学计量学的启示
这项工作的核心贡献在于证明了汉字层面信息对于中文姓名性别推断的必要性。对于从事科学计量学、科研评价和学术多样性分析的研究者而言,这意味着依赖拼音的快捷方法可能系统性地遗漏或误判大量中文姓名,进而影响研究结论的可靠性。研究代码与数据已公开,为后续复现和扩展提供了基础。
从更广的视角看,该研究也呼应了一个普遍问题:面向西方姓名设计的工具在跨语言场景中往往水土不服。解决之道不在于简单调参,而在于回到语言本身的特性,补足关键的信息层级。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。