逐层拆解Q4量化模型:BF16与Q4_K_M差异从何而来

heterodyne 在 llama.cpp 内逐 token 逐层对比量化与全精度模型,定位漂移来源。
heterodyne 是一个在 llama.cpp 内部运行的量化漂移归因工具,它逐 token、逐层对比两个配置(称为“臂”),记录全词表精确 KL、top-1 变化、每层残差流,并通过激活移植和注意力/MLP 贡献拆分定位差异来源。实验显示 Q4_K_M 与 BF16 的差异均匀分布在所有层,但在特定 token 上决定性差异形成于第 6 至 12 层;恢复 BF16 时注意力与 MLP 贡献无法区分,注入 Q4_K_M 时 MLP 贡献更大。此外,KV 缓存量化 q8_0 的影响可能超过权重从 BF16 到 Q8_0 的量化,且 CPU 路径在非 4 倍数批大小下存在批不变性问题。
量化模型与全精度模型输出不一致,通常只能看到一个汇总数字。开发者 zaydmulani09 构建了 heterodyne,在 llama.cpp 内部逐 token、逐层对比两个配置,定位差异来源。本文基于其开源项目与实验数据,梳理量化漂移的归因方法。
量化漂移:一个聚合数字掩盖了什么
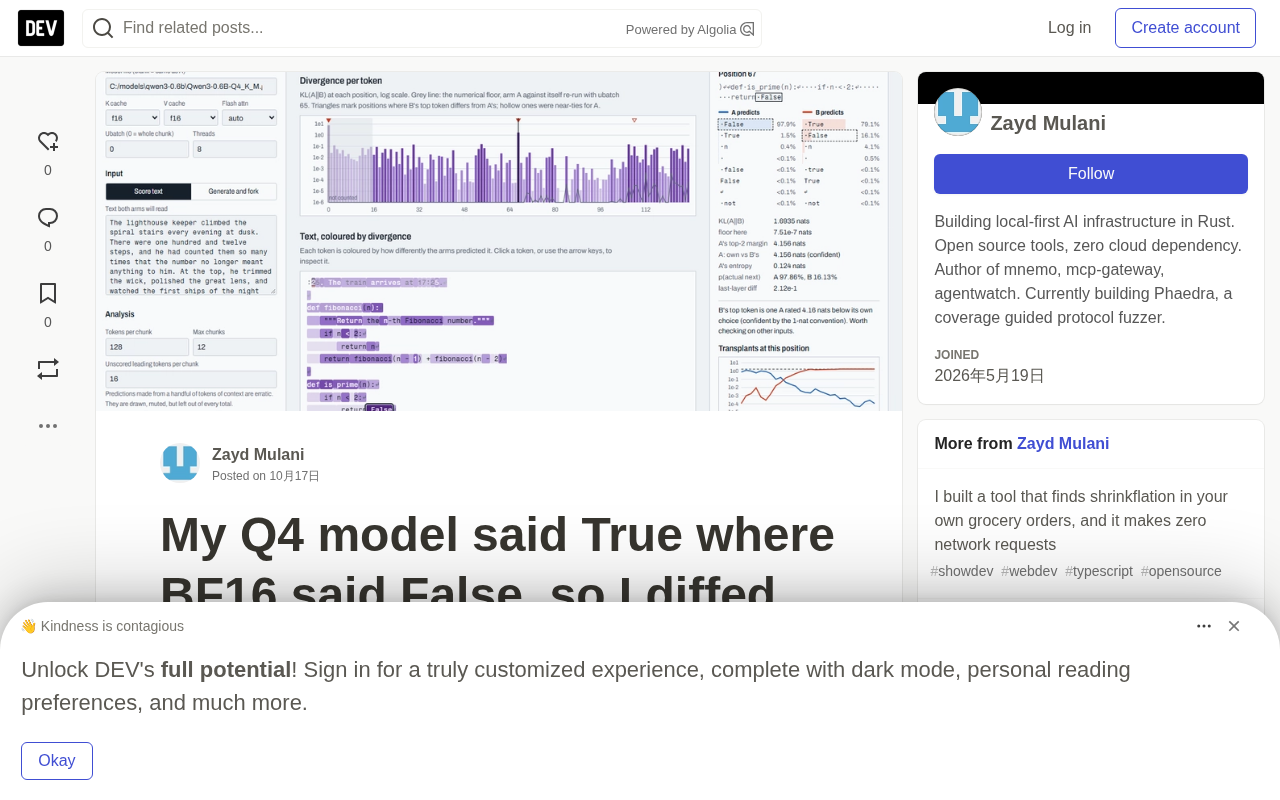
用 Qwen3-0.6B 的 BF16 版本和 Q4_K_M 量化版本跑同一段代码,在 is_prime 函数定义处,BF16 有 97.9% 概率输出 False,而 Q4_K_M 有 79.1% 概率输出 True。这只是 1282 个评分位置中的一个 token。
整体来看,Q4_K_M 在 11.6% 的位置改变了 top-1 token,与 BF16 的平均 KL 散度为 0.067,困惑度从 7.83 升至 8.53。这些数字说明量化确实带来了漂移,但无法回答更关键的问题:漂移发生在哪些 token、哪些层、层内哪个模块,以及权重是否比 KV 缓存或批大小影响更大。
KL 散度(Kullback-Leibler divergence)衡量两个概率分布之间的差异:若 P 是基准分布、Q 是近似分布,KL(P‖Q) 表示用 Q 编码 P 时平均多付出的信息量,单位通常是 nat。它非负、不对称,值越大说明两个分布越不像。在量化分析中,KL 常被用来量化全精度模型与量化模型在每个 token 位置上的输出分布偏移,再对全词表求和或取平均,得到平均 KL。需要注意的是,平均 KL 会掩盖分布尾部的剧烈变化:少数 token 的 KL 可能极高,但被大量接近零的位置平均掉。因此单看平均 KL 无法判断漂移集中在哪些 token,这也正是 heterodyne 要逐 token、逐层记录精确 KL 的原因。
heterodyne 的工作方式
为什么不直接用 TransformerLens
主流可解释性工具如 TransformerLens、nnsight 都运行在 PyTorch 上。但在 CPU 上,llama.cpp 会在每次量化矩阵乘法前将激活值量化为 8 位。一个使用反量化权重的 PyTorch 模型,与你实际运行的 GGUF 文件并不是同一个模型。llama.cpp 自带的 llama-perplexity --kl-divergence 也只报告聚合值。
heterodyne 选择在 llama.cpp 内部工作,使用与实际部署相同的计算内核。
GGUF 是 llama.cpp 使用的模型文件格式,它把模型权重、分词器配置和元数据打包在一起,并支持多种量化类型(如 Q4_K_M、Q8_0)。量化权重在推理时通常需要先反量化回浮点再参与计算,但 llama.cpp 在 CPU 上采用了一种混合策略:权重保持量化存储,激活值则在每次矩阵乘法前动态量化为 8 位整数,再用整数指令完成乘加。这意味着实际执行的数值路径与“反量化权重后跑 PyTorch”并不等价,后者缺少激活量化这一步以及相应的舍入误差。所以用 PyTorch 工具分析 GGUF 文件,得到的漂移来源可能与部署时看到的并不一致,heterodyne 选择直接嵌入 llama.cpp 正是为了避开这一偏差。
双“臂”对比与数值底线
heterodyne 将每个配置称为一个“臂”(arm),即一个 GGUF 文件加上可能改变其数值的运行时设置(K/V 缓存类型、flash attention、ubatch 大小)。它在相同 token 上逐块运行两个臂,并记录:
- 每个位置上全词表的精确 KL(A‖B),从原始 logits 以 f64 累加,以及每次 top-1 变化及其置信度;
- 一个数值底线:用奇数批分割重新运行臂 A,作为该机器上无害差异的基准;
- 两个臂每层之后的残差流;
- 激活移植结果(见下文);
- 可选地,遍历所有不同设置的组合,将变化归因到某一项。
所有结果保存为带溯源信息的实验文件(GGUF 哈希、llama.cpp 提交号、构建标志)和完整性哈希,heterodyne verify 可重跑并精确比对每个存储的数值。
数值底线(numerical floor)是实验设计中的对照基准:在同一台机器、同一份模型上,用不改变数学含义的方式改变计算顺序(例如把批分割成奇数大小),观察输出因此产生多大差异。这个差异来自浮点累加顺序、线程调度等非本质因素,属于“无害噪声”。任何归因实验测到的 KL 都必须明显高于这个底线,才能被认为是量化或配置带来的真实影响。heterodyne 用奇数批分割重跑臂 A 来估计底线,同时也解释了为什么它的批不变性测试要关注 ubatch 大小是否为 4 的倍数——非 4 倍数会触发不同的量化激活路径,本身就构成一种数值扰动。
激活移植:定位关键层
heterodyne 利用 llama.cpp 调度器的 cb_eval 回调,在计算到指定图节点时复制或覆写张量。由于所有下游节点在拓扑序中都在其后,覆写会影响后续计算。张量通过图名称寻址:l_out-N 是第 N 层后的残差流,ffn_inp-N 是第 N 层注意力与 MLP 之间的残差。
去噪实验:运行臂 B,但写入臂 A 的 l_out-N,测量 KL(A‖patched B)。加噪实验则相反。对每一层执行即可得到曲线。Q4_K_M 与 BF16 的结果显示,KL 从第 0 层的 0.062 平滑下降到第 27 层的 0.0013,没有单一层承载全部差异。在 is_prime token 处,将 BF16 的残差写入 Q4_K_M,该 token 的 KL 从第 6 层后的 0.48 降至第 9 层后的 0.04;反向写入则从约第 12 层重现翻转。该 token 的决定性差异形成于第 6 至 12 层。
残差流(residual stream)是 Transformer 中各层之间传递的主干向量:每层的注意力输出和 MLP 输出都加回到这个流上,因此它累积了从嵌入层到当前层的全部信息。llama.cpp 的计算图中,l_out-N 表示第 N 层计算完毕后的残差流,ffn_inp-N 表示第 N 层注意力之后、MLP 之前的残差。由于计算图按拓扑序执行,覆写某个节点的张量会改变所有下游节点的输入,从而让“把 A 的某层残差写入 B”成为可能。激活移植正是利用这一点:逐层替换残差流,观察 KL 如何变化,从而判断差异是在哪一层被引入、又在哪一层被放大或抵消的。
注意力与 MLP 的贡献拆分
直接写入 MLP 输出会抹去 MLP 对上游差异的反应,导致权重相同的模块也可能显得“负责”。heterodyne 改为在每层两个恢复点(注意力后 ffn_inp-N 和 MLP 后 l_out-N)恢复臂 A 的完整残差,取相邻点之间的差值。注意力在第 N 层的份额等于在该层输入恢复 A 时的 KL 减去注意力后恢复 A 时的 KL;MLP 份额是下一步。这些步骤可望远镜式求和,不会重复计算。
该方法有一个已知答案的校验:如果两个臂仅 K 缓存类型不同,那么只有注意力读取 K 缓存,每个 MLP 步骤必须精确为零。测试按位检查,在 Qwen3 上也成立。
在 12 个块、1282 个评分位置上,95% 区间显示:在 Q4_K_M 中恢复 BF16 时,注意力消除 0.030(0.019–0.041),MLP 消除 0.036(0.024–0.048),配对差异 0.006(−0.011 至 0.022)跨越零,两者无法区分。而将 Q4_K_M 注入 BF16 时,MLP 增加更多(0.014,0.005 至 0.023)。最大的单步是第 0 层注意力,但 llama.cpp 不命名第 0 层输入,该柱也包含 token 嵌入的差异。少数步骤为负(第 2 层注意力 −0.0014),说明单独恢复该模块反而使 Q4_K_M 更远离 BF16。
该分析每个块每层需要额外两轮计算,12 块在 i7-1355U 笔记本上耗时 29 分钟。
其他发现
在相同文本、相同笔记本上测试不同量化级别:
| 配置 | 平均 KL | top-1 变化 | 困惑度(BF16: 7.83) |
|---|---|---|---|
| Q8_0 | 0.0022 | 2.2% | 7.83 |
| UD-Q4_K_XL | 0.058 | 11.3% | 8.33 |
| Q4_K_M | 0.067 | 11.6% | 8.53 |
| Q3_K_M | 0.214 | 20.8% | 9.47 |
| Q2_K | 0.780 | 36.3% | 16.75 |
两个值得注意的结论:
KV 缓存的影响被低估。 同一个 Q8_0 文件运行两次,第二次使用 q8_0 的 K/V 缓存,KL 为 0.0038,比将权重从 BF16 量化为 Q8_0(0.0022)的影响还大。
llama.cpp 的 CPU 路径并非在所有批大小下批不变。 关闭 flash attention 时,Q4_K_M 在 4 的倍数 ubatch 大小下输出按位相同,其他大小则不同(ubatch 63 时 4.7% 的 top token 改变)。原因是重排后的 K-quant 矩阵乘法以 4 行为组量化激活,余数走另一条路径。这也是 heterodyne 的数值底线使用奇数分割的原因。
局限与试用
作者明确说明:仅一个小模型、一段文本、一台机器;移植是对你的输入的干预,说明在该文本上恢复某模型激活能消除差异的位置,而非一般意义上哪个模块权重量化更差;仅 CPU,GPU 内核计算方式不同,目前结果不适用于 GPU。
可从 GitHub releases 获取 Linux、Windows、macOS arm64 二进制,运行 heterodyne serve --models ~/models 或使用命令行对比两个 GGUF 文件。所有数字对应的实验文件在 examples/ 目录中。
对于需要排查量化模型行为差异的开发者,这种在部署内核内逐层归因的方法提供了一种可复现的路径,而不仅仅是看一个 KL 数字。
相关推荐

如何评估AI生成的研究摘要?三个关键维度
AI生成的研究摘要读起来流畅,但事实未必可靠。本文基于Reddit讨论,梳理评估AI研究摘要系统的三个核心维度:来源可追溯性、事实一致性与不确定性处理,并探讨其对深度学习从业者的实践意义。
Go工具Unspill:扫描AI编程助手历史记录中的凭证泄露
介绍Go语言CLI工具Unspill,可本地扫描Copilot CLI、Claude Code、Codex等AI编程助手的历史记录,检测泄露的API密钥和凭证,支持脱敏报告且无网络请求。
AI工具正在"入侵"复古游戏:一场创造力与版权的博弈
AI工具正在大幅降低复古游戏移植门槛,浏览器版《光环》、iPhone版《风之杖》等项目病毒式传播,但也引发版权争议与行业监管担忧。