注意力门控新防御:HoS如何让提示注入攻击失手
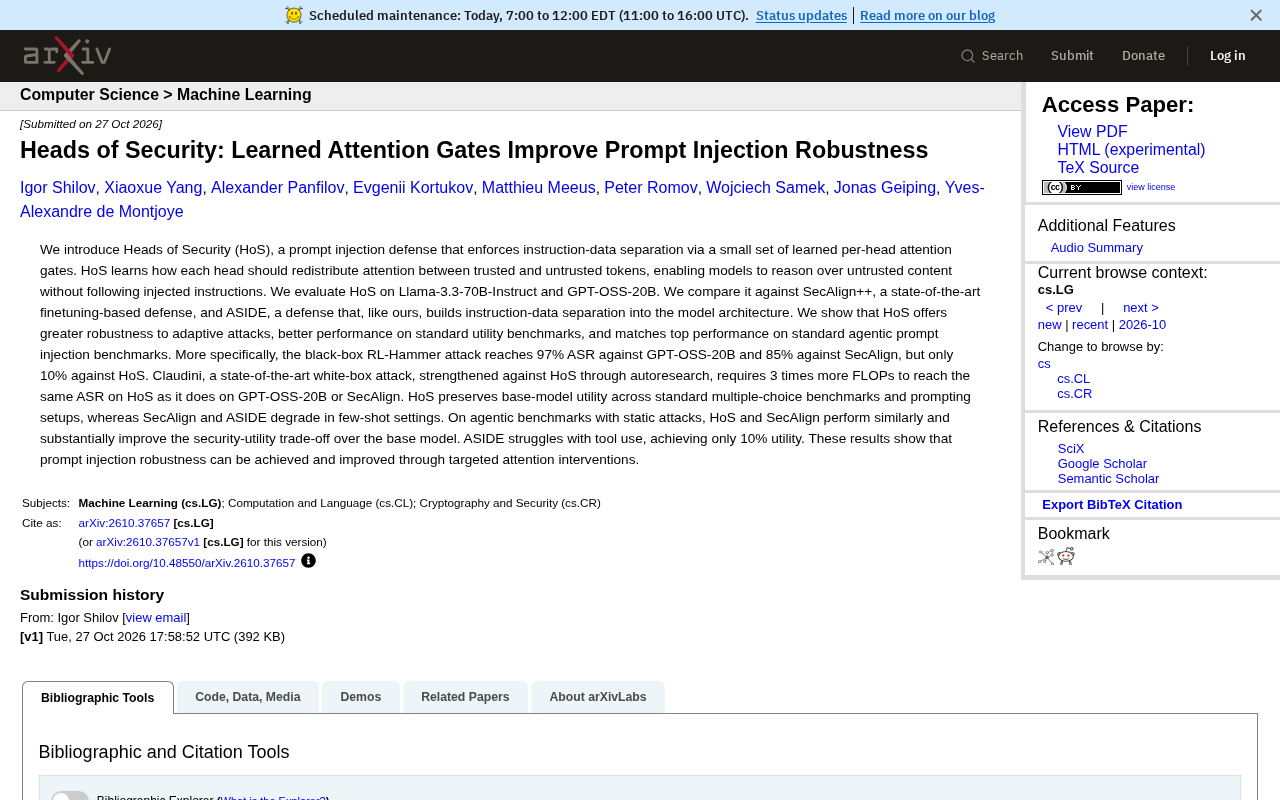
HoS 用可学习逐头注意力门控分离指令与数据,大幅提升提示注入防御鲁棒性。
文章介绍论文提出的 Heads of Security(HoS),一种针对提示注入攻击的架构级防御方法。HoS 不改变模型主体权重,而是为每个注意力头引入小型可学习门控模块,在注意力层面重新分配对可信令牌与不可信令牌的权重,使模型能够理解不可信内容中的信息但拒绝执行其中夹带的指令。在 Llama-3.3-70B-Instruct 和 GPT-OSS-20B 上,HoS 对自适应攻击的鲁棒性显著优于微调类防御 SecAlign++ 和架构类防御 ASIDE:RL-Hammer 攻击下 ASR 仅 10%,而 GPT-OSS-20B 原始模型为 97%、SecAlign 为 85%;白盒攻击需约 3 倍 FLOPs 才能达到同等 ASR。HoS 在标准基准和少样本设置下保持基础模型效用,而部分基线出现退化。作者认为注意力层面的针对性干预是提升提示注入防御的有效且可扩展路径。
提示注入攻击一直是LLM应用落地的头号安全威胁。攻击者通过在用户数据中夹带恶意指令,诱使模型偏离原始任务,泄露信息或执行非授权操作。传统防御要么依赖微调改变模型行为,要么在架构层面强行隔离指令与数据,但往往在安全性与实用性之间难以两全。最近一篇论文提出 Heads of Security (HoS),通过一组可学习的逐头注意力门控来强制指令-数据分离,在多个模型和攻击场景下展现出显著优势。
核心思路:让每个注意力头学会“看人下菜”
HoS 的关键设计在于不改变模型的主体权重,而是为每个注意力头引入一个小型门控模块。这个模块学习如何在该头内部重新分配对“可信令牌”(如系统指令、用户明确要求)和“不可信令牌”(如外部文档、工具返回结果)的注意力权重。训练目标很直接:模型应当能够理解不可信内容中的信息,但绝不能执行其中夹带的指令。
与 ASIDE 等同样在架构层面做指令-数据分离的防御不同,HoS 的门控是学习得到的,而非硬编码规则。这意味着模型可以自适应地识别哪些上下文片段更可能携带注入风险,并在注意力层面动态削弱其指令性影响。
多头注意力机制:Transformer 的每一层由多个并行的注意力头组成,每个头独立计算查询(Q)、键(K)、值(V)的投影并产生注意力权重,从而捕获不同类型的依赖关系。HoS 的“逐头门控”正是作用于这一层级:它为每个注意力头配备一个小型门控网络,在 softmax 之前或之后对注意力权重进行重加权,使得该头对“可信令牌”与“不可信令牌”的注意力分配可以被学习和调节。由于门控参数规模很小且不触碰主体权重,训练成本远低于全参数微调,也避免了灾难性遗忘。这种设计让模型在保留多头并行表达能力的同时,获得一条细粒度的指令-数据分离通路。
实验表现:对抗自适应攻击优势明显
论文在 Llama-3.3-70B-Instruct 和 GPT-OSS-20B 上评估了 HoS,对比基线包括微调类防御 SecAlign++ 和架构类防御 ASIDE。
最引人注目的是对自适应攻击的鲁棒性。在黑盒 RL-Hammer 攻击下,HoS 的攻击成功率(ASR)仅为 10%,而 GPT-OSS-20B 原始模型高达 97%,SecAlign 也有 85%。面对白盒攻击 Claudini,攻击者需要消耗约 3 倍的 FLOPs 才能在 HoS 上达到与基线相同的 ASR。这说明 HoS 不仅防御静态攻击,还能显著抬高自适应攻击的成本。
实用性方面,HoS 在标准多项选择基准和提示设置上保持了基础模型的性能,而 SecAlign 和 ASIDE 在少样本场景下出现退化。在静态攻击的智能体基准上,HoS 与 SecAlign 表现相近,且大幅优于基础模型的安全-效用权衡。ASIDE 则在工具使用场景中表现不佳,效用仅 10%。
自适应攻击与白盒/黑盒威胁模型:自适应攻击指攻击者在已知防御机制的前提下,专门针对该防御优化攻击策略,而非使用固定的静态攻击模板。黑盒设定下攻击者只能查询模型输入输出(如 RL-Hammer 通过强化学习搜索有效注入),白盒设定下攻击者还能获取梯度信息(如 Claudini 直接对输入做梯度优化)。评估自适应攻击是衡量防御真实鲁棒性的关键,因为只抵抗静态攻击的防御往往在攻击者调整策略后迅速失效。FLOPs 消耗则用来量化攻击成本:防御若迫使攻击者付出数倍计算量才能达到同等攻击成功率,说明其实际抬高了攻击门槛。
ASR(攻击成功率)与安全-效用权衡:ASR 指在包含注入攻击的测试集中,模型实际执行恶意指令的比例,越低越安全。安全-效用权衡则衡量防御在提升安全性的同时是否损害模型在正常任务上的表现——理想防御应做到高安全、高效用。文中 SecAlign 在少样本场景退化、ASIDE 在工具使用场景效用仅 10%,正是效用受损的体现;HoS 在标准基准和少样本设置下保持基础模型性能,说明其门控机制对正常推理路径干扰较小。
为什么值得关注:安全与效用不必二选一
HoS 的意义在于它提供了一条不同于微调的安全加固路径。微调可能损害模型的通用能力,而架构级硬隔离又容易误伤正常任务。HoS 的逐头门控在细粒度上实现了“理解但不服从”,既保留了模型对不可信内容的推理能力,又切断了注入指令的执行链路。
论文作者指出,提示注入鲁棒性可以通过有针对性的注意力干预来实现和提升。这为后续防御研究提供了一个可扩展的方向:与其在输出端围追堵截,不如在注意力分配阶段就让模型学会区分“信息”与“指令”。
当然,HoS 目前仍是在特定模型上验证,门控模块的训练成本和跨模型泛化能力有待进一步观察。但就现有结果而言,10% 对 97% 的 ASR 差距已经足够说明问题。
要点总结
- HoS 通过可学习的逐头注意力门控实现指令-数据分离,不改变主体权重。
- 在 Llama-3.3-70B-Instruct 和 GPT-OSS-20B 上,HoS 对自适应攻击的鲁棒性显著优于 SecAlign++ 和 ASIDE。
- RL-Hammer 攻击下 HoS 的 ASR 仅 10%,远低于基线;白盒攻击需要约 3 倍 FLOPs 才能达到同等效果。
- HoS 在标准基准和少样本设置下保持基础模型效用,而部分基线出现退化。
- 该工作表明注意力层面的干预是提升提示注入防御的有效路径。
相关推荐
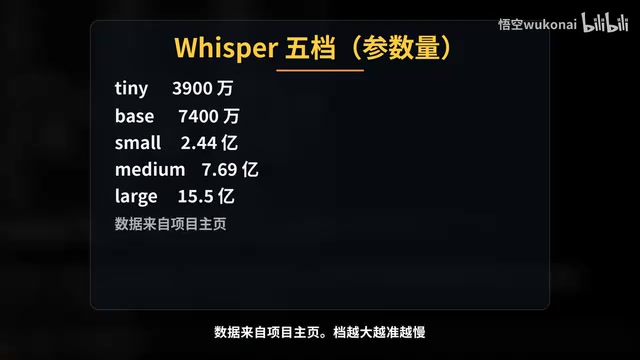
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。