锥形束CT报告生成:部分可观测目标下的临床推理陷阱
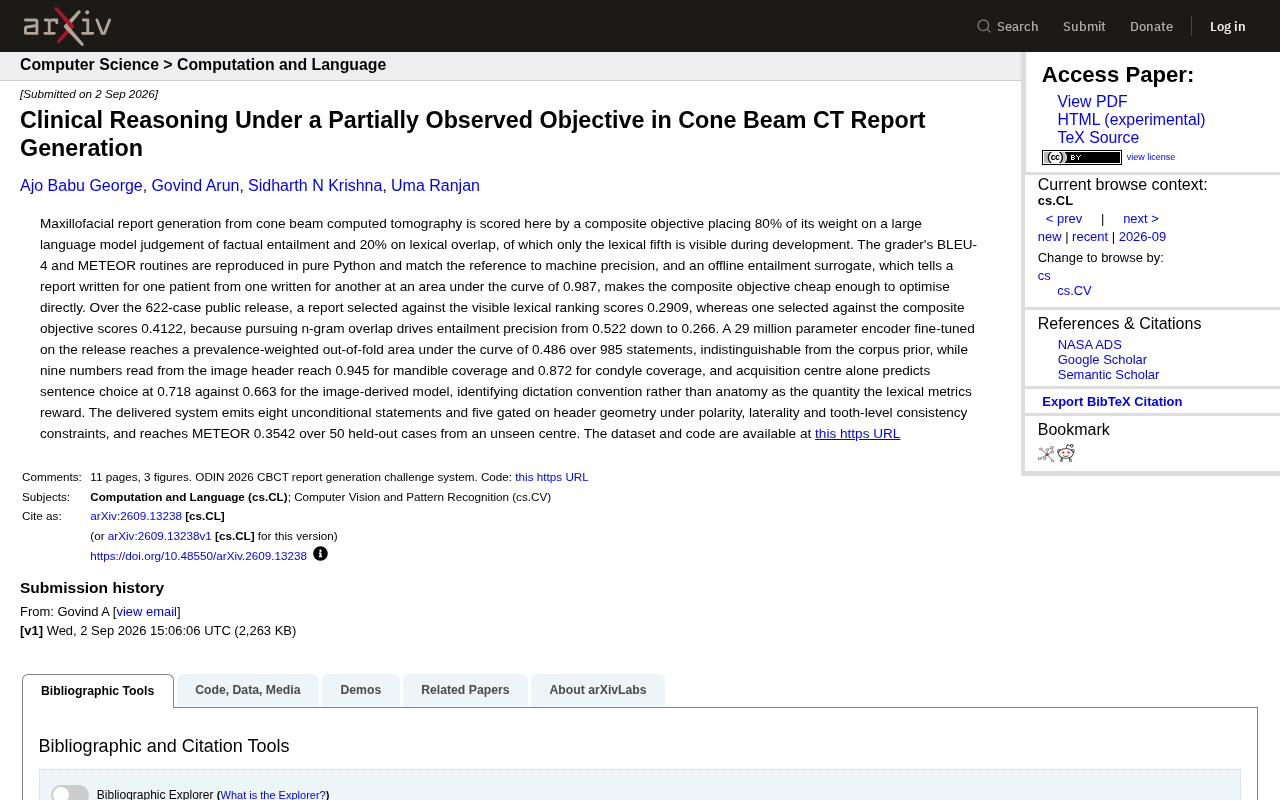
CBCT报告生成研究揭示:优化可见的词汇指标反而损害事实准确性,模型学的是医院口述习惯而非影像信息。
这篇论文以颌面部锥形束CT报告自动生成为载体,深入剖析了一个普遍性困境:当评估目标只有一部分对开发者可见时,模型优化会系统性地走偏。研究设计的复合评分将80%权重置于LLM事实蕴含判断,仅20%在词汇重叠上,而开发阶段只有后者可见。实验表明,按词汇排名选择的报告复合得分(0.2909)显著低于按完整目标选择的报告(0.4122),蕴含精度从0.522骤降至0.266。更根本的问题是,词汇指标奖励的不是影像中的解剖信息,而是各医疗机构的口述惯例——仅凭采集中心这一变量就能以0.718准确率预测句子选择,高于影像模型的0.663。研究者最终交付了一套用极性、侧别和牙位一致性约束的门控陈述系统,在跨中心泛化条件下取得METEOR 0.3542,以结构化保守策略换取可信度。
一个被评分规则扭曲的医学AI任务
从锥形束计算机断层扫描(Cone Beam CT,CBCT)自动生成颌面部影像报告,看似是又一个多模态医学AI的常规应用。但这篇arXiv新论文揭示了一个更深层的问题:当评估目标只有一部分对开发者可见时,模型优化会走向何方?
研究者设计的复合评分把 80% 的权重放在大语言模型对事实蕴含(factual entailment)的判断上,仅 20% 落在词汇重叠(lexical overlap)上。关键在于,开发阶段只有那 20% 的词汇部分是可见的——这就是标题所说的"部分可观测目标"(partially observed objective)。开发者能看到的,恰恰不是真正决定分数的那部分。
这种设置直接模拟了现实中一个常见困境:我们用来训练和调优模型的代理指标(如 BLEU、METEOR),往往与我们真正关心的临床质量目标并不一致。
追逐词汇重叠反而拉低事实准确性
论文最有力的实证发现来自 622 个公开案例的对比实验。研究者首先在纯 Python 中复现了评分器的 BLEU-4 和 METEOR 例程,精度与参考实现达到机器精度级别的一致;同时构建了一个离线的蕴含代理模型,它能以 0.987 的 AUC 区分"为患者A写的报告"和"为患者B写的报告",从而让直接优化复合目标变得计算成本可控。
结果颇具讽刺意味:
- 按可见的词汇排名挑选的报告,复合得分仅为 0.2909;
- 按完整复合目标挑选的报告,得分升至 0.4122。
差距的根源在于,一味追逐 n-gram 重叠会把蕴含精度(entailment precision)从 0.522 拖低到 0.266。换句话说,让报告在字面上更"像"参考答案,反而使其在事实层面更不可靠。这是对纯词汇类指标在医学报告生成中适用性的一记警钟。
模型学到的是口述习惯,而非解剖结构
更值得警惕的发现,是关于词汇指标究竟在奖励什么。研究者训练了一个 2900 万参数的编码器,在公开数据上微调后,对 985 条陈述的"流行度加权跨折 AUC"仅为 0.486——与语料库先验(corpus prior)无法区分,几乎等于没学到有效信息。
然而,从影像文件头(header)中直接读取的九个数字,对下颌骨覆盖度的预测 AUC 达到 0.945,髁突覆盖度达到 0.872。更耐人寻味的是,仅凭采集中心(acquisition centre)这一个变量,预测句子选择的准确率就达到 0.718,反而高于影像衍生模型的 0.663。
这意味着,词汇指标真正奖励的是各医疗机构的口述惯例(dictation convention),而非影像中的解剖学信息。不同中心的医生有各自固定的措辞习惯,模型只要摸清"这份报告来自哪家中心",就能在词汇匹配上得高分——这与临床推理能力毫无关系。
用约束换取可信度的交付系统
面对这些陷阱,研究者交付的系统采取了保守而结构化的策略。它输出 8 条无条件陈述,以及 5 条在文件头几何信息基础上、受极性(polarity)、侧别(laterality)和牙位级别一致性约束的门控陈述(gated statements)。
这套系统在来自一个未见过的中心的 50 个留出案例上,取得了 METEOR 0.3542 的成绩。这个数字本身不算惊艳,但考虑到它是在跨中心泛化的严苛条件下取得的,并且建立在对指标缺陷的清醒认知之上,其可信度反而更高。
数据集与代码已在 GitHub 公开(GIND123/CBCT-Clinical-Reasoner),便于后续研究复现和验证。
对医学AI评估的启示
这项工作的价值超出了 CBCT 报告生成本身。它以严谨的量化证据说明了几个普遍问题:
第一,代理指标的可见性会塑造优化方向。当开发者只能优化可见的那部分目标,且该部分与真实目标不一致时,模型很容易走向表面达标、实质失效。
第二,词汇重叠指标在医学文本中可能是危险的。它们奖励的是格式与措辞习惯,而非事实正确性,甚至可能与事实准确性负相关。
第三,简单基线是必要的照妖镜。用文件头元数据、采集中心这类"泄漏特征"做对照,能有效暴露出模型是否真的在做临床推理,还是在利用统计捷径。
对于任何构建医学影像报告生成系统的团队,这篇论文都值得作为方法论层面的参考——在追求高分之前,先搞清楚分数究竟在衡量什么。
相关推荐
用LTX+MiniMax H3打造AI科幻短片:ComfyUI克制镜头语言实战
AI科幻短片《REMAINDER》用LTX、MiniMax H3与ComfyUI打造克制的镜头语言,通过扁平化美学解决视觉一致性难题。拆解其多模型协作工作流与创作方法论。
LangChain Deep Agents 与 MDA 有何区别?开发者困惑解析
LangChain 的 Deep Agents 与 MDA(托管深度智能体)到底有何区别?本文从 create_deep_agent 与 define_deep_agent 的差异出发,解析自托管与托管两种智能体部署模式的取舍,帮助开发者理清选择思路。
廉价的OpenAI兼容API:开源大模型云端调用的机会与痛点
一位开发者在Reddit探讨:是否需要一个廉价、兼容OpenAI接口的开源模型API服务,让开发者无需GPU即可调用Qwen、Llama等模型。本文分析该设想的痛点、计费模式取舍与市场挑战。