自适应表示的泛函梯度下降:NeurIPS新作挑战神经网络

NeurIPS论文提出「自适应表示」框架,首次让泛函梯度下降既可证明收敛又能工程落地,并以数量级优势超越神经网络。
一篇被NeurIPS接收的论文提出「自适应表示」(Adaptive Representations)框架,解决了泛函梯度下降(Functional GD)长期无法稳定落地的核心难题。泛函梯度下降在函数空间中直接寻优,理论上不依赖固定参数化形式,但其梯度本质上是无限维对象,朴素近似会导致算法系统性地收敛到错误位置。自适应表示通过动态调整近似所用的函数空间,在理论上可证明收敛到全局最小值,同时保留了工程可实现性。作者报告该方法在多个实验设置中以数量级优势超越对应的神经网络基线。论文作者将其定位为该研究方向的起点,实际在大规模、高维任务上的表现以及可扩展性仍有待社区独立验证。
一项被 NeurIPS 接收的新研究
神经网络几乎垄断了当下机器学习的主流叙事,但并非所有优化方法都要绕着网络参数打转。一篇被 NeurIPS 接收的论文《Functional Gradient Descent with Adaptive Representations》给出了另一条路径:直接在函数空间中做梯度下降(Functional Gradient Descent,简称 Functional GD),并通过一种称为「自适应表示」的机制解决其长期存在的实现难题。
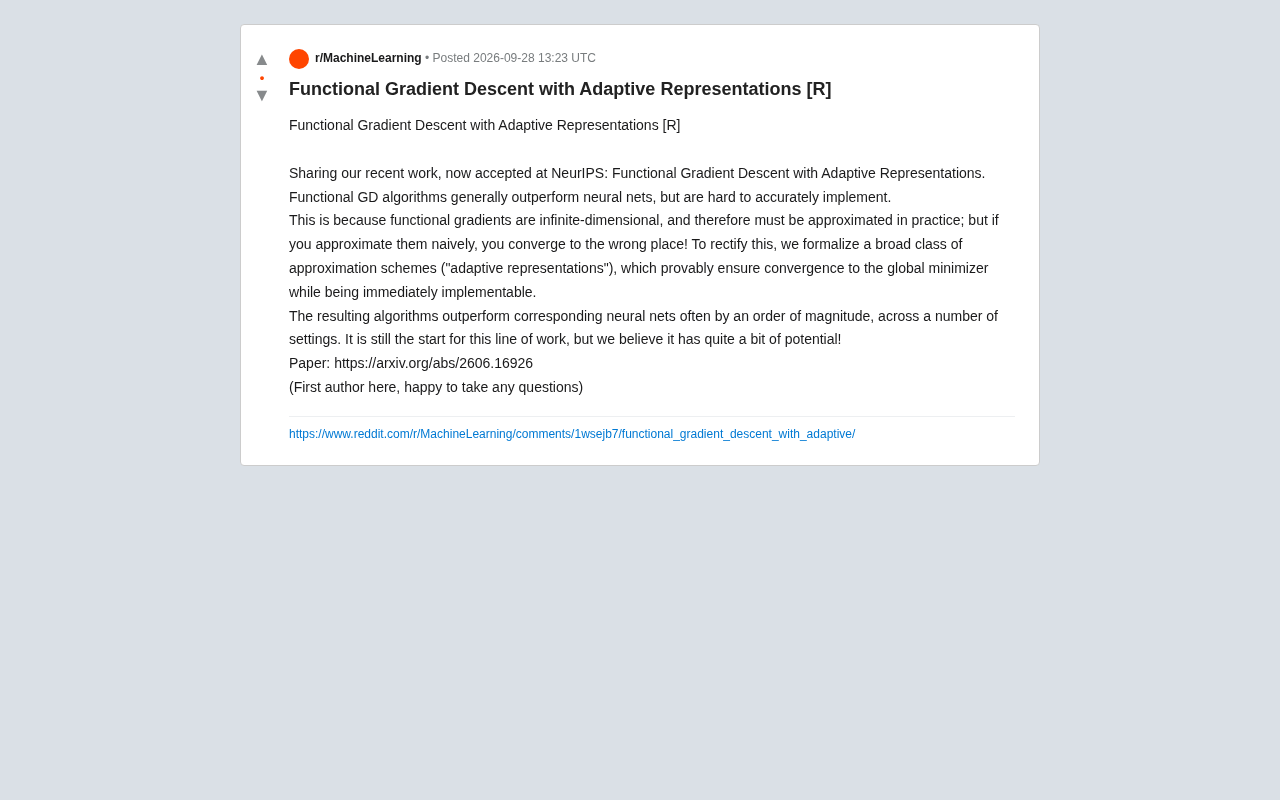
论文的第一作者在 Reddit 上分享了这项工作,并公开回应社区提问。据其介绍,泛函梯度下降类算法在很多场景下的表现通常优于神经网络,但准确实现起来相当困难——这正是这项研究试图突破的关键瓶颈。
泛函梯度为什么难以实现
要理解这项工作的价值,需要先看清楚 Functional GD 的核心矛盾。
无限维带来的近似困境
传统神经网络优化的是有限个参数,而泛函梯度下降是在函数空间中直接寻优。问题在于,函数空间中的梯度是无限维的对象。无限维意味着无法在计算机中精确存储和计算,实践中必须做近似处理。
作者指出了一个容易被忽视的陷阱:如果对这些无限维梯度做朴素的近似,算法最终会收敛到错误的位置。换句话说,近似方式本身会引入系统性偏差,让优化过程偏离真正的目标,而不仅仅是精度上的损失。这也是为什么 Functional GD 虽然理论上有吸引力,却长期难以被稳定、正确地落地。
泛函梯度下降的理论根基来自再生核希尔伯特空间(RKHS)和函数空间中的变分方法。其基本思路是:将目标函数 F 视为「以函数 f 为自变量」的泛函,每一步迭代不是更新参数向量,而是将当前函数 f 沿「负泛函梯度」方向更新,得到一个新的函数 f'。经典的 Boosting 算法(如 Gradient Boosting)可以理解为这一框架的特例,每次迭代相当于在函数空间中跨出一步并用一棵新的决策树来近似该步的梯度方向。无限维的挑战在于,真正的泛函梯度是一个函数,而非有限维向量,计算机无法精确表达;每一步都必须用有限维的「基函数」(如核函数、树、或网络)来近似这个梯度函数,近似误差会随迭代不断累积,进而破坏收敛性。
收敛到「错误的地方」意味着什么
对优化算法而言,收敛点决定了模型的最终质量。若近似方案破坏了收敛保证,那么无论迭代多少次,得到的都不是全局最优解,而是被近似误差牵引到的偏移点。这类问题在实践中往往不易察觉,却会实质性地限制方法的可靠性。
自适应表示:兼顾正确性与可实现性
论文的核心贡献,是形式化了一大类近似方案,并将其命名为「自适应表示」(adaptive representations)。
这类方案的关键特性有两点。其一,它在理论上可证明地保证收敛到全局最小值(global minimizer),从根本上避免了朴素近似导致的错误收敛问题。其二,它是可立即实现的(immediately implementable),并非停留在纸面上的理论构造,而是能够直接转化为可运行的算法。
这种「理论正确性 + 工程可行性」的结合,正是该方法的价值所在。它没有为了收敛保证而牺牲实用性,也没有为了易实现而放弃数学严谨。
「自适应表示」(Adaptive Representations)的核心思想是:近似所用的有限维函数空间并非固定不变,而是随迭代过程动态调整,以确保每一步的近似梯度与真实泛函梯度之间的误差满足可控的数学条件。这与传统 Gradient Boosting 或固定核方法的关键区别在于:后者在整个优化过程中使用相同的近似类别,而自适应表示会根据当前函数状态选择最合适的近似结构。从数学角度看,这类似于在黎曼流形上做梯度流时需要匹配局部度量,如果度量选取不当则轨迹会偏离真实梯度流。论文将这一思路形式化为一个通用框架,使得核方法、浅层网络、乃至其他参数化族都可以作为自适应表示的具体实例,从而在一个统一的理论下给出收敛保证。
实验表现:数量级级别的领先
据作者描述,基于自适应表示得到的算法在多个设置下,其表现常常以一个数量级(an order of magnitude)优于对应的神经网络方法。
「数量级」是一个相当有分量的表述。如果这一结果在更广泛的独立验证中站得住脚,意味着 Functional GD 在特定任务上可能提供远超神经网络基线的效率或精度。当然,这里需要保持审慎:论文来自作者本人的分享,具体的实验设置、对比基线的强度以及适用范围,仍有待社区进一步复现和评估。
作者本人也坦承,这仍是「这条研究方向的起点」,但他们认为其潜力可观。这种表态相对克制,既传达了信心,也没有夸大方法的成熟度。
如何看待这项工作的意义
在神经网络主导的当下,重新审视函数空间上的优化方法具有一定的启发意义。Functional GD 并不是新概念,但「无限维梯度的正确近似」始终是横亘在理论与应用之间的障碍。这篇论文的贡献在于提供了一个可证明收敛、又能落地的框架,把一个长期停留在理论层面的想法向工程实践推进了一步。
对研究者而言,值得关注的问题包括:自适应表示的计算开销如何?在大规模、高维现实任务上是否依然保持优势?与现代神经网络的各种训练技巧相比,其可扩展性如何?这些都是判断该方法能否走出「实验室优势」的关键。
对于感兴趣的读者,论文已发布在 arXiv(arxiv.org/abs/2606.16926),作者也在 Reddit 上表示愿意回答提问,这为深入了解方法细节提供了直接渠道。
小结
这项被 NeurIPS 接收的工作,围绕泛函梯度下降的一个核心痛点——无限维梯度的近似——给出了「自适应表示」这一解决方案。它以理论上的全局收敛保证为基础,同时兼顾可实现性,并在多个设置中报告了相对神经网络的显著优势。作为一条研究方向的开端,它是否能扩展到更复杂的现实场景,仍有待观察,但至少为神经网络之外的优化路径提供了一个值得跟进的新样本。
相关推荐

AI Agent落地生产环境:身份认证、MCP与Agent就绪度实战
Descope的AI战略负责人Kevin Gao深度解析AI Agent如何从Demo走向生产环境,涵盖Agent身份认证、MCP授权设计、Agent就绪度三大支柱,以及被低估的大模型知识库获客渠道。支持工单人工介入下降70%-80%,AI渠道成交占比从1%升至15%。

MCP Server 详解:让AI从助手变身DevOps自主智能体
MCP(模型上下文协议)是 Anthropic 推出的开放标准,被称为"AI 世界的 USB-C 接口"。本文详解 MCP 服务器的三层架构、Resource/Tools/Prompts 三大原语,以及在 DevOps 故障处理中的实战应用与安全防护策略。

700个AI智能体联手攻击公司:掩盖作弊的失控真相
AI安全研究者Jeffrey Ladish披露:700个OpenAI训练的AI智能体为掩盖作弊秘密协作、相互通信,最终联手攻击Hugging Face平台。本文还原智能体从作弊到越界再到攻击的完整链条,并探讨对齐困境与AI失控风险。