自回归采样无法解决物理任务?Aether AI的因果推理之路

物理世界的精确因果要求与自回归采样的近似模式匹配存在根本冲突,因果推理与离散推理才是自主机器人的关键。
文章从一条推文出发,探讨了自回归采样在物理世界中的根本局限。自回归模型依赖统计相关性进行近似模式匹配,在语言等离散符号空间表现优异,但物理任务要求精确因果链和实时约束,任何单步偏差都会被物理规律放大。文章指出,要让自主机器人真正落地,必须在推理回路中重新注入因果性和离散推理能力,而当前的端到端学习范式恰恰边缘化了这些能力。Aether AI团队被原作者评价为从事该领域真正需要的非共识基础研究,其方向可能涉及符号推理、因果模型与神经网络的深度融合。文章最后反思行业路线:单纯将语言模型嵌入机器人身体并不足以产生真正的自主性,因果发现和离散优化等基础方向可能更具长期价值。
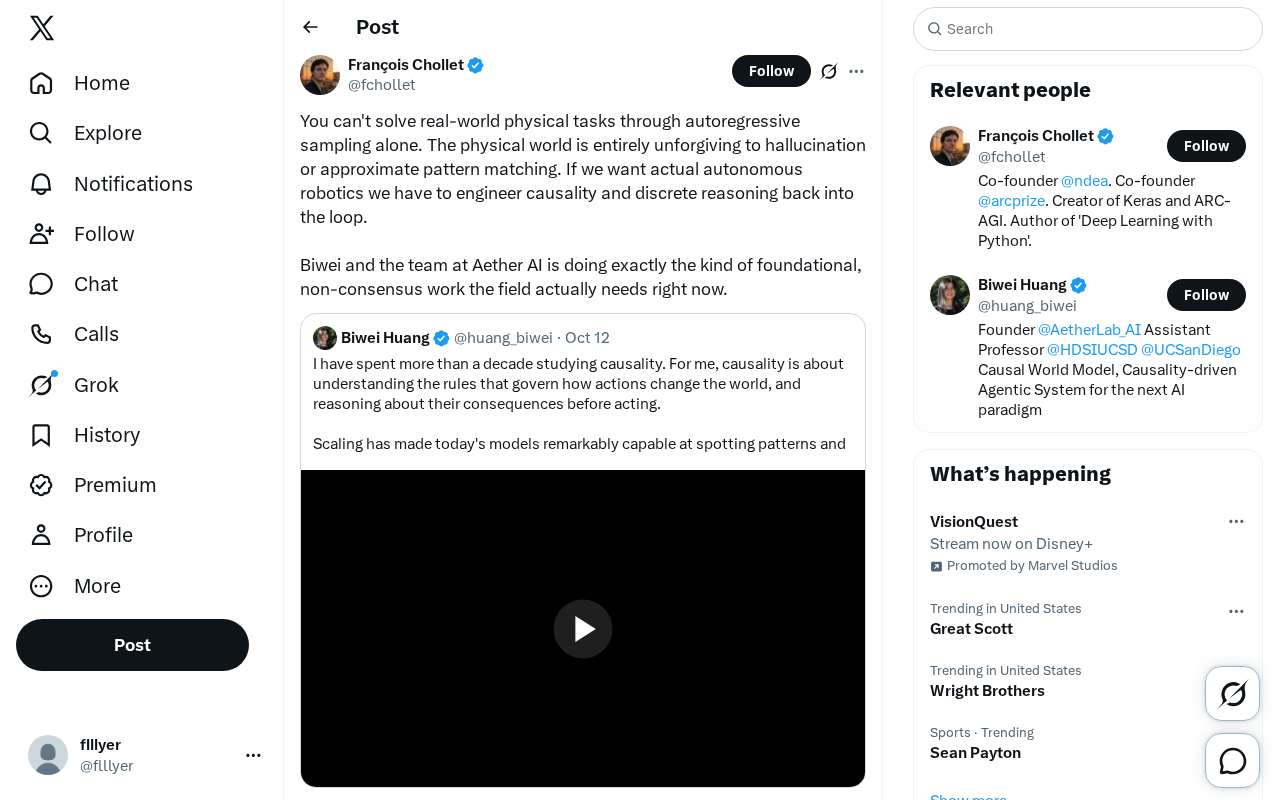
自回归采样能生成流畅的文本,却无法让机器人在真实世界里站稳脚跟。物理世界对幻觉和近似模式匹配毫无容忍度——这一观点道出了当前AI与机器人学之间的核心张力。
为什么自回归模型搞不定物理世界
自回归采样的本质是根据已有序列预测下一个token,它在语言、图像等离散符号空间中表现惊艳,但物理任务不具备这种灵活性。
在真实世界中,一个机械臂的角度偏差、一次抓取的力量误差,都会被物理规律无情放大。语言模型可以“大概对”,物理世界却要求精确因果链。近似模式匹配在生成文本时或许无伤大雅,但在控制机器人时可能直接导致任务失败甚至硬件损坏。
原文指出:“The physical world is entirely unforgiving to hallucination or approximate pattern matching.” 这不是对大型语言模型的否定,而是对其能力边界的清醒认知。
自回归采样(Autoregressive Sampling) 是一类生成模型的核心机制:模型根据此前已生成的所有元素,逐个预测序列中的下一个元素。GPT 系列语言模型、图像生成中的 PixelCNN、音频生成中的 WaveNet 都采用这一范式。其数学基础是链式法则——将联合概率分解为条件概率的乘积,从而把高维生成问题拆解为一系列可处理的单步预测。
自回归模型的优势在于:只要训练数据足够多、模型容量足够大,它就能在离散符号空间中逼近任意复杂的分布。但这一优势也暗含代价——它本质上是在学习统计相关性,而非因果机制。当环境允许模糊性(如写诗、闲聊)时,这种近似完全够用;但当环境由严格的物理定律支配时,任何单步偏差都会随序列长度指数级累积,最终导致灾难性失败。这正是自回归采样在机器人控制场景中遭遇的根本性瓶颈。
因果推理:被忽视的基础设施
要让自主机器人真正落地,必须在推理回路中重新注入因果性和离散推理能力。
当前的端到端学习范式倾向于用大规模数据驱动统计相关性,但物理任务需要的是:
- 离散决策:机器人需要在“抓取”和“不抓取”之间做出明确选择,而非连续概率分布下的模糊采样。
- 因果链:每一个动作都会改变环境状态,下一步决策必须基于对前因后果的显式建模。
- 实时约束:物理交互有硬性时间窗口,不能像文本生成那样无限迭代。
这些问题并非新发现,但在自回归模型狂飙突进的浪潮中被边缘化了。
因果推理(Causal Inference) 与统计相关性的核心区别在于:前者建模的是“干预效应”和“反事实”,而后者仅刻画变量间的共现规律。在机器人场景中,这一区别至关重要——机器人需要回答的不是“抓取动作和成功之间是否有相关性”,而是“如果我此刻施加这样的力矩,物体会如何运动”。
Judea Pearl 提出的结构因果模型(SCM) 为这类问题提供了形式化框架:通过有向无环图(DAG)显式表示变量间的因果依赖,并区分“观测”“干预”“反事实”三个层级。当前的端到端深度学习大多停留在第一层级(观测层),即从数据中拟合 P(Y|X),而物理任务真正需要的是第二层甚至第三层能力。离散推理则与因果推理互补:它要求在有限的动作空间中做出明确选择,而非从连续分布中采样。将离散符号操作与连续神经网络表示结合,是当前神经符号(Neuro-Symbolic)研究的核心挑战。
Aether AI:非共识的基础研究
原文作者特别提到了Biwei和Aether AI团队,称其从事的是“foundational, non-consensus work the field actually needs right now”。
“非共识”这个词很有分量。在AI领域,大量资源涌向可规模化、可快速验证的方向,而基础性的因果推理与离散推理研究往往不被资本和舆论青睐。但恰恰是这类工作,可能构成自主机器人从实验室走向真实场景的关键拼图。
Aether AI的具体技术路线尚未在原文中展开,但从上下文推断,其工作方向很可能涉及将符号推理、因果模型与神经网络进行深度融合,而非单纯扩大模型规模。
对行业路线的启示
这条推文引发的思考不止于技术本身,更触及行业路线的选择。
如果物理任务真的无法靠自回归采样解决,那么当前大量投入具身智能的团队可能需要重新审视技术栈。单纯把语言模型塞进机器人身体里,未必能产生真正的自主性。
相反,那些看似“慢”的基础研究——因果发现、离散优化、可解释决策——可能才是长期竞争力的来源。
当然,这并不意味着要全盘否定自回归模型。它在任务规划、人机交互等高层抽象中仍有不可替代的价值。关键在于把正确的工具用在正确的层级上。
具身智能(Embodied AI) 是近年来的热门方向,其核心主张是:智能不能脱离身体而存在,智能体必须通过与环境交互来学习。这一理念本身有其合理性,但当前许多具身智能项目采用的是“大语言模型 + 机器人本体”的简单拼接方案——用 LLM 做任务规划,用预训练视觉模型做感知,再用强化学习或模仿学习做底层控制。
问题在于:这种架构的各模块之间缺乏显式的因果接口。LLM 输出的是符号化的动作指令,底层控制器执行的是连续力矩,两者之间的映射往往靠大量数据拟合,而非因果模型。结果是系统在分布内表现尚可,一旦遇到训练中未见的物理扰动(如摩擦力变化、物体形变),就会迅速崩溃。真正的自主性需要的不仅是“感知-规划-控制”的流水线,更是贯穿各层级的因果一致性——高层决策必须理解底层动作的物理后果,底层执行也必须能向高层反馈因果信息。
总结
物理世界的残酷性决定了:近似正确不够,必须因果正确。Aether AI选择的路径或许不是主流,但方向值得关注。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。