字节阿里腾讯豪掷350亿美元采购英伟达芯片,中国AI算力军备竞赛升级

字节、阿里、腾讯向英伟达下单超350亿美元芯片,算力焦虑蔓延至头部大厂。
Reddit 爆料称字节跳动、阿里巴巴、腾讯合计向英伟达下达超 350 亿美元的 AI 芯片订单,刷新中国企业采购纪录,折射出大模型竞赛白热化后算力焦虑已从创业公司蔓延至头部大厂。文章分析,大厂难以转向国产芯片的核心原因是 CUDA 软件生态的锁定效应与切换成本,加上大模型迭代速度对时间窗口的刚性要求。这笔订单将带来三重影响:挤压中小 AI 公司生存空间、收窄云服务降价空间、使推理优化技术成为新竞争焦点。文章最后指出,硬件到位后的集群调度与工程能力才是真正考验,而订单争取到的时间窗口内国产芯片生态能否跟上,将决定长期格局。
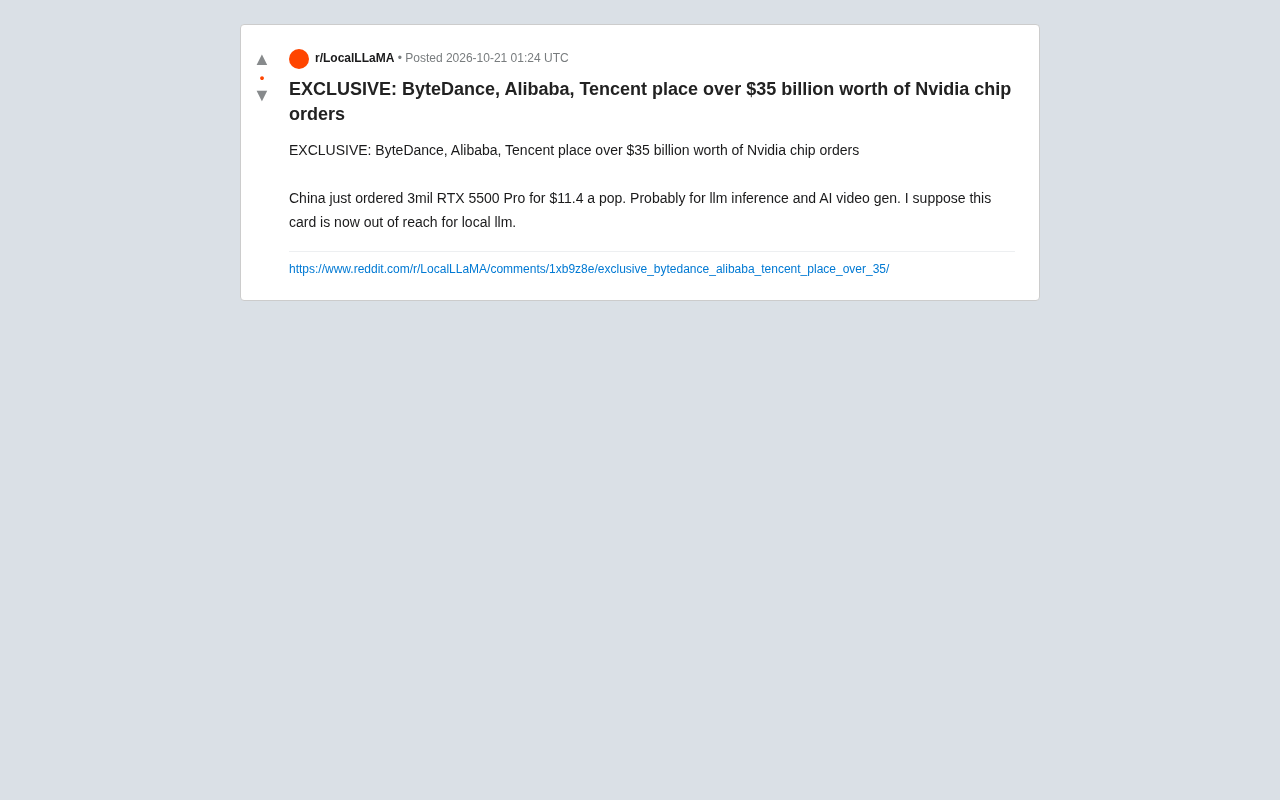
据Reddit网友爆料,字节跳动、阿里巴巴、腾讯三家中国科技巨头已向英伟达下达总价值超过350亿美元的芯片订单。这一数字不仅刷新了中国企业单次采购AI芯片的纪录,也折射出国内大模型竞赛进入白热化阶段后,算力焦虑正在从创业公司蔓延至头部大厂。
350亿美元订单背后的算力逻辑
350亿美元是什么概念?按照英伟达高端GPU的单价粗略估算,这笔订单对应的芯片数量可能在数十万片级别。考虑到美国出口管制对高端芯片型号的限制,实际交付的可能是合规特供版本,但即便如此,总价值依然惊人。
Reddit原帖中有一条评论值得玩味:“中国刚以每片11.4美元的价格订购了300万片RTX 5500 Pro,大概用于LLM推理和AI视频生成。这张卡现在本地跑LLM怕是买不到了。”这条评论虽然带有调侃成分,但点出了一个关键趋势:推理侧的算力需求正在爆发。训练大模型需要成千上万张高端卡,而推理——尤其是面向C端的大规模推理——对芯片的数量需求同样庞大,只是单卡性能要求相对低一些。
字节跳动的豆包、阿里的通义千问广告、腾讯的混元,都在过去一年里疯狂扩张用户规模。每一次对话、每一帧AI生成视频,背后都是实打实的GPU算力消耗。350亿美元订单的本质,是为下一阶段的用户增长提前囤积弹药。
训练与推理的算力差异值得展开说明。训练是指用海量数据调整模型参数的过程,需要多卡高速互联、长时间稳定运行,对单卡算力和显存带宽要求极高;推理则是模型训练完成后响应用户请求的过程,单次计算量小但请求量巨大,更看重吞吐量、延迟和单位成本。一个模型的训练可能只需一次投入数千张高端卡,但支撑其面向数亿用户的日常调用,反而需要持续扩充数量更多的中低端推理卡。这正是订单中大量采购推理型芯片、甚至消费级显卡被扫货的原因——推理侧的算力消耗是随用户规模线性甚至指数增长的持续性支出。
为什么是英伟达,而不是国产替代
一个自然的问题是:在美国出口管制持续收紧的背景下,为什么中国大厂还要把如此巨额的资金投向英伟达?
答案藏在软件生态里。CUDA经过十余年积累,已经成为AI开发的事实标准。从PyTorch到TensorRT,从分布式训练框架到推理优化工具链,绝大多数AI工程实践都围绕CUDA生态构建。国产芯片在硬件参数上追赶的速度不慢,但软件栈的成熟度、算子库的丰富程度、社区文档的完善度,差距仍然明显。
对于字节、阿里、腾讯这个体量的公司来说,切换芯片架构意味着整个AI基础设施的重构成本。模型代码要重写、训练脚本要适配、推理服务要重新调优,这些隐性成本在短期内可能比芯片本身的差价更高。所以只要合规渠道还能买到英伟达芯片——哪怕是性能缩水版——大厂的首选仍然是英伟达。
另一个不容忽视的因素是时间窗口。大模型竞争的核心变量之一是迭代速度,谁能在更短时间内完成更多轮训练和推理优化,谁就有机会抢占市场。等待国产芯片生态成熟需要时间,而大厂等不起。
CUDA 是什么? CUDA(Compute Unified Device Architecture)是英伟达自 2006 年起推出的并行计算平台与编程模型,允许开发者用 C/C++ 等语言直接调用 GPU 的数千个计算核心。它不只是一个驱动接口,而是一整套包含编译器(NVCC)、数学库(cuBLAS、cuDNN)、通信库(NCCL)和性能分析工具的软件栈。深度学习框架 PyTorch、TensorFlow 的 GPU 加速后端,本质上都是构建在 CUDA 之上的。这种"硬件+软件+社区"的三位一体结构,使开发者的代码、调优经验和知识积累全部沉淀在 CUDA 生态中,形成极高的迁移壁垒——这也是文中"锁定效应"的技术根源。
合规特供版芯片指英伟达为满足美国出口管制要求,专门面向中国市场推出的性能削减型号(如此前的 A800、H800,以及后续的 H20 等)。这些芯片通过降低互联带宽或算力密度来规避管制阈值,单卡性能弱于国际版,但软件生态完全兼容,因此仍是中国大厂在合规前提下能获得的最优选择。
对行业格局的三个影响
第一,中小AI公司的生存空间进一步收窄。 当头部大厂以百亿美元级别囤积算力时,创业公司能拿到的芯片资源和议价能力都会被压缩。Reddit评论中“这张卡现在本地跑LLM怕是买不到了”的调侃,某种程度上正是这种挤压效应的缩影——连消费级显卡都被扫货,专业级芯片的争夺只会更激烈。
第二,云服务价格战可能放缓。 过去一年,阿里云、腾讯云广告、火山引擎纷纷下调AI推理价格,部分模型API的定价甚至低于成本线。但这种补贴策略的前提是算力成本可控。350亿美元的资本开支摆在那里,云厂商迟早需要回收成本,持续降价的空间正在缩小。
第三,推理优化技术会成为新的竞争焦点。 既然芯片数量短期内受限于供应,那就从软件层面榨取更多效率。量化、蒸馏、投机解码、KV Cache优化——这些推理加速技术的重要性会进一步上升。谁能用更少的卡跑出更高的吞吐,谁就能在成本曲线上占据优势。
推理优化技术的具体含义: 量化(Quantization)指用更低精度(如 FP8、INT8、INT4)表示模型权重和激活值,在几乎不损失效果的前提下大幅降低显存占用和计算量;蒸馏(Distillation)是用大模型指导小模型训练,让小模型以更低成本逼近大模型能力;投机解码(Speculative Decoding)先用小模型快速草拟多个 token,再由大模型并行验证,从而加速生成;KV Cache 优化则针对自回归生成中反复使用的键值缓存进行压缩、分页或复用,减少显存浪费。这些技术的共同目标,是在芯片数量受限时用软件手段提升单位算力的有效吞吐,直接决定推理服务的成本曲线。
算力囤积之后,真正的考验才开始
350亿美元的芯片订单只是起点。硬件到位之后,如何把这些算力高效地组织起来、调度起来,才是更难的题目。大规模GPU集群的互联带宽、故障恢复、任务调度、能耗管理,每一项都是工程挑战。
更长远地看,中国AI产业不可能永远依赖进口芯片。这笔订单争取到的是时间窗口,而窗口期内国产芯片生态能否缩小差距,才是决定下一个十年格局的关键变量。对字节、阿里、腾讯来说,一边用英伟达芯片支撑当下的业务增长,一边扶持国产算力生态,两条腿走路的策略恐怕还要持续相当长一段时间。
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。