自托管Whispersync:让电子书与有声书进度自动同步
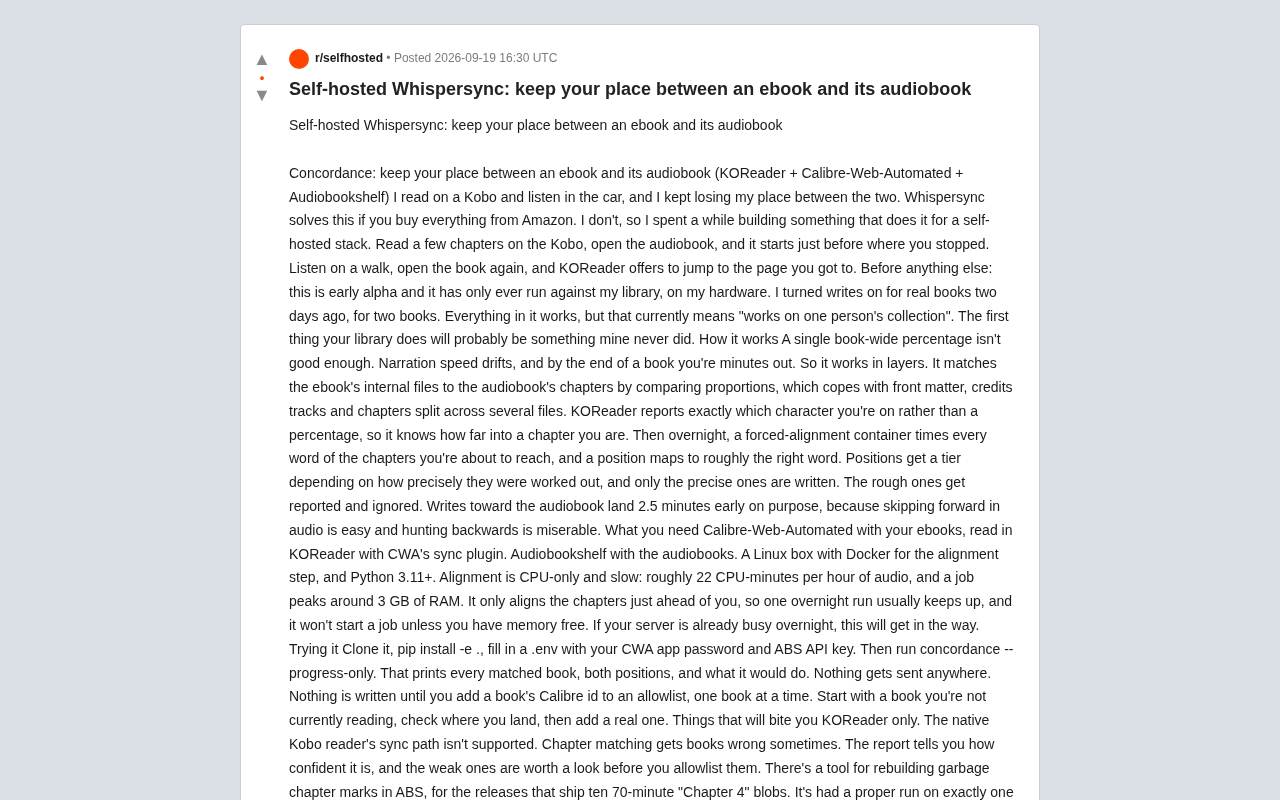
开源项目Concordance为KOReader+Calibre-Web+Audiobookshelf自托管书栈提供电子书与有声书双向进度同步,替代亚马逊Whispersync。
Concordance是一个处于早期alpha阶段的开源项目,旨在为自托管读者解决电子书与有声书进度无法互通的痛点——这是亚马逊Whispersync生态之外长期缺失的能力。它将KOReader、Calibre-Web-Automated和Audiobookshelf三个工具串联,通过章节比例匹配、字符级定位和夜间强制对齐三层策略,将阅读位置精确映射到音频时间轴,并通过精度分级机制确保只有足够可信的对齐结果才会真正写入。部署需要Docker环境,对齐步骤纯CPU运算,每小时音频约耗22 CPU分钟、峰值内存3GB。项目提供`--progress-only`只读预览和逐本白名单机制供谨慎上手,当前主要征集不同书库的测试反馈。
在电子书和有声书之间来回切换阅读的人,大概都遇到过同一个痛点:在Kobo上读了几章,上车换成有声书,却不知道该从哪儿接着听。亚马逊的Whispersync能解决这个问题,前提是你所有的书都从亚马逊购买。对于坚持自托管、不依赖单一生态的读者来说,这条路一直走不通。
一位Reddit用户开源了名为 Concordance 的项目,专门为自托管书籍栈打造进度同步能力。它把 KOReader、Calibre-Web-Automated(CWA)和 Audiobookshelf(ABS)三者串联起来,实现电子书与有声书之间的双向进度对齐。
它解决了什么问题
作者的使用场景很典型:在Kobo上阅读,开车时听有声书。两套系统各自记录进度,互不相通,结果就是频繁「丢失阅读位置」。
Concordance 的目标是让这个过程无感衔接——在Kobo上读完几章,打开有声书,它会从你停下位置的稍前一点开始播放;散步时听了一段,再翻开电子书,KOReader 会提示你跳转到对应页面。
需要强调的是,作者本人明确将其定位为 早期 alpha 版本。目前它只在作者自己的书库、自己的硬件上运行过,真正开启「写入」功能也仅两天、仅两本书。用他自己的话说:「一切功能都能用,但目前意味着『在一个人的收藏上能用』。」这是一份诚实到少见的项目自述。
亚马逊的 Whispersync for Voice 自2011年推出,允许用户在 Kindle 电子书与 Audible 有声书之间无缝切换,进度在云端实时同步。这一功能的实现前提是:电子书与有声书均从亚马逊平台购买,且两个版本由亚马逊在后台做了专门的文本-音频对齐标注。对于购买 DRM-free 电子书、从图书馆借阅、或自行导入 Calibre 管理书库的用户,Whispersync 完全不可用。自托管社区长期依赖 KOReader、Calibre 及 Audiobookshelf 等开源工具管理书库,但这些工具各自独立,进度数据格式和存储位置均不互通,Concordance 试图在不依赖任何商业平台的前提下补上这块空白。
分层对齐:为什么单一百分比不够
项目的技术核心在于对齐精度。作者指出,用一个「整本书的百分比」来做映射远远不够——朗读语速会漂移,到全书结尾时误差可能累积到好几分钟。
Concordance 采用分层策略来解决这一问题:
章节比例匹配
它先通过比较比例,把电子书的内部文件与有声书的章节对应起来。这套机制能应对前置内容(front matter)、制作人员致谢音轨,以及一个章节被拆分到多个文件的情况。
字符级定位
KOReader 报告的是你当前所处的具体字符位置,而非笼统的百分比,因此系统能精确知道你读到了某一章的多深处。
强制对齐(Forced Alignment)
夜间运行时,一个强制对齐容器会为你即将读到的章节逐词计时,再把阅读位置映射到大致对应的词。每个映射结果会根据计算精度获得不同的「层级」,只有足够精确的位置才会真正写入,粗糙的结果仅作报告、不会采用。
值得一提的一个体贴设计:写入有声书进度时,会故意提前 2.5 分钟落点。因为在音频里向前快进很容易,而往回找位置的体验则相当糟糕。
强制对齐(Forced Alignment)是语音处理领域的一项经典技术,其核心任务是:给定一段音频和对应的文本转录,自动计算出每个词(乃至每个音素)在音频时间轴上的精确起止时间戳。它与语音识别(ASR)的方向相反——ASR是「听音频、猜文字」,强制对齐则是「已知文字、找时间」,因此通常比ASR更快、更准。实现上通常依赖隐马尔可夫模型(HMM)或近年基于Transformer的声学模型(如 Montreal Forced Aligner、WhisperX 等)。在 Concordance 的场景里,文本来源是电子书的章节内容,音频来源是对应有声书章节,强制对齐引擎负责把「你读到了第N个字符」这个信息翻译成「有声书里第X分X秒」。这也解释了为什么计算开销较高——模型需要逐帧分析音频的声学特征,再与文本序列做对齐,属于计算密集型操作。
朗读语速漂移是有声书进度换算中常被忽视的系统性误差来源。专业有声书朗读者在叙事紧张段落与舒缓段落的语速差异可达 20%-30%,加上停顿、重读和编辑剪辑,导致「全书字数/总时长」得出的平均语速与任意局部片段的实际语速之间存在持续偏差。若以全书百分比做线性映射,这些局部偏差会随位置累积而非相互抵消——越靠近书末,换算误差越大。Concordance 选择在章节粒度上重新锚定,再在章节内部做精细对齐,本质上是把一个长距离的线性误差问题拆解为多个短区间的独立问题,每个区间的累积误差被控制在可接受范围内。
部署所需与性能开销
要跑起这套方案,你需要准备:
- Calibre-Web-Automated:存放电子书,通过 CWA 的 sync 插件在 KOReader 中阅读
- Audiobookshelf:存放有声书
- 一台装有 Docker 的 Linux 主机用于对齐步骤,以及 Python 3.11+
对齐环节的开销不容忽视:它是纯 CPU 运算且速度较慢,每小时音频约需 22 CPU分钟,单个任务内存峰值约 3 GB。好在它只对齐你前方即将读到的章节,通常一次夜间运行就能跟上进度,且在内存不足时不会启动任务。如果你的服务器夜里本就繁忙,这套流程可能会形成资源竞争。
谨慎上手:先只读不写
作者设计了相当克制的试用路径,这对早期项目来说是加分项:
克隆仓库后 pip install -e .,在 .env 里填入 CWA 应用密码和 ABS 的 API key,然后运行 concordance --progress-only。这个命令会打印出每一本匹配到的书、两端的进度位置,以及它「打算做什么」——不向任何地方发送数据,也不写入任何内容。
只有当你把某本书的 Calibre id 加入白名单(一次一本)后,才会真正写入。作者建议从一本你当前没在读的书开始,确认落点无误后,再加入真正在读的书。
已知的坑
作者列出了一系列「会咬人」的问题,坦诚程度值得称道:
- 仅支持 KOReader,Kobo 原生阅读器的同步路径不受支持。
- 章节匹配有时会出错。报告会给出置信度,弱匹配的书值得在加入白名单前先人工检查。
- 针对某些把整本书打包成十个「Chapter 4」大块的糟糕有声书发行版,项目提供了重建章节标记的工具,但它「只在一本书上真正跑过」,应用前请先读它的提案,并且有 restore 命令兜底。
- 一次对齐可能整体没问题,却在某一段悄悄出错。这些可疑区间会被拒绝而非信任,因此实际覆盖率会比「这本书已对齐」听起来要更零散。
- 每份配置只支持一个 CWA 用户和一个 ABS 用户。
- 默认对齐模型采用 CC-BY-NC 许可,个人书架没问题,但不可用于商业用途。
项目现状与参与方式
Concordance 采用 MIT 许可,开放 issue 与 PR。作者最需要的帮助,是有人把它指向别人的书库并反馈哪里出了问题——--progress-only 不写任何数据,除了一点 CPU 什么都不花。糟糕的章节匹配和无法配对的书,正是他一个人无从发现的问题。
此外,作者目前是基于 Calibre-Web NextGen 分支开发的,尚未测试原版上游 CWA 是否兼容,也期待社区反馈。他甚至明确表示:「『我试了一下,什么都没发生』也是一个真正有用的 bug 报告。」
对于长期在自托管生态里折腾电子书与有声书的爱好者,Concordance 提供了一个此前几乎空白领域的解法。它现在还很粗糙,但技术思路——分层对齐、字符级定位、精度分级写入、只读预览——都相当扎实。如果你正好用着 KOReader + CWA + ABS 这套组合,它至少值得用 --progress-only 跑一遍看看。
相关推荐
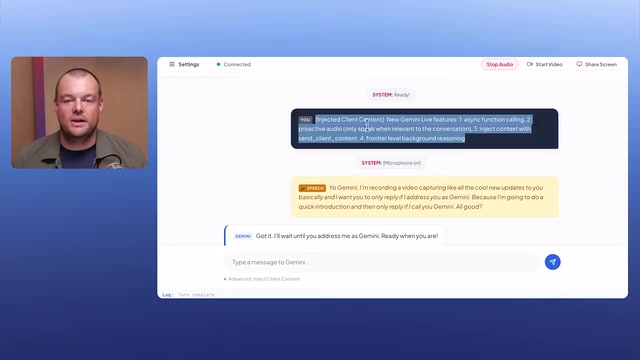
Gemini Live API重磅更新:原生音频首次支持前沿级推理
Gemini Live API迎来重磅更新:主动式音频、上下文注入、异步函数调用四大功能落地,更首次将前沿级高阶推理引入原生音频体验,为语音AI应用带来突破。
陶哲轩:数学不止是证明,我们该如何看待其余部分
菲尔兹奖得主陶哲轩撰文指出,数学远不止于证明,提出问题、构建概念、阐释直觉等工作同样重要却被低估。在AI辅助证明兴起的当下,重新认可这些贡献关乎数学的未来定位。
Vibe Coding实战:培养产品思维,用AI把日常需求变成能变现的APP
Vibe Coding系列教程第二篇,讲解独立开发者如何培养产品思维、从模仿与生活痛点中发现需求,并用AI Agent自动化调研流程,快速判断一个APP创意是否值得投入开发与变现。