自愈式发布:用智能体AI自动修复生产故障
用GitOps+AI智能体实现金丝雀自动分析与自愈,防止小改动酿成全球故障
本文介绍了Red Hat/IBM工程师在KubeCon分享的"自愈式发布"方案,以CrowdStrike全球故障为切入点,指出仅靠CI/CD无法防止小变更引发大灾难。解决方案分为两层:第一层是基于GitOps(Argo CD)的渐进式金丝雀交付,通过指标自动决定放量或回滚;第二层是用Java/Quarkus+LangChain4j构建AI分析智能体,替代Argo Rollouts的静态AnalysisTemplate,以动态方式识别未预见的故障模式。智能体采用并行采集、LLM分析、评分校验的多智能体架构,可驱动即时回滚,并异步生成修复PR或GitHub Issue。演示中成功复现了从注入NPE、触发回滚到自动生成修复PR的完整闭环,整套代码已开源。
从CrowdStrike大故障说起
还记得那次让全球陷入瘫痪的CrowdStrike事件吗?来自Red Hat/IBM的Daniel Oh和Kevin Dubois在KubeCon的分享中,用自己的亲身经历作为开场:当时他们正在柏林参会,故障发生在演讲前五分钟。Kevin的航班直接取消、滞留柏林两三天,Daniel的航班延误六小时。连Starbucks都因为依赖的微软系统崩溃而无法点单。
讽刺的是,这场席卷全球的灾难,根源不过是一次极小的内容更新、一个很小的功能变更。但正是这个微不足道的改动,让整个系统崩溃,恢复正常花了一两周时间。这正是两位讲者抛出的核心命题:仅有CI/CD的交付流水线是不够的,你需要在部署到生产环境之前确保一切正常,更需要在出问题时能自动修复。
渐进式交付:先验证再放量
解决方案的第一层是渐进式交付(Progressive Delivery)。与其把新功能一次性"大爆炸"式推送到所有生产环境,不如采用金丝雀(Canary)的方式逐步放量——先给1%、2%的用户,一切正常再增加到3%、4%,直到全量。一旦发现异常,立即回滚到上一个稳定版本(N-1)。
Kevin特别强调,这整个过程的关键在于自动化。放量、健康检查、继续推进或回滚,全部由系统基于指标和遥测数据自动决策,而不是等用户打来投诉电话后人工回滚。
实现这一切的基础是GitOps。Git作为唯一真实源,不仅管理应用代码(Java、.NET、Python),还管理各种配置文件——Kubernetes的CRD、Service、ConfigMap、Secret等Manifest。这些配置需要从应用中外部化出来,实现松耦合、独立维护。配合Argo CD或Flux,期望状态一旦改变,生产环境就会自动对齐。
不过Argo CD本身是"一次性全量"更新期望状态的,要实现渐进式交付,还需要Argo Rollouts等工具在其之上协同工作。
GitOps是一种以Git仓库为唯一真实来源(Single Source of Truth)的运维范式,由Weaveworks于2017年提出。其核心思想是:所有基础设施和应用的期望状态都以声明式配置文件存储在Git中,任何变更必须通过Git提交(commit/PR)来触发,由自动化系统负责将实际运行状态持续对齐到Git中定义的期望状态。Argo CD和Flux是目前最主流的两款GitOps实现工具,均运行在Kubernetes集群内,持续监听Git仓库变化并自动同步。与传统的"推式"CI/CD不同,GitOps采用"拉式"(Pull-based)架构,由集群内的控制器主动拉取目标状态,这在安全性和审计追踪方面更具优势——每一次生产变更都对应一条可追溯的Git提交记录,回滚也只需git revert。
传统分析模板的局限
Argo Rollouts通过AnalysisTemplate来定义健康检查标准。你可以接入Prometheus等指标源,设定判定条件,比如监控是否出现500、503这类5xx错误。
但问题在于:如果故障不是500错误呢?Kevin指出,传统静态YAML配置只能覆盖你预先想到的场景。为了捕捉各种可能的异常,团队最终要编写大量不同的Prometheus查询,变得越来越棘手。而且手写YAML容易引入人为错误和意料之外的问题。
这正是引入智能体AI的契机——与其不断手写自定义模板和规则,不如让AI以自主、动态的方式去应对那些新出现的、未预见的场景。
Argo Rollouts是Kubernetes上的高级发布控制器,扩展了原生Deployment的能力,原生支持金丝雀发布、蓝绿部署等策略。其中AnalysisTemplate是一种Kubernetes自定义资源(CRD),用于定义发布过程中的健康评估逻辑:你可以指定数据来源(Prometheus、Datadog、Web Hook等)、查询语句、判定阈值和评估频率,Argo Rollouts会周期性运行这些分析,根据结果自动决定继续推进还是回滚。这种机制的优势在于将"什么叫健康"的定义与发布流程解耦,可以版本化管理。但其本质仍是静态规则——所有判断逻辑在部署前就已写死在YAML中,无法在运行时根据新出现的异常模式动态调整,这正是纯规则驱动方案的天花板所在。
用Java和Quarkus构建AI分析智能体
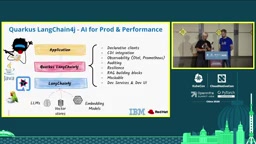
两位讲者做了一个有趣的技术选型:用Java来实现AI智能体系统。很多人会问为什么不用Python,Kevin给出了理由:基于Quarkus的现代Java栈启动快、内存占用极低、吞吐性能优秀;配合LangChain4j(受Python版LangChain启发但相互独立的项目),可以在Java应用中便捷地集成LLM能力,而且在可观测性、指标、安全性等方面更加"企业就绪"。
整个系统被命名为"Kubernetes Agent"。他们在Argo Rollouts中编写了一个轻量插件(用Go实现),通过它调用这个智能体系统。在AnalysisTemplate里,不再使用Prometheus provider,而是改用plugin provider,指向团队创建的argo project metrics AI插件。
配置时只需传入几个参数:哪些Pod是稳定版(作为基线)、哪些是金丝雀版、以及可选的针对特定应用的额外提示词。AI会据此判断金丝雀版本是否与稳定版持平或更优。
LangChain4j是LangChain概念在Java生态中的独立实现(并非官方LangChain的Java移植),提供了与各类LLM交互的统一抽象层,支持OpenAI、Anthropic、本地Ollama等多种后端,同时内置工具调用(Tool Calling)、RAG(检索增强生成)、记忆管理和智能体编排等能力。Quarkus是Red Hat主导的云原生Java框架,其核心优势是将大量框架初始化工作前移到编译期完成,配合GraalVM原生镜像可实现毫秒级启动和极低内存占用,这对需要快速响应的智能体系统尤为重要。相比Python生态,Java方案在企业已有的监控(Micrometer/Prometheus)、安全(Vault集成)、日志规范和依赖审计体系中更容易无缝接入,减少了引入新技术栈的摩擦成本。
智能体工作流:分析、评分与自动修复
整个智能体流程设计得相当精巧:
- 并行采集:多个并行智能体同时收集诊断信息和指标数据(Pod日志、稳定版与金丝雀版的遥测)
- 分析智能体:将汇总数据发给LLM,判断是否存在问题
- 评分智能体:因为LLM有时会"编造"内容,专门引入一个评分智能体对分析质量打分,形成循环校验
- 决策回传:得出"通过/不通过"结论后,同步信号返回给Argo Rollouts,立即回滚或继续放量
Kevin特别提到,这类分析任务不需要庞大的前沿大模型,用一个较小的模型(演示中用的是本地部署的Qwen 3.8)就能胜任,速度也很快。
更进一步,团队把**自动修复(Remediation)**作为异步步骤加入进来。既然LLM已经分析出问题原因,为什么不让它顺手尝试修复?因为生产环境此时已经回滚、故障已经消除,修复过程可以不慌不忙地异步进行:如果是LLM能处理的简单问题,就自动创建一个修复的Pull Request;如果较复杂,则生成一个带详细描述的GitHub Issue交给响应团队。
LLM幻觉(Hallucination)是指大语言模型生成听起来合理但实际上错误或无根据内容的现象,在需要精确判断的工程场景中是重大风险。文中引入独立评分智能体(Scoring Agent)是对抗幻觉的一种实用工程手段——本质上是多智能体互相校验(Multi-agent verification),类似于代码审查中的"四眼原则"。这类设计在智能体系统中也被称为反思循环(Reflection Loop):生成智能体产出初稿,评估智能体给出质量分,若分数不达标则重新提示(re-prompt)并迭代,直到输出满足标准。选用Qwen 3.8B这类小型本地模型而非GPT-4等云端大模型,除了降低延迟和成本外,也回避了将生产日志和敏感指标发送到第三方服务的合规与数据隐私问题,对企业场景尤为重要。
现场演示:从故障注入到自动修复PR

尽管现场网络不太给力,演示还是完整跑通了。Kevin故意提交了一个包含空指针异常(NullPointerException)的新版本镜像,直接推到main分支。
推送后,Argo CD和Argo Rollouts识别到新版本并开始金丝雀放量:90%流量仍走稳定版,10%走金丝雀版。等待10秒后进入分析阶段,智能体开始抓取两个版本的指标和日志。很快分析结果出炉——金丝雀版本的指标虽在阈值内,但日志中反复出现严重的空指针异常,于是决策回滚。流量瞬间切回稳定版。
另一边,后台异步触发修复流程。经过LLM生成、评分智能体校验(质量不够会重新提示并重试),最终在GitHub上创建了一个Pull Request——修复内容是加入空值保护来避免NPE。
值得强调的是,当前方案保留了人在环路(Human in the loop),修复以PR形式提交,由人工审查后再合并。但Kevin也指出,如果足够大胆,完全可以把它做成全自动流程,让系统不断尝试修复、重新发布,直到产出稳定版本。
工程师仍是船长
两位讲者在结尾给出了务实的态度:AI可以自动化越来越多的工作,但你依然是"船上的船长、飞机上的飞行员"。AIOps和智能体AI是辅助者,真正需要你去编排和把控全局。
他们还开源了全部代码:Argo Rollouts的轻量插件(Go)、演示应用、Java智能体系统,以及一键部署整套系统(Argo CD、Rollouts、应用和智能体)的渐进式交付配置(面向OpenShift)。对想用Java构建智能体应用的开发者,他们还准备了专门的workshop。
这套"自愈式发布"方案的价值在于:它把渐进式交付的安全网,与智能体AI的动态分析和自动修复能力结合起来,让下一次"CrowdStrike式"的小改动不至于演变成全球性灾难。
相关推荐

开源英语语法可视化工具:AI断句、精析语法还内置词典
B站UP主WaterBlood开源的英语语法可视化网页工具升级版,支持拍照识别、语法成分着色、两万词内置词典与AI精析长难句,是备考英语阅读的实用学习工具。

Pyrefly:Meta开源的Python静态类型检查利器
Pyrefly是Meta用Rust重写的开源Python静态类型检查器,速度比MyPy快数倍到数十倍,IDE、终端、CI引擎统一。本文详解它如何在运行前捕获类型bug、安装迁移方法及与MyPy的速度实测。

LM Studio 完全教程:本地运行大模型的最佳方式
LM Studio 完整使用教程:从下载安装、按显存挑选模型、量化与上下文优化,到启用兼容 OpenAI 的本地 API 服务器并接入 VS Code。手把手教你在自己电脑上免费运行本地大模型。