Zotero MCP插件:让AI直接读取和分析你的文献库

Zotero MCP插件通过MCP协议打通AI助手与Zotero文献库,实现智能文献检索与分析。
Zotero MCP插件是一个开源项目,通过Anthropic推出的MCP协议将Zotero文献管理器与Claude、ChatGPT等AI助手深度集成。它支持文献检索、PDF全文分析和基于文献库的智能问答三大核心功能,让AI直接访问用户私有文献库,采用RAG技术生成有据可查的回答。插件本地运行,兼顾功能与隐私,代表了AI从通用工具向个人知识助手演进的趋势。
项目概览
做学术研究的人大概都有过这样的经历:一边跟 AI 聊研究思路,一边手动在 Zotero 里翻文献、复制摘要、再粘贴回对话框。窗口来回切换,思路也跟着断了。
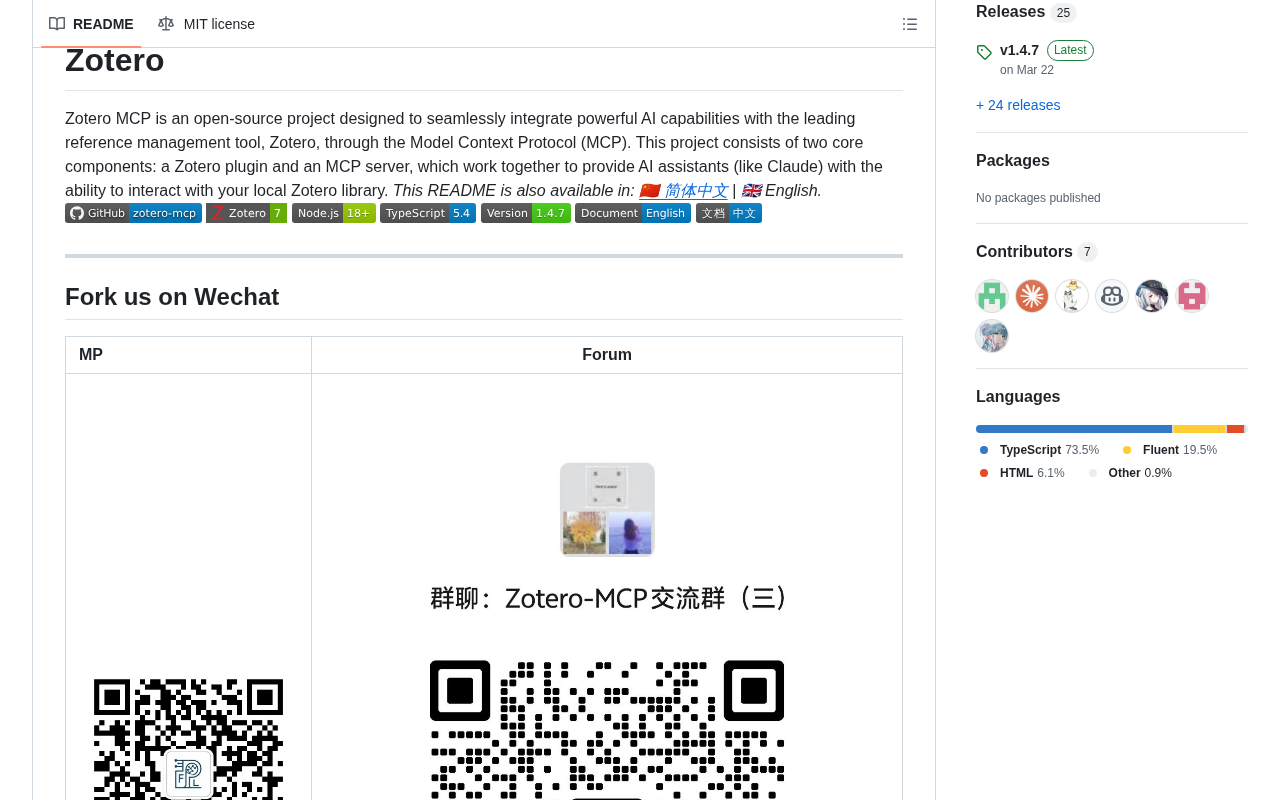
Zotero MCP Plugin(zotero-mcp)就是为了干掉这个多余步骤而做的开源项目。它通过 MCP(Model Context Protocol)协议,把 Zotero 文献管理器和 Claude、ChatGPT 等 AI 助手直接打通——AI 可以主动查你的文献库、读 PDF 全文、回答基于文献的问题,不再需要你当"人肉中转站"。
项目在 GitHub 上已拿到 724 颗 Star,基于 TypeScript 开发,有 57 个 Fork,社区保持着不错的更新节奏。
说到 Zotero 本身,它是由乔治梅森大学数字学术中心(Roy Rosenzweig Center for History and New Media)于 2006 年发起的开源文献管理工具,目前全球用户超过千万。与 EndNote、Mendeley 等商业或半商业竞品不同,Zotero 完全免费且开源,支持浏览器一键抓取文献元数据、自动下载 PDF、生成参考文献格式,并拥有极其活跃的插件生态。正是这种开放架构,使得 Zotero MCP 插件这样的第三方扩展成为可能——如果 Zotero 是一个封闭系统,这种深度集成根本无从谈起。对于学术研究者来说,Zotero 文献库往往是他们最核心的数字资产之一,里面沉淀着数年甚至数十年的阅读积累和研究脉络。
MCP 协议是什么?为什么它很关键?
MCP(Model Context Protocol)是 Anthropic 于 2024 年 11 月正式推出的一项开放协议,目标是给 AI 模型和外部工具之间定一套通用的"对话规则"。有了这套规则,AI 助手就能用统一的方式去调用外部服务——不管是读文件、查数据库,还是操作第三方应用。
要理解 MCP 的价值,需要先看它解决了什么问题。在 MCP 出现之前,如果你想让 ChatGPT 访问你的 Google Drive,让 Claude 查询你的数据库,让其他 AI 工具读取你的本地文件,每一个集成都需要单独开发——不同的 AI 平台有不同的插件规范、不同的 API 格式、不同的认证机制。这就是经典的 M×N 问题:M 个 AI 客户端和 N 个外部工具之间需要 M×N 个适配器。MCP 的做法是在中间插入一层标准协议,把 M×N 降为 M+N——每个 AI 客户端只需实现一次 MCP 客户端,每个外部工具只需实现一次 MCP 服务端,就能互相通信。这与 USB 协议统一了外设接口的逻辑如出一辙。
MCP 的核心架构采用 Host-Client-Server 三层模型:Host 是用户直接交互的 AI 应用(如 Claude Desktop),Client 是 Host 内部负责与外部服务通信的模块,Server 则是暴露具体能力的外部工具端。协议定义了三种核心原语——Tools(工具调用)、Resources(资源读取)和 Prompts(提示模板),覆盖了 AI 与外部世界交互的绝大多数场景。
在 Zotero MCP 插件这个场景里,MCP 协议扮演的是"翻译官"角色:
- AI 助手通过 MCP 协议发出指令(比如"搜索关于深度学习的文献")
- 插件把指令翻译成 Zotero 能理解的操作
- Zotero 执行操作后,插件再把结果按 MCP 格式返回给 AI
这种架构的好处在于解耦——只要 AI 客户端支持 MCP,就能接入 Zotero,不需要针对每个 AI 平台单独开发适配。目前 MCP 生态已经相当丰富,除了 Zotero 之外,社区已经开发了连接 GitHub、Slack、PostgreSQL、文件系统、浏览器自动化等数百个 MCP 服务端,形成了一个快速增长的工具生态。Zotero MCP 插件正是这个生态中面向学术场景的重要一环。
核心功能详解
文献检索与元数据管理
传统流程是这样的:打开 Zotero → 手动输入关键词搜索 → 找到文献 → 复制标题和摘要 → 切回 AI 对话窗口粘贴。四五个步骤,每次都要重复。
装了 Zotero MCP 插件之后,你可以直接在 AI 对话里说"帮我找一下关于深度学习在医学影像中应用的文献",AI 会自动去你的 Zotero 文献库里检索,返回匹配条目的标题、作者、发表年份、摘要等元数据。
关键区别在于:AI 搜的是你自己的文献库,不是泛泛地从网上找。这意味着返回的每一条结果都是你曾经收藏过、读过、或者标注过的文献,相关性远高于通用搜索。
PDF 全文分析
这个功能是真正拉开差距的地方。插件支持让 AI 读取文献附带的 PDF 全文,而不仅仅是标题和摘要。
不过,让 AI 处理学术 PDF 远没有听起来那么简单,背后涉及多个技术挑战。首先是文档解析问题:学术论文的 PDF 格式千差万别,双栏排版、数学公式、表格、图表、脚注、参考文献列表——这些元素的准确提取需要专门的 PDF 解析引擎。简单的文本提取往往会把双栏内容混在一起,或者丢失公式和表格的结构信息。其次是上下文窗口限制:即使是最新的大语言模型,上下文窗口也是有限的(Claude 3.5 约 200K tokens,GPT-4 Turbo 约 128K tokens)。一篇 30 页的论文转换为文本后可能占用数万 tokens,多篇论文同时分析时很容易触及上限。插件需要在完整性和效率之间做取舍,可能采用分块处理、关键段落提取等策略来应对。此外,学术论文中大量的图表和公式属于多模态内容,纯文本提取会丢失这些信息,这也是当前技术的一个局限。
理解了这些挑战之后,你会更清楚这个功能的价值所在。你可以让 AI 做这些事:
- 对一篇 30 页的论文做 500 字的结构化总结
- 提取某篇文献的核心论点和实验方法
- 把两三篇论文放在一起,比较它们在方法论上的异同
- 针对文献中的具体数据或结论提问
对于每天要啃大量论文的博士生和研究员来说,这个功能实实在在地节省阅读时间。
基于文献库的智能问答
这是最能体现 Zotero MCP 插件价值的功能。举个实际场景:
你正在写论文的文献综述部分,需要梳理 Transformer 架构在 NLP 领域的局限性。以前你得自己一篇篇翻文献、做笔记、再整理。现在你可以直接问 AI:"我的文献库中有哪些论文讨论了 Transformer 在 NLP 领域的局限性?主要观点分别是什么?"
AI 会遍历你的文献库,找到相关论文,给出带引用来源的结构化回答。你拿到的不是 AI 编造的内容,而是基于你已有文献的真实总结。
从技术角度看,这个功能本质上是一种 RAG(Retrieval-Augmented Generation,检索增强生成) 的实现。RAG 是当前解决大语言模型"幻觉"问题最主流的技术范式之一,其核心思路是:不让 AI 凭空生成答案,而是先从外部知识库中检索相关内容,再基于检索到的真实材料生成回答。这个过程分为两步——Retrieval(检索) 阶段从文献库中找到与用户问题最相关的文档或段落,Generation(生成) 阶段将检索结果作为上下文输入大模型,由模型组织语言生成最终回答。
在 Zotero MCP 插件的场景中,你的 Zotero 文献库就是 RAG 系统中的外部知识库。与纯大模型生成相比,这种方式有两个关键优势:一是准确性大幅提升,因为每一个论点都有明确的文献来源,而不是模型从训练数据中"记忆"的模糊信息;二是可溯源性,AI 给出的每个结论都可以追溯到具体的论文,你可以回去验证原文,这对学术写作的严谨性至关重要。这也是为什么基于文献库的问答比直接问 ChatGPT "Transformer 有什么局限性"要可靠得多——后者给出的答案你无法验证来源,前者的每一条都锚定在你自己收藏的论文上。
技术架构与安装方式
从技术层面看,Zotero MCP 插件的运行机制并不复杂:
- 插件作为 Zotero 的扩展安装,在本地启动一个 MCP 服务端
- AI 客户端(Claude Desktop、支持 MCP 的 ChatGPT 客户端等)通过 MCP 协议连接这个本地服务端
- 所有数据交互都在本地完成,文献数据不会被上传到第三方服务器
在通信机制上,MCP 协议支持两种传输方式:stdio(标准输入输出) 和 HTTP SSE(Server-Sent Events)。stdio 模式下,AI 客户端直接启动 MCP 服务端进程,通过进程间的标准输入输出流通信,整个过程完全在本地完成,不涉及任何网络端口,安全性最高。HTTP SSE 模式则通过本地 HTTP 服务进行通信,适合需要远程访问或多客户端共享的场景。Zotero MCP 插件通常采用 stdio 模式,这意味着数据连本地网络都不经过,直接在进程间传递。
因为走的是本地通信,响应速度很快,也不用担心文献数据泄露的问题。不过这里需要明确区分两段数据流转路径:第一段是 AI 客户端与 Zotero MCP 服务端之间的通信,这完全在本地完成,你的文献库数据不会离开你的电脑;第二段是 AI 客户端与 AI 服务商云端之间的通信,当 AI 需要基于检索到的文献内容生成回答时,相关的文献片段会作为上下文发送到 AI 服务商的服务器(如 Anthropic 或 OpenAI 的云端)。这一点在学术场景下尤其值得关注——如果你的研究涉及未发表的数据、专利相关内容或保密项目,需要谨慎评估哪些文献内容可以发送给 AI 服务商。
实际使用场景
根据项目文档和社区反馈,以下几个场景的使用频率最高:
- 文献综述写作:让 AI 基于你的文献库梳理某个主题的研究脉络,生成综述初稿框架
- 研究方向探索:问 AI "我的文献库里关于联邦学习的论文主要集中在哪些应用领域?"快速了解自己的阅读覆盖面
- 论文写作中的即时引用:写到某个论点时,直接让 AI 从文献库里找支撑材料,省去手动翻找的时间
- 文献库整理:让 AI 帮忙识别重复收藏的文献、建议分类标签、发现遗漏的重要引用
这个项目代表的趋势
Zotero MCP 插件背后反映的是一个更大的变化:AI 正在从通用问答工具变成个人知识助手。
过去 AI 只能基于训练数据回答问题,答案是"通用的"。现在通过 MCP 这类协议,AI 可以接入用户的私有数据——文献库、笔记、代码仓库、邮件——提供真正跟你个人相关的服务。
这一趋势并非 Zotero 独有,而是整个个人知识管理(PKM, Personal Knowledge Management) 领域正在经历的 AI 化浪潮。Obsidian 社区已经涌现出多个 AI 插件(如 Smart Connections、Copilot),让 AI 基于你的笔记库回答问题;Notion 推出了内置的 Notion AI,可以基于你的工作空间内容生成摘要和回答;Logseq、Roam Research 等工具也在积极探索 AI 集成。但 Zotero MCP 插件有一个独特优势:它连接的是结构化的学术文献数据,而不是松散的笔记文本。每一条 Zotero 记录都包含标准化的元数据(DOI、作者、期刊、发表日期等),这种结构化信息让 AI 的检索和引用更加精准,也更符合学术写作对引用规范的严格要求。
从更宏观的视角看,这代表着 AI 应用正在从"对话即产品"向"嵌入式智能"演进。早期的 AI 产品形态是一个聊天窗口,用户主动提问,AI 被动回答。而 MCP 生态推动的方向是让 AI 能力渗透到用户已有的工作流和工具链中——你不需要离开 Zotero 去找 AI,AI 就在你的工作环境里。这种"AI 来找你"而非"你去找 AI"的模式转变,可能是未来几年 AI 应用层最重要的结构性变化之一。
对学术研究者来说,文献库可能是最有价值的私有知识资产。几百上千篇精心收集的论文,里面沉淀着你多年的研究积累。Zotero MCP 插件做的事情,就是把这些"沉睡"在本地数据库里的知识激活,变成 AI 随时可以调用的上下文。
总结
Zotero MCP 插件精准地解决了一个具体问题:让 AI 助手能直接访问和分析你的 Zotero 文献库。文献检索、全文分析、智能问答这三个核心功能,覆盖了学术研究中最常见的文献处理需求。
如果你同时在用 Zotero 管理文献和 Claude 等 AI 工具辅助研究,这个插件能帮你省掉大量重复性的手动操作。随着 MCP 生态的扩展和更多 AI 客户端的支持,这类打通本地工具与 AI 的插件会越来越多,也会越来越好用。
核心要点
- Zotero MCP 插件通过 MCP 协议实现 AI 助手与 Zotero 文献库的深度集成,支持 Claude、ChatGPT 等主流 AI 工具
- 核心功能涵盖文献检索、元数据管理、全文分析和基于文献库的智能问答,大幅提升学术研究效率
- 插件在本地运行,文献数据无需上传第三方服务器,在功能性与隐私保护之间取得平衡
- 项目已获 724 Star,代表了 AI 从通用对话工具向个人知识助手演进的重要趋势
- 典型应用场景包括文献综述写作、研究方向探索、论文写作辅助和文献整理分类
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。