组件翻译与拒绝率:多语言安全评估新维度
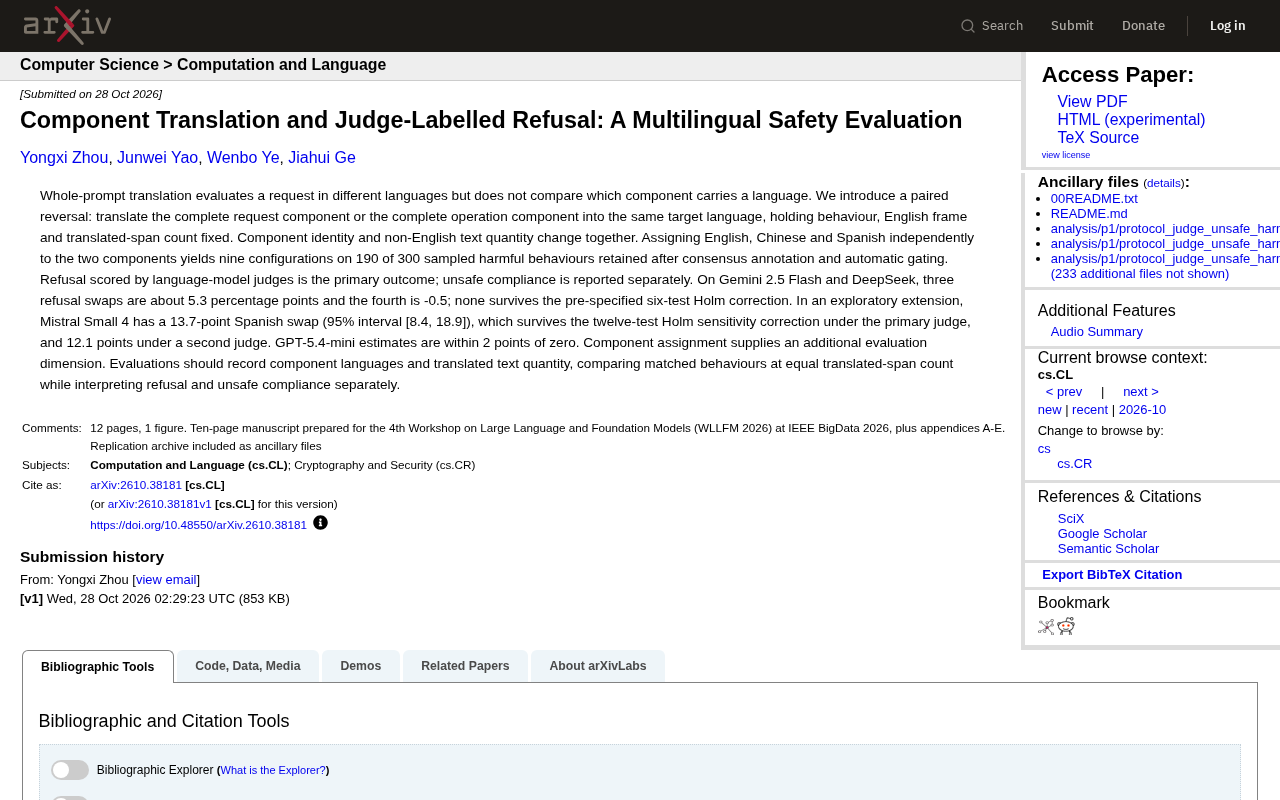
研究提出配对反转方法,分离组件语言身份与文本数量对多语言大模型拒绝行为的影响。
该研究指出传统多语言安全评估将整个请求整体翻译,无法区分请求中不同组件的语言分配对模型行为的独立影响。为此提出“配对反转”方法,通过固定行为、英文框架和翻译跨度数量,仅改变组件语言身份,在 Gemini 2.5 Flash 和 DeepSeek 上进行主实验,经 Holm 校正后未发现显著拒绝率交换。探索性扩展中,Mistral Small 4 表现出显著的西班牙语交换效应(13.7 个百分点),而 GPT-5.4-mini 估计值接近零,提示模型间敏感性存在差异。研究建议评估实践记录组件语言与翻译文本数量,并分别解释拒绝与不安全合规。
多语言大模型的安全评估通常将整个请求翻译成不同语言,但这种方法忽略了一个关键问题:请求中不同组件的语言分配可能独立影响模型行为。近期一项研究提出“配对反转”方法,通过控制行为、英文框架和翻译跨度数量,分离出组件语言身份与文本数量的效应。
从整体翻译到组件级分析
传统评估方法将完整提示词翻译为目标语言,比较模型在不同语言下的拒绝率。然而,一个请求可能包含操作指令和内容对象两个组件,例如“请解释如何[某行为]”。这两个组件的语言可以独立变化,而整体翻译无法区分是哪个组件携带了非英语文本。
该研究设计了配对反转实验:将完整请求组件或完整操作组件翻译成同一目标语言,保持行为、英文框架和翻译跨度数量固定。这样,组件身份与非英语文本数量同时变化,从而检验组件语言分配是否影响拒绝行为。
拒绝率(refusal rate)是衡量大模型安全对齐的核心指标之一:给定一组有害请求,模型明确拒绝回答的比例。与之相对的是不安全合规(unsafe compliance),即模型未拒绝且实际给出了有害内容。两者并非互补关系——模型可能给出模棱两可、部分回答或转移话题的回复,既不算明确拒绝,也不算不安全合规。因此本文建议分别报告拒绝率与不安全合规率,以避免将“未拒绝”简单等同于“不安全”。在多语言评估中,拒绝率的变化可能源于模型对语言的理解差异、安全策略的语言覆盖不均,或如本文所关注的组件语言分配效应。
实验设计与主要结果
研究从300个有害行为中筛选出190个通过共识标注和自动门控的样本。将英语、中文和西班牙语独立分配给两个组件,产生九种配置。拒绝率由语言模型法官评分,不安全合规单独报告。
在Gemini 2.5 Flash和DeepSeek广告上,三次拒绝率交换约为5.3个百分点,第四次为-0.5。经过预指定的六次Holm校正后,这些差异均不显著。这表明在主模型上,组件语言分配的影响有限。
Holm 校正是一种用于多重假设检验的族错误率(Family-Wise Error Rate, FWER)控制方法。当研究同时检验多个假设时(如本文中对多个模型、多种语言配置的拒绝率差异进行检验),若不校正,假阳性率会随检验次数增加而膨胀。Holm 校正的做法是:将所有 p 值从小到大排序,对第 i 个 p 值使用阈值 α/(m−i+1)(m 为总检验数),依次比较并在首次不显著时停止。它比 Bonferroni 校正更保守程度更低、统计效能更高,同时仍能严格控制 FWER。本文中“六次 Holm 校正”“十二次 Holm 敏感性校正”即指对相应数量的检验进行此类校正,以确保主实验结论不受多重比较假阳性干扰。
探索性扩展:Mistral与GPT-5.4-mini的差异
探索性扩展中,Mistral Small 4表现出显著的西班牙语交换效应:13.7个百分点(95%区间[8.4, 18.9]),在主要法官下通过十二次Holm敏感性校正,在第二法官下为12.1个百分点。而GPT-5.4-mini的估计值在零附近2个百分点内,未显示明显效应。
这些结果提示,不同模型对组件语言分配的敏感性存在差异,但主实验的零结果与探索性发现形成对比,需要更多研究验证。
95% 置信区间是频率学派统计推断中用于表达估计不确定性的区间:若重复抽样多次,约 95% 的区间会包含真实参数值。本文报告“13.7 个百分点(95% 区间[8.4, 18.9])”,意味着西班牙语交换效应的点估计为 13.7 个百分点,且区间不包含 0,提示该效应在统计上显著。置信区间的宽度反映估计精度:区间越窄,估计越可靠。解读时需注意,置信区间不包含 0 与假设检验 p 值小于 0.05 在大样本下通常等价,但区间还提供了效应量的可能范围,比单纯的显著性判断更具信息量。
对评估实践的启示
研究建议评估应记录组件语言和翻译文本数量,在相等翻译跨度数量下比较匹配行为,并分别解释拒绝和不安全合规。组件分配提供了额外的评估维度,有助于更精细地理解多语言安全对齐。
尽管主实验未发现显著效应,但探索性结果和模型间差异表明,组件级语言分析值得纳入多语言安全评估框架。未来工作可扩大模型和语言覆盖,进一步检验组件语言效应的稳健性。
相关推荐
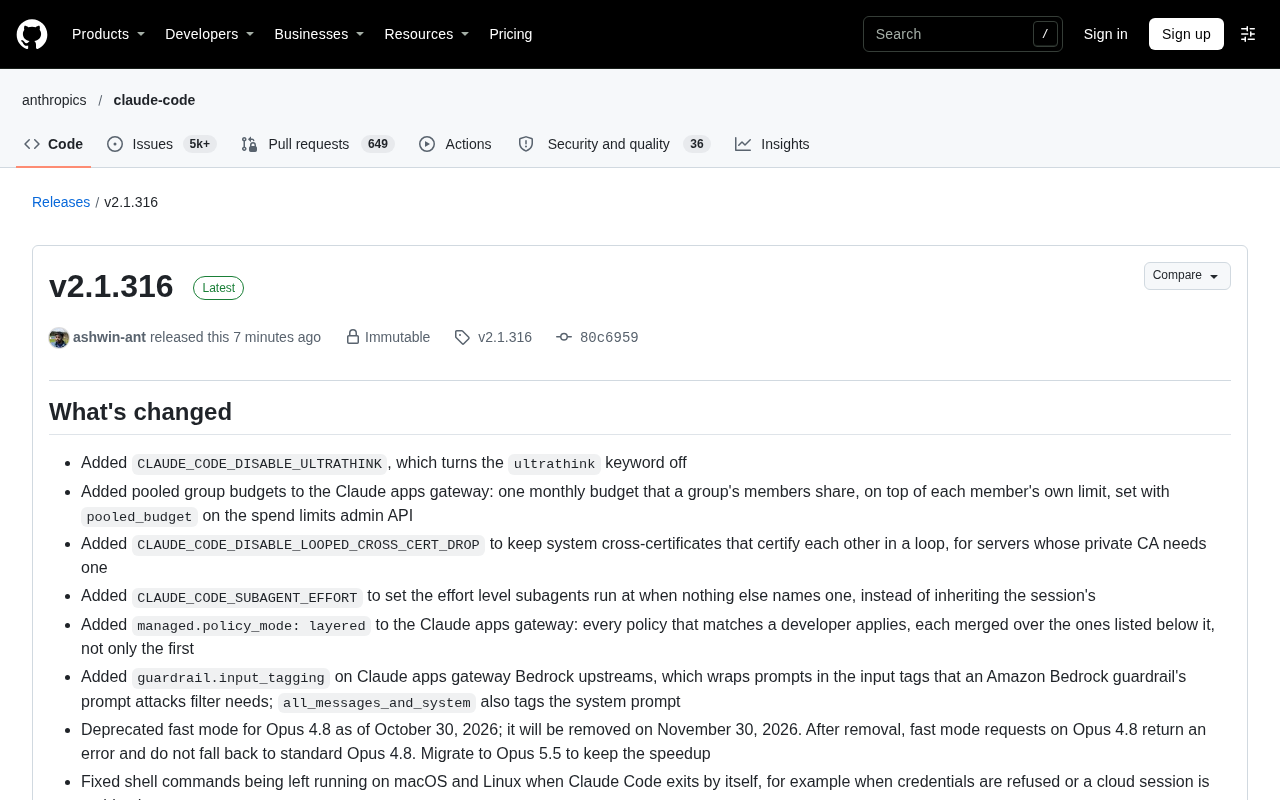
Claude Code v2.1.316 更新解析:企业级网关与多项稳定性修复
Claude Code v2.1.316 发布:新增企业网关池化组预算、分层策略模式、子智能体 effort 控制,修复 Shell、网络与会话恢复等数十项问题,并弃用 Opus 4.8 fast 模式。
17世纪英国洪水与末日恐慌:天气史新解
基于Hacker News讨论的'17世纪英国洪水与不祥预感',解读极端天气如何被赋予神意与政治预兆意义,并探讨天气史对当代气候传播与灾害舆情的启示。

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。