共 1 篇相关文章
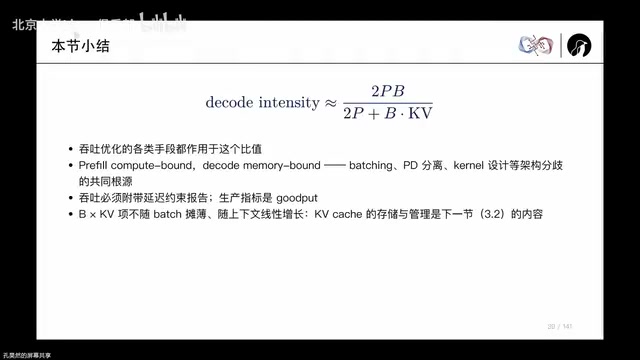
深入解析LLM推理与Serving技术栈:涵盖KV Cache原理、Prefill/Decode两阶段计算形态、PagedAttention、PD分离、EP并行、投机解码等核心机制,剖析大模型推理系统的关键工程权衡与优化思路。