#GPU优化
共 13 篇相关文章
释放Tensor Core性能:机器学习原子间势的GPU加速之道
解析NVIDIA开发者博客关于机器学习原子间势(MLIP)Tensor Core性能优化的思路,涵盖批处理张量对齐、内核融合与混合精度策略,探讨其对分子动力学与AI for Science工作流的意义。

H100 GPU运行Isaac Lab:更优方案探讨
探讨在NVIDIA H100 GPU上运行Isaac Lab的优化方法,包括MIG配置、混合精度、TensorRT加速及社区经验,帮助提升机器人仿真与强化学习效率。

NVIDIA用CUDA Tile加速Mamba-2前向核,状态空间模型推理提速
NVIDIA 开发者博客介绍用 CUDA Tile(cuTile)Python DSL 编写 Mamba-2 高性能前向传播核,通过分块扫描与片上状态驻留提升状态空间模型推理效率,降低核函数开发门槛。

FP8预填充+INT4解码:Hopper上Llama推理新优化
FuTransformer为Hopper GPU上的Llama推理设计分阶段量化:FP8预填充比PyTorch快1.48倍达1.29 PFLOP/s,INT4解码在batch 1-32下比PyTorch BF16/INT4快1.3-2.4倍,Llama-3.1-8B单步解码仅2.8ms。

8GB显卡跑120B Nemotron:跳过零值,找真瓶颈
开发者用8GB RTX 5060运行120B Nemotron-3.5-Super MoE模型,达到8.2 tok/s。核心洞察:按字节每token计算,跳过ReLU²零值,发现真正瓶颈是NVMe读取而非Python开销。
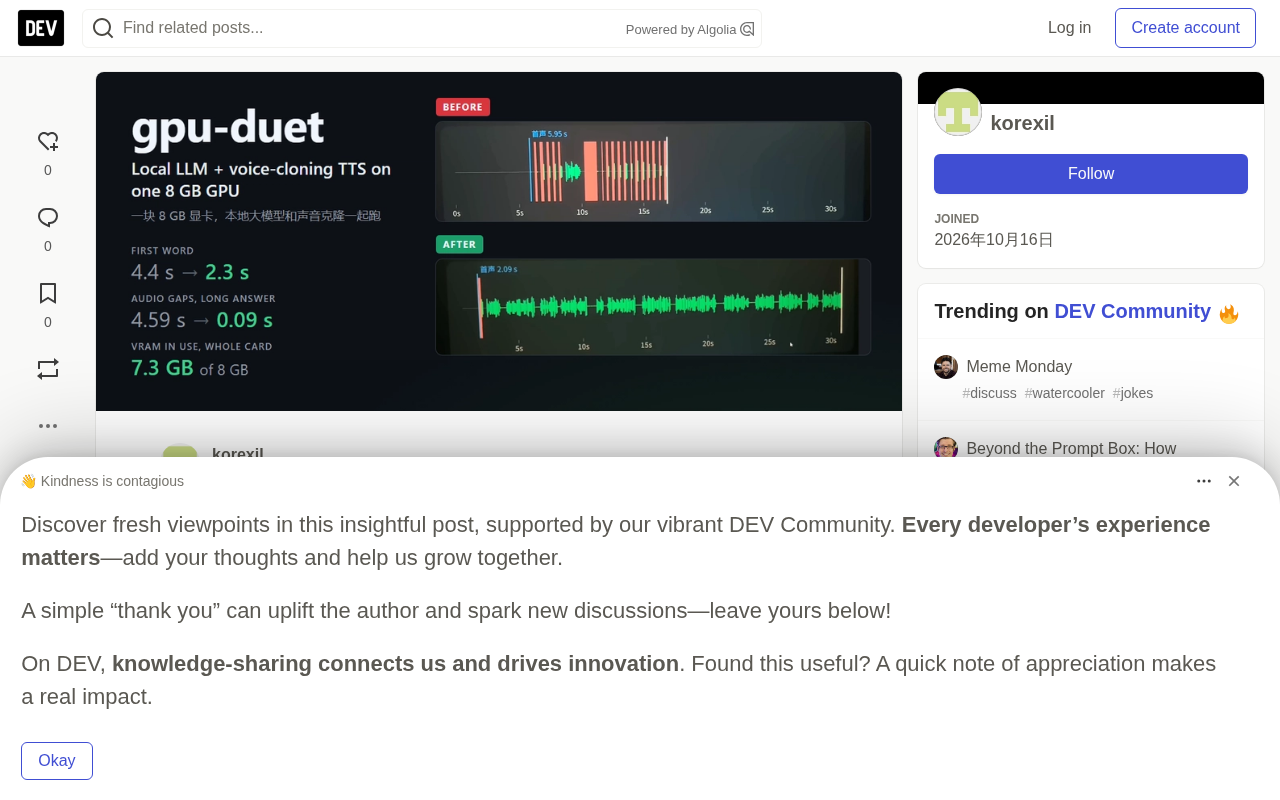
8GB显卡上的本地语音助手:让LLM为TTS让路,消除卡顿
开发者分享在RTX 4060 Laptop 8GB显存上运行本地语音助手的优化经验:让LLM写完一句暂停、TTS全速合成后再继续,首音频延迟从3.9秒降至2.3秒,卡顿从平均2.84秒降至0.09秒,并详细分析GPU资源竞争与显存优化策略。

KernelAgent:多智能体自动优化GPU内核,跨硬件超越专家基线
Meta 推出的 KernelAgent 是一套多智能体 GPU 内核优化框架,能自动编写并优化内核,在 GPU、TPU、AMD 及 Meta 自研 AI 芯片等异构硬件上超越专家基线。本文解析其设计思路与应用价值。
AMD FlyDSL接入TorchInductor:MLIR原生GPU内核新后端
AMD将Python原生、基于MLIR的GPU内核DSL——FlyDSL作为新后端集成进TorchInductor,覆盖GEMM、Group GEMM与Flex Attention。在MI355上,FP16 GEMM较Triton加速约19%,Flex Attention最高达5.8倍。

ERRC:用熵再投资压缩张量并行LLM的GPU通信
PyTorch Ambassador Absalam Bande 提出 ERRC(熵再投资残差修正),通过压缩张量并行 LLM 推理中 GPU 间交换的数据,并用节省的空间补偿量化误差,提升跨 GPU 通信效率。本文解析其核心思路与应用价值。

ThunderKittens移植至NVIDIA Vera Rubin NVL72:NVFP4 GEMM突破22 PFLOPS
ThunderKittens 成功移植至 NVIDIA Vera Rubin NVL72 平台,重构 NVFP4 GEMM 内核后性能从 42% roofline 跃升至超过 22 PFLOPS,与 cuBLAS、CuTe DSL 同台竞技。本文解析其背后的 ISA 变化与低精度 GEMM 优化思路。
低精度FlashAttention-4:Blackwell上的端到端块级缩放注意力
低精度FlashAttention-4(FA4 MX8)将MXFP8块级缩放扩展到注意力的前向与反向传播,在Blackwell架构上实现前向2.85 PF/s、反向2 PF/s的性能,为大模型高效训练与推理提供新路径。
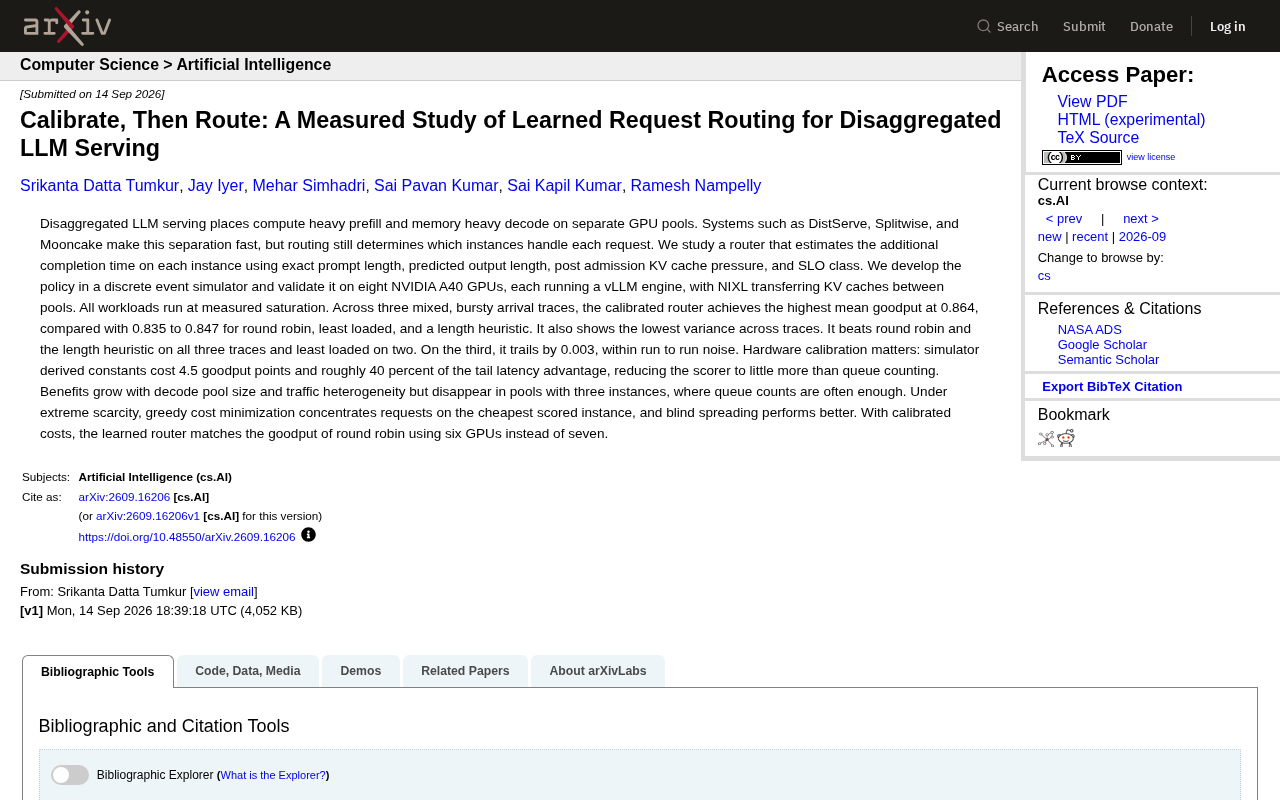
校准后再路由:分离式LLM服务的智能请求调度研究
arXiv 新论文《Calibrate, Then Route》研究分离式 LLM 服务的学习型请求路由。在八块 A40 GPU 实测中,校准后的路由器取得 0.864 的最高 goodput,并能用六块 GPU 达到轮询七块卡的效果。硬件校准是关键。
