#NLP
共 10 篇相关文章

Seq2Seq模型只会预测填充符?常见问题与修复思路
seq2seq模型训练时只预测填充token是新手常见问题。本文分析其根源——损失函数未屏蔽padding、数据失衡,并给出loss masking、teacher forcing等训练与解码层面的修复建议。
分词边界的代价:压缩效率与预测质量的量化博弈
arXiv 最新论文量化分词边界的压缩代价:英文维基上边界规则使 token 数增加 28.3%-36.8%,BPE 比无约束下界高 10.9%。研究还发现压缩与预测偏爱不同词典,并提出边界许可证机制,仅放宽 10% 词表即可恢复绝大部分压缩收益。
文本分类模型演进:从词袋到Transformer的可视化解析
从词袋模型到RNN、CNN与Transformer,本文以可视化视角梳理文本分类模型的技术演进,并深入探讨准确率、效率与校准之间的权衡,帮助开发者做出合理的模型选型。
冷静看待TypeSafe AI的Jev:新架构还是被过度炒作?
TypeSafe AI的Jev被炒作成全新AI形态,但一位资深NLP从业者指出它更像是对现有分类器与语言模型的改进。本文剖析Jev的真实定位、缺失的架构信息,以及为何厂商自评基准需要谨慎看待。
别再删停用词了:一个继承的预处理默认如何扭曲法律文本数据分析
一篇 arXiv 论文通过穷尽式单词消融实验证明:在可解释的法律文本数据分析中,删除停用词不仅无益,反而可能扭曲法理与意识形态信号。保留停用词是测量效度问题。
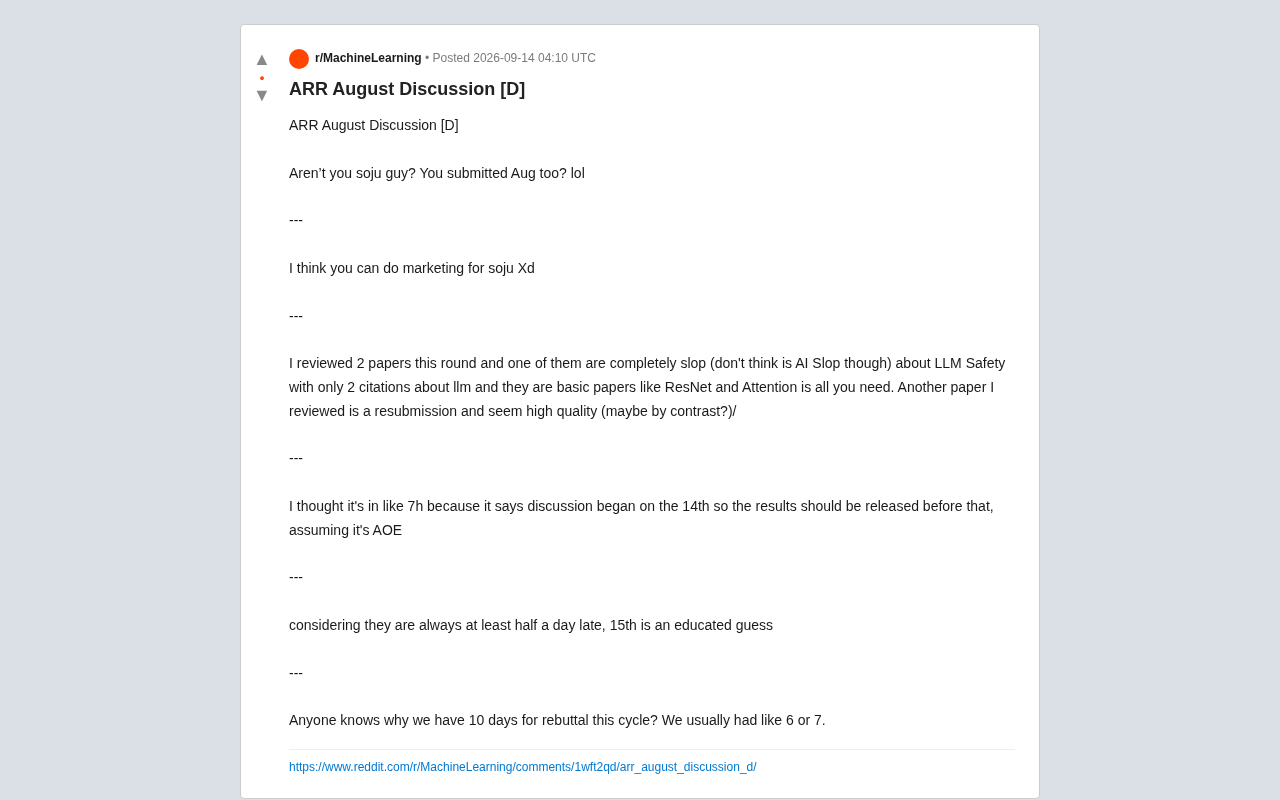
ARR八月周期讨论:审稿质量、结果发布与Rebuttal期变化
ACL Rolling Review(ARR)八月周期社区讨论深度解读:审稿质量两极分化、结果发布时间的不确定性,以及rebuttal答辩期从6-7天延长至10天的流程变化,为NLP领域投稿者提供实用参考。
 教程攻略
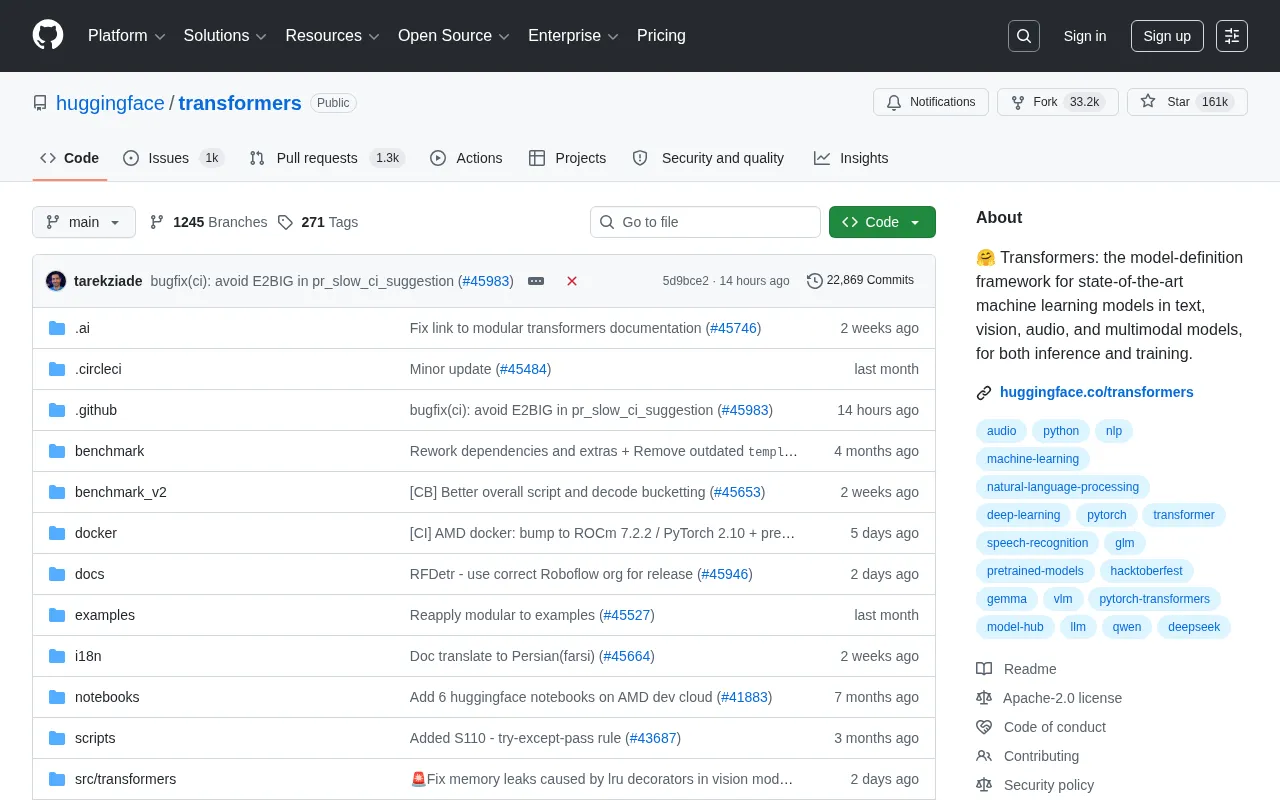
HuggingFace Transformers入门教程:模型下载、Pipeline推理到训练保存
详解HuggingFace Transformers核心用法,涵盖预训练模型下载配置、Pipeline API情感分析实战、Tokenizer分词器原理、模型推理Softmax处理及保存复用完整流程,附Python代码示例。
 教程攻略
Hugging Face Transformers:16万星AI模型框架深度解析与实战指南
深入解析Hugging Face Transformers开源框架的核心特性、技术架构与生态系统。涵盖多框架支持、50万+预训练模型调用、全模态任务覆盖及快速上手代码示例,助你高效构建AI应用。
 教程攻略
Hugging Face Transformers:16万Star背后的秘密与实战指南
深度解析Hugging Face Transformers开源框架,涵盖全模态模型支持、pipeline极简API、Hub生态系统及社区贡献机制。了解这个16万Star项目如何推动AI民主化,附Python代码示例与实战入门指引。
 产品体验
Hugging Face Transformers:16万Star背后的AI开源框架深度解析
深入解析Hugging Face Transformers开源框架,涵盖核心功能、Pipeline API用法、生态协同、大模型支持及未来挑战,帮助开发者全面了解这个16万Star的AI模型定义框架。