1.9TB内存能跑什么大模型?聊聊本地部署的算力天花板
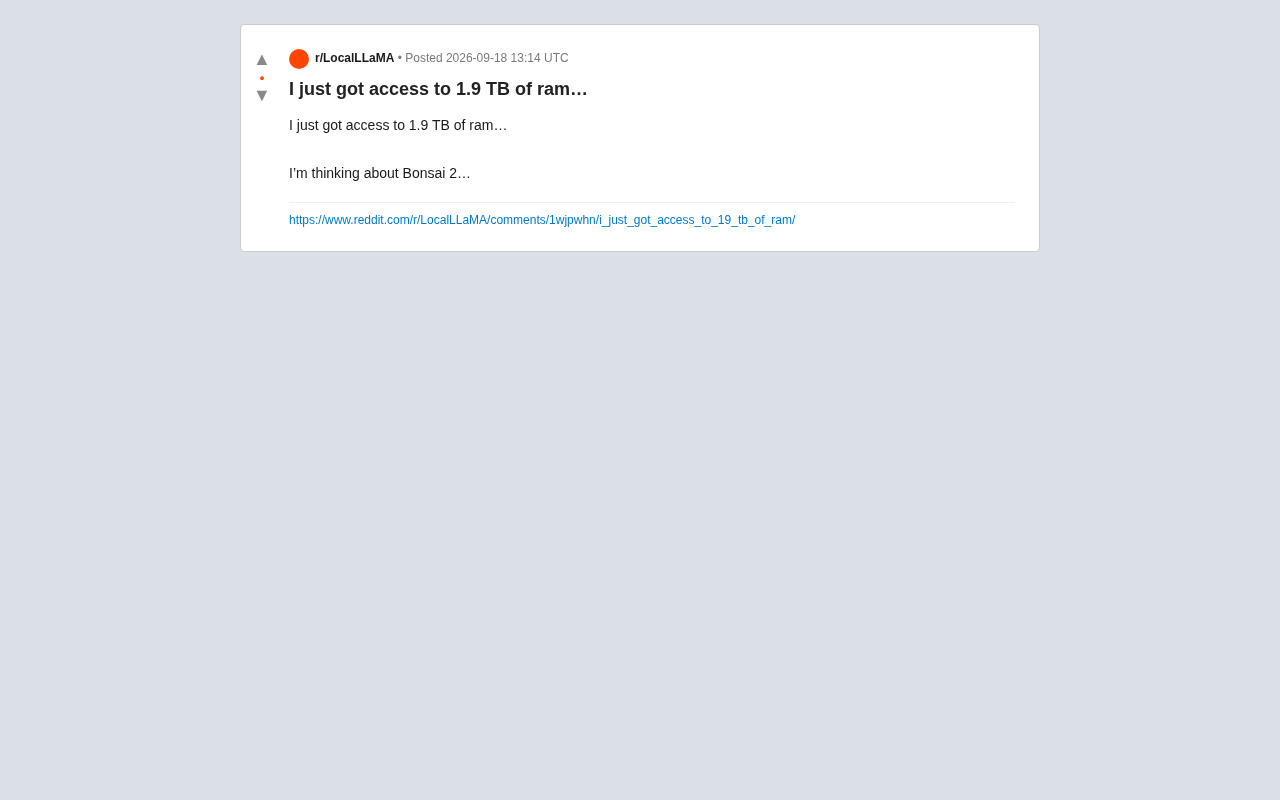
Reddit用户获得1.9TB内存,引发对本地部署超大模型可行性与真实瓶颈的讨论。
一位Reddit用户晒出拥有1.9TB内存访问权限的帖子,引发了本地大模型部署社区的广泛讨论。文章以此为切入点,梳理了海量内存对大模型部署的实际意义:1.9TB内存理论上足以加载数千亿参数的超大模型,甚至支持多模型并行运行,彻底消除了内存容量这一物理限制。然而,CPU+内存的推理方式与GPU显存推理存在显著性能差距,内存带宽成为新的核心瓶颈,导致token生成速度可能慢到影响实际体验。文章还对发帖者提到的「Bonsai 2」模型进行了推测性解读,并指出本地部署真正的挑战不在于「能否装下模型」,而在于如何通过软件调优将硬件资源转化为实际生产力。
一条Reddit帖子引发的思考
近日一位Reddit用户发帖称自己获得了1.9TB内存的访问权限,并提到正在考虑运行「Bonsai 2」这类模型。帖子内容虽然简短,却触及了本地大模型部署领域一个核心命题:当你手握海量内存时,究竟能做什么?
1.9TB内存是什么概念?普通消费级PC通常配备16GB到64GB内存,高端工作站也不过128GB到256GB。1.9TB意味着这是一台服务器级别的硬件,通常出现在数据中心、多路CPU的企业服务器,或是专门为AI推理搭建的高配置平台上。这样的配置足以将当前绝大多数开源大语言模型完整加载进内存。
大内存对本地大模型意味着什么
在本地部署大语言模型时,模型权重需要被加载到内存(或显存)中才能进行推理。模型规模越大,所需内存越高。以常见的量化格式为例,一个700亿参数的模型在4-bit量化下大约需要40GB左右空间,而未量化的全精度版本则可能占用上百GB。
1.9TB的内存容量,理论上可以容纳数千亿参数级别的超大模型,甚至同时加载多个模型进行对比测试或并行服务。对于研究者和爱好者而言,这消除了「模型太大跑不动」的物理限制,把瓶颈从内存容量转移到了推理速度和带宽上。
内存推理的现实局限
说一下,用CPU加内存跑大模型和用GPU显存跑,性能差距巨大。内存带宽远低于高端显卡的显存带宽,这意味着即便模型能被完整加载,token生成速度也可能慢到影响实际使用体验。原帖并未透露具体的CPU配置和内存带宽,这些参数才是决定实际推理速度的关键。
具体来说,现代高端GPU(如NVIDIA H100)的显存带宽可达3.35 TB/s,而即便是顶级服务器级DDR5内存,其理论峰值带宽通常也仅在300-500 GB/s量级,差距高达一个数量级。大语言模型的推理过程在解码阶段(逐token生成)属于典型的「内存带宽瓶颈」任务——计算单元大量时间在等待数据从内存搬运过来,而非真正在做矩阵运算。因此在CPU+大内存的平台上,实际token生成速度往往只有每秒个位数甚至更低,对于交互式对话场景体验较差,但对于离线批处理任务(如大规模文本生成、数据集标注)则仍有实用价值。llama.cpp等主流推理框架已针对CPU推理做了一定优化,支持多线程并行,但物理带宽瓶颈难以通过软件完全弥补。
量化(Quantization)是本地部署中降低内存需求的核心技术。它将模型权重从原始的FP32(32位浮点,每个参数4字节)或FP16(16位浮点)压缩为更低精度的整数表示,如INT8(8位)或INT4(4位),从而将内存占用减少2到8倍。以GGUF格式(llama.cpp使用的量化格式)为例,Q4_K_M是目前最常用的4-bit量化方案之一,在内存占用和模型能力之间取得了较好平衡,质量损失对多数任务可以接受。量化虽然略微损失精度,但使得在消费级硬件上运行原本无法加载的大模型成为可能。对于拥有1.9TB内存的用户而言,甚至可以选择直接加载FP16或BF16的全精度模型,完全绕开量化带来的精度损失。
关于「Bonsai 2」的猜测
发帖者提到考虑运行「Bonsai 2」。目前公开信息中该名称指向并不明确,可能是某个小众或新兴的开源模型项目,也可能是发帖者自定义的实验方向。由于原始素材信息有限,这部分只能作为开放性话题保留。
从命名习惯看,「Bonsai」(盆景)常被用来指代经过精心裁剪、体积精巧的模型——即在保持性能的同时压缩规模的技术路线。若真是此类项目,把它放在1.9TB内存的平台上运行,反而有种「大马拉小车」的意味,更可能是用于大规模并行推理或训练实验。
本地部署的门槛正在变化
这条帖子折射出一个趋势:随着开源模型生态繁荣,越来越多个人和小团队开始尝试在自有硬件上部署大模型,而非完全依赖云端API。大内存服务器、二手企业级硬件的流通,让曾经只属于大厂的算力逐渐下沉。
不过,硬件到手只是起点。如何选择合适的模型、优化量化方案、平衡速度与精度,才是本地部署真正的技术门槛。1.9TB内存给了充足的想象空间,但把这份资源转化为实际生产力,还需要在软件栈和调优上下功夫。
写在最后
一条简短的Reddit帖子,背后是本地AI部署社区日益高涨的热情。对于拥有海量内存资源的用户,可探索的方向包括:加载超大参数模型、多模型并行、长上下文推理等。真正的挑战不在于「能不能装下」,而在于「跑得够不够快、用得够不够好」。期待发帖者后续能分享更多实测数据,让社区了解这类硬件在真实场景中的表现。
相关推荐
Robinhood高管将亮相TechCrunch Disrupt 2026谈现代金融消费者
Robinhood产品营销副总裁Abhishek Fatehpuria将亮相TechCrunch Disrupt 2026,分享如何赢得现代金融消费者。早鸟报名9月25日前最高省200美元。
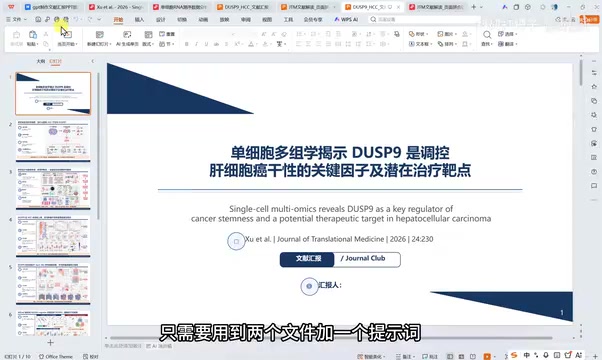
用ChatGPT批量生成可编辑学术PPT:科研人的效率工具实战
分享用ChatGPT批量生成可编辑学术PPT的完整流程:只需文献PDF、PPT模板和一段提示词,先出图再拼合转可编辑,半小时完成美观汇报PPT,并对比了ChatGPT与Codex的适用场景。
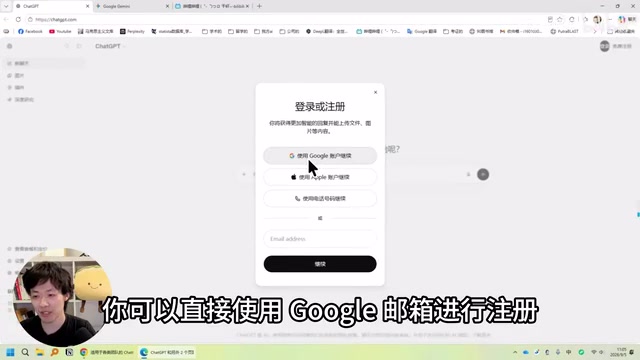
GPT-6满血版使用教程:通过GPT-work开启Ultra最高思考强度
本文详解如何付费使用GPT-6满血版:从Apple ID注册、Plus/Pro套餐充值,到通过GPT-work客户端工作模式开启GPT-6 Ultra最高思考强度与完整权限,并附网页版隐藏解锁路径。