#模型量化
共 50 篇相关文章

4-bit量化如何改变模型拒绝行为?匹配扰动归因分析
预注册研究揭示4-bit量化对聊天模型拒绝行为的影响:Qwen2.5-3B和Llama-3.2-3B出现相反偏移,匹配扰动分析表明行为变化取决于具体舍入误差而非比特数。

inside-llm:开源工具透视LLM内部,逐token对比量化差异
inside-llm是一款开源工具,基于llama.cpp加载GGUF模型,在浏览器中可视化LLM内部生成过程,支持逐token对比两种量化的差异,展示采样链、候选分布、熵和KL散度等指标。

华为开源MACaQ:64分钟量化千亿模型,llama.cpp 1.0发布
华为开源量化工具MACaQ,64分钟完成千亿模型4比特量化,峰值显存32.5GB,预填充与解码速度成倍提升;llama.cpp发布1.0稳定接口,支持150多种模型架构;MiniMax H3 Image最小量化版6.4GB显存让8G显卡可跑;编程智能体榜单转向比拼单题成本。

Unsloth发布Qwen3.8-27B动态v3.1量化更新
Unsloth 发布 Qwen3.8-27B 的 Dynamic v3.1 量化更新。本文分析动态量化策略的含义、对本地部署者的显存与质量权衡,以及当前社区验证信息不足时该如何评估是否迁移。

llama.cpp:C++实现的大模型本地推理引擎
llama.cpp是ggml-org用C/C++实现的大模型推理引擎,支持量化,可在消费级硬件本地运行LLM。GitHub星标超13.4万,本文解析其技术路线、量化能力与生态定位。

Unsloth发布Qwen3.8-27B动态V3.1量化版本
Unsloth 发布 Qwen3.8-27B 的 Dynamic v3.1 GGUF 量化版本,覆盖 2-6bit,声称在 DeepSWE、Terminal Bench、LiveCodeBench 上比 UD3 及 GSQ-RCO、Exllama-3 提升 5-10% 准确率,并回应了与 ISTA 的基准争议。

量化还是排列?本地小模型推理预算的抉择
研究探讨本地小模型在固定推理预算下,应选择权重量化还是选项顺序平均。实验表明6比特量化不损精度,且成本匹配时增加顺序数仅在6比特以上时更优。

本地大模型为何突然好用?三道关卡被依次松开
本地大模型为什么突然好用了?从量化压缩、蒸馏推理到混合专家架构,三道关卡被依次松开。本文拆解装得下、会想、跑得快背后的技术演进与新的边界。

Qwen3.8-27B变“傻”了?用户质疑模型被暗中削弱
Reddit用户抱怨Qwen3.8-27B模型近期表现下降,怀疑官方暗中削弱性能。本文分析可能原因,包括量化差异、版本更新和使用方式变化,并给出建议。

Unsloth发布DeepSeek-V4.1量化GGUF:低比特精度反超ISTA
Unsloth 发布 DeepSeek-V4.1-Flash-1017 Dynamic V3.1 GGUF,实测在 AIME25 等多项基准上优于 ISTA GSQ-RCO,并回应 KLD 量化评估争议,模型可在 64GB 内存设备上运行。
Underdog Saluki 27B:2-Bit量化下的工具调用实战指南
深入解读 Underdog Saluki 27B 基于 GSQ-RCO 的 2-bit 量化方案,涵盖 GGUF 头部结构、内存占用分析与原生 llama.cpp 下的 BFCL 工具调用实测要点,助你评估低比特量化模型的实用边界。

KLD指标被误解:量化模型评测的真相
Reddit讨论指出KLD指标被严重误解:它只是量化模型的诊断工具,而非质量排行榜。本文解析KLD的测量原理、可操纵性风险,以及为何KLD高不代表模型差,帮助读者正确看待量化模型评测。

Llama.cpp本地运行大模型:GGUF转换与量化实战
基于实测演示完整讲解 Llama.cpp 本地运行大语言模型:源码编译、Hugging Face 模型转 GGUF、llama-quantize 量化、llama-cli 参数调优与对话推理,并分享在 iPhone 上本地跑模型的实践经验。

GLM-5.3-Flash本地部署:NVIDIA FP4需两张Blackwell
GLM-5.3-Flash 本地部署全解析:NVIDIA FP4-Local 检查点需两张 RTX PRO 6000 Blackwell 或双 DGX Spark,显存约 166 GiB,精度损失仅 0.8 点。对比 GGUF、MLX 各版本体积与运行路径,给出 vLLM 启动参数与 llama.cpp 避坑要点。
Qwen3.8 Flash量化版实测超官方API,本地部署选谁?
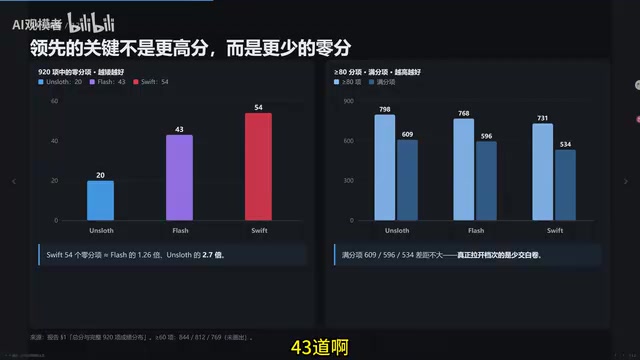
Qwen3.8 Flash 125B模型本地部署实测:Anslows Q4量化版综合表现反超官方API,Swift 1.5速度最快但精度略低。本文拆解评测方法、速度成本对比与选型建议。

NVFP4 vs FP8 vs GGUF:16GB Ada显卡上解码快2.3倍
同一模型 Nemotron Dory 1.0 4B 在 RTX 4070 Ti SUPER 上对比 NVFP4、FP8、MXFP8、GGUF 与 BF16:NVFP4 解码快 2.3 倍,GSM8K 与 BF16 打平,FP8 长提示预填充领先,逐 token 保真度 MXFP8 最佳。

Qwen3.8-27B 跑进 iPhone 18 神经引擎:15–70 tok/s 的端侧大模型突破
27B 参数的 Qwen3.8 模型在 iPhone 18 神经引擎上以 1.5 bpw 量化运行,实测 15–70 tok/s。本文分析低比特量化的精度代价、神经引擎推理的能效权衡,以及端侧大模型对隐私优先 AI 应用的意义。

QAT与BitNet:1-bit及1.58-bit量化训练解析
深入解析量化感知训练(QAT)如何让模型适应舍入误差,并详解BitNet的1-bit二值权重与1.58-bit三值权重方案,包括STE、潜在权重、absmean量化等核心技术。

