10分钟用Python搭建本地AI代理:Ollama+PydanticAI实战
用Ollama+PydanticAI,几分钟在本地搭建能读写文件、执行计算的隐私友好型AI代理。
本文介绍了一套基于Ollama和PydanticAI的本地AI代理搭建方案。Ollama负责在本地运行大模型(推荐Qwen3 4B,适配大多数硬件),并在localhost:11434暴露推理服务;PydanticAI则提供类型安全的代理框架,通过Python函数自动注册工具,让模型可以按需调用获取时间、计算表达式、读写本地文件等能力。整个代理由系统提示、工具集和模型三部分组合而成,配合while循环实现持续对话。方案的核心价值在于数据完全本地化、无API费用、响应迅速;主要局限是小模型的工具调用准确性和推理能力受限,大模型又依赖充足显存,需根据自身硬件做取舍。
为什么要搭建本地AI代理
把AI代理跑在自己的机器上,意味着数据不出本地、无需API费用、响应速度更快,这对注重隐私和成本的开发者很有吸引力。本文基于一位B站UP主分享的实操教程,用Python在几分钟内构建一个完全本地运行的AI代理——它不仅能对话,还能调用工具读写文件、获取时间、执行计算。
整套方案只依赖两个核心组件:本地模型运行工具 Ollama(视频中语音识别误写为"Alma/奥德玛",实际是Ollama)和Python代理框架 PydanticAI。前者负责在本地跑起大模型并提供推理服务,后者负责把模型、系统提示和工具函数组织成一个可用的代理。
第一步:用Ollama跑起本地模型
Ollama是一款完全免费的软件,安装后可以下载并运行各种本地大模型。安装完成后,在终端输入 ollama 命令,若能正常输出,说明环境就绪。
关键在于根据硬件选择合适的模型。能跑多大的模型完全取决于显存或内存:
- 独立显卡(Windows):看显存容量。作者用的是4090,拥有24GB专用显存,可以跑较大模型。
- Mac或统一内存设备:看内存大小,现代Mac通常在16GB到128GB之间。
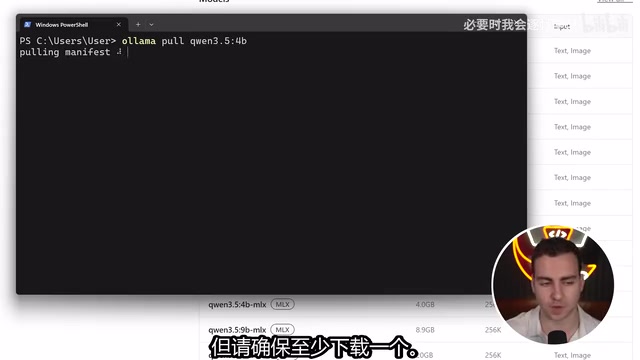
选择原则是挑一个能装进显存/内存的最佳模型。如果只是想快速跟着做,作者推荐使用小参数版本的 Qwen3 系列(视频中读作"Guan 3"),比如 0.6B、1.7B、4B,几乎能在任何现代硬件上流畅运行。作者的默认推荐是 Qwen3 4B。
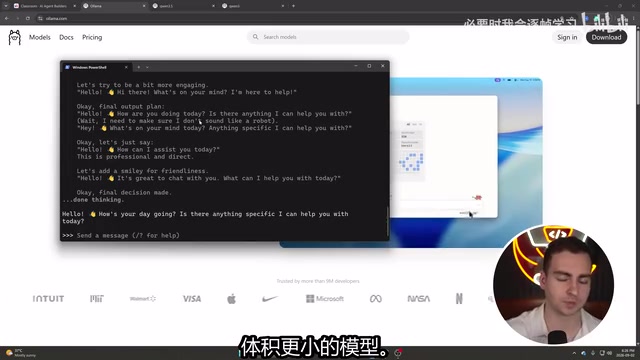
下载模型的命令是 ollama pull <模型名>,例如 ollama pull qwen3:4b。安装完成后用 ollama list 可以查看所有已安装的模型。想测试模型速度,运行 ollama run <模型名> 即可进入对话模式。加载需要一点时间,之后就能直接聊天。
作者强调一个实用判断标准:模型越大性能越好但越慢,只要响应"不是永远不来"就没问题,如果太慢就换一个参数更少的版本。
第二步:用PydanticAI连接本地模型
模型跑起来后,接下来进入代码编辑器(作者用的是VS Code)。首先创建 agent.py 文件,并确保已安装Python和 pydantic-ai 库,可以用pip或UV等工具安装。
连接本地模型的核心逻辑是:通过PydanticAI的 Ollama 模型类和 Ollama 提供者,指向本地推理服务器。Ollama在你的设备上默认开启了一个推理服务,地址为 localhost:11434,代码直接连接这个端口即可调用模型。
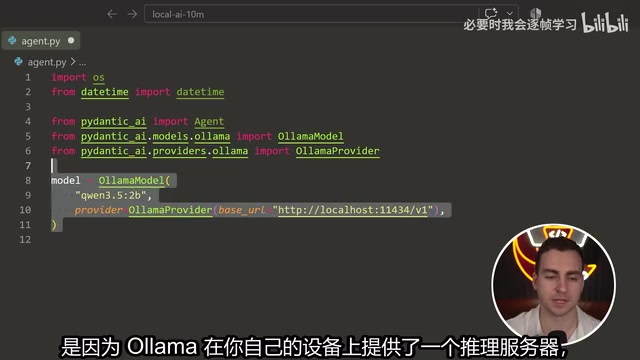
这一步的意义在于:整个AI能力都跑在本地端口上,没有任何云端调用,也就没有网络延迟和API费用。
PydanticAI 是由 Pydantic 团队(以数据验证库 Pydantic 闻名)推出的 Python AI 代理框架,设计理念是把 Pydantic 的类型安全带入 AI 应用开发。它的核心优势在于:通过 Python 类型注解自动完成工具参数的解析与校验,开发者不需要手动编写 JSON Schema 来描述工具签名——这正是 OpenAI、Anthropic 等 API 在使用 Function Calling 时所要求的繁琐步骤。PydanticAI 支持多种后端,包括 OpenAI、Anthropic、Gemini,以及通过 Ollama 接口运行的本地模型。对于本地部署场景,它会把请求发送到 Ollama 暴露的兼容 OpenAI 格式的 REST 接口,因此代码层面几乎无需区分"本地模型"和"云端模型"的调用方式,切换成本极低。
第三步:给代理装上工具
真正让代理"有用"的是工具(Tools)。在PydanticAI里,工具本质上就是一组普通的Python函数,代理可以在需要时自动调用它们。
作者示范了几个工具函数:
- 获取当前时间
- 计算数学表达式
- 保存笔记(在本地创建文件)
- 读取笔记(读取本地文件内容)
PydanticAI会自动推断这些函数的参数类型,并让模型知道可以调用它们。你只需把函数名传给代理,框架会处理其余的类型解析和调用逻辑,这也是它相比手写工具调用逻辑省事的地方。
工具调用(Tool Calling / Function Calling)是现代大模型与外部世界交互的标准机制。其原理是:模型在生成回复时,如果判断需要调用某个工具,会输出一段结构化的"工具调用请求"(而非直接输出文字答案),框架捕获这段输出后在本地执行对应函数,将返回结果再次送入模型,模型才最终生成用户可见的回答。这个过程可能在一次用户请求中循环多次,被称为"ReAct"循环(Reasoning + Acting)。值得注意的是,并非所有本地小模型都能可靠支持工具调用——该能力需要模型在训练时专门针对 Function Calling 格式进行微调。Qwen3 系列在这方面表现相对稳定,是当前本地工具调用场景中较受推荐的选择之一。
第四步:定义代理与主循环
有了模型和工具,就可以定义代理了。在PydanticAI的框架中,一个代理是系统提示、工具集和可用模型的组合。你可以为它添加系统提示,指定它能调用的工具函数。
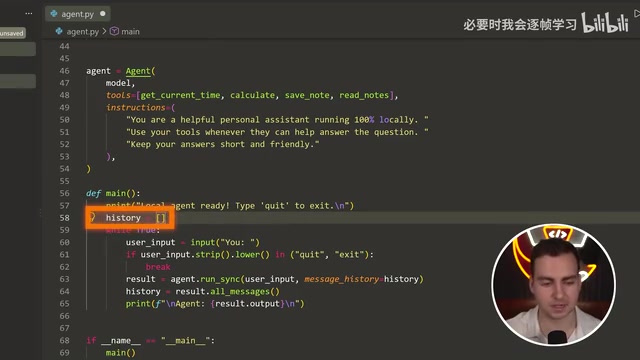
最后需要一个主循环来驱动交互。作者在 main 函数中的做法是:
- 维护一份完整的对话历史记录
- 用
while循环持续接收用户输入 - 输入
quit或exit时退出循环 - 否则把用户输入和历史对话一起发给代理
- 更新历史并打印代理的响应
运行脚本后,终端会提示本地代理已就绪。作者实测了几个场景:让它保存一条写着"Hello World Team"的笔记,它瞬间调用笔记工具完成;询问笔记内容,它读取文件并回答;问当前日期时间,它调用时间工具返回。由于完全本地运行,整个过程响应非常快。
这套方案的价值与局限
这个教程最大的价值在于用最简路径打通了本地大模型到功能代理的全链路:从Ollama拉取模型,到PydanticAI连接推理服务器,再到挂载工具、构建对话循环,每一步都很轻量。
对开发者而言,本地代理适合处理隐私敏感数据、需要频繁调用而不想付API费用、或者想在离线环境运行AI的场景。工具机制的设计也留足了扩展空间——你可以往里加任何Python函数,让代理去查数据库、调API、操作文件系统,从而构建真正实用的自动化助手。
局限也很明显:本地代理的能力上限受硬件制约。小参数模型虽然快,但推理和工具调用的准确性不如大模型;跑大模型又需要充足显存。这是本地部署绕不开的性能与成本权衡,也是选择模型时最需要考量的因素。
相关推荐
AI早报:千问全模态Qwen3-Omni发布,华为昇腾960与Grok新模型齐现身
9月18日AI早报:千问推出原生全模态模型Qwen3-Omni Flash,音视频成本降超93%;华为披露百万级处理器计算架构并传昇腾960将发布;Grok新版现身谷歌云,OpenAI推ChatGPT for Word,N8N爆满分漏洞。
小米MiMo-V2.6直播训练:一天半烧850万,每秒约10美元
小米MiMo大模型团队直播MiMo-V2.6 Pro/Flash的强化学习训练过程,一天半已花费约855万人民币,每秒烧约10美元。本文解析其三方向算力扩展路径、开源计划与DeepSWE基准跑分对比。
字节Trae Work上手指南:11个应用场景解析
字节通用AI agent产品Trae Work上手指南,详解Work、Code、Design三大板块及PPT生成、数据分析、深度研究、代码开发等11个应用场景,帮零代码用户快速判断如何用它解决实际问题。