#本地大模型
共 67 篇相关文章
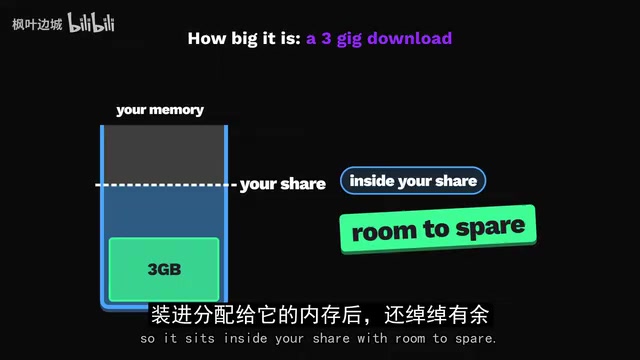
Mac本地跑AI:8GB到Mac Studio全档位模型推荐
海外博主实测Mac本地跑AI:从8GB M1到Mac Studio Ultra,按统一内存份额逐档推荐Gemma、QWEN、GPT OSS等模型,附实测token速度与使用场景,帮你在现有Mac上免费跑起聊天机器人。

Ollama默认安全吗?显卡被白嫖的真相与自查指南
Ollama 默认只绑回环地址,但改一句环境变量或照抄 Docker 命令就可能让显卡暴露。本文解析显卡被白嫖的原理、扫描规模与 DNS 重绑定路径,并给出自查与修复的三层方案。

Intel MacBook跑本地大模型:400行Python管理面板实测
一位B站UP主用约400行Python写了LLM Panel管理面板,搭配llama.cpp让老Intel MacBook纯CPU跑1.7B本地大模型,生成速度每秒22个Token,并给出内存配置建议与性能实测。

本地30B模型接入VS Code代理:权限控制与工具调用实践
开源 VS Code 扩展 RAME Code 将本地 Meta Muse Glimmer 30B 接入编码代理,通过权限控制实现网页搜索与抓取,并讨论本地模型工具调用、上下文管理与权限边界三大工程难题。

899元Mac Mini实测:能替代200美元AI订阅吗?
实测M4 Mac mini能否替代200美元AI订阅:16GB内存装不下大模型,速度与质量均有差距,但隐私、无上限和近零运行成本让它成为常驻智能体的理想宿主。附各配置选购建议与省钱策略。

RSTGameTranslation:实时OCR汉化+本地大模型离线翻译
RSTGameTranslation是一款开源Windows游戏实时翻译工具,支持英日韩OCR识别并将中文覆盖到原位置,可接入Ollama或LM Studio本地大模型离线翻译,还具备Whisper语音听译能力,适用于游戏、漫画和视觉小说。

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

11万显卡装不下1950亿大模型,32G机器该买哪头?
11万的RTX Pro 6000只有96GB显存,装不下122.4GB的1950亿参数大模型。B站UP主AIPC郁森算了一笔账:显卡路线快但装不下,192GB统一内存整机慢但装得下。买机器前先看装不装得下,再为速度花钱。

128G迷你主机跑大模型:贵的不一定快,先定模型再选机器
128G与64G迷你主机跑本地大模型实测:主力35B模型下贵机器78%档位更快,但换27B后快慢反转,MTP版本开头快写字慢。结论是先定模型再选机器,没有全项通吃。

无线GPU破解本地AI两大难题:Wi-Sci实测解析
Wi-Sci无线GPU通过自研协议和SSD优化,让笔记本远程调用RTX 5090,并在32GB显存设备上运行7500亿参数DeepSeek 4.1 Flash。本文基于实测视频拆解其技术原理与实测表现。
下载目录堆成垃圾场?用本地AI脚本两秒自动归档
B站创作者分享用本地大模型写Python脚本自动归档下载目录:零第三方依赖,仅用os和shutil库按后缀分类,两百多个文件两秒整理完毕,还能让AI随时调整规则。

本地大模型换MTP后缀:短问答快27%,长文开头反慢14%
B站UP主实测本地大模型MTP后缀效果:千问3.6-35B-A3B短问答整段提速27%、出字快14%,但长文档首字延迟反增14%。本文整理实测数据与三步选用建议,下载模型前扫一眼文件名即可。

64G内存笔记本跑大模型,实际可用仅46.7G
华硕ProArt创16实测:64G内存标称值下模型可用仅46.7G,128G版官方上限1200亿参数。本文拆解9000元内存差价、统一内存占用真相、续航表现,并给出三步自查方法,帮你判断本地跑大模型该买多大内存。

DeepSeek V4.1-Flash发布,OpenCode密钥泄露警示Agent安全
2026年10月18日技术简报精选:DeepSeek V4.1-Flash新增Search与Fetch API转向交付能力,OpenCode约1.4%用户密钥泄露,NVIDIA RTX Spark轻薄本最高128GB统一内存,GitHub日趋势Agent技能库集中冒头,论文聚焦空间智能与端到端交付评测。

Hishob:本地AI家庭财务仪表盘,隐私优先的记账方案
Hishob是一个隐私优先的家庭财务仪表盘,在Mac Studio上本地运行Qwen3.5-122B模型,整合银行流水与账单PDF,用Neo4j知识图谱自动发现重复扣费、补贴缺口和闲置现金,坚持代码计算、模型解释的原则。

Focus67Dumby:纯离线视觉便签,用本地小模型识别教程与摸鱼
Focus67Dumby 是一个 100% 离线的浮动便签工具,通过 Ollama 调用 Gemma、Qwen 等本地开源小模型,结合窗口标题与降采样截图,区分编码教程与摸鱼内容,并以 19 美元一次性授权探索零订阅、零云端的隐私优先副业模式。

本地大模型真能离线?Bees 网络请求实测拆解
Bees 本地大模型默认会发出哪些网络请求?作者逐行审查源码,发现启动配置查询、更新检查、FreeLLMAPI 列表同步和记忆初始化四类默认请求,其中一项出乎意料。

PCIe 4.0 x8/x8 会拖慢双卡本地大模型推理吗?
实测 PCIe 4.0 x8/x8 与 x16/x16 双卡跑本地大模型的差距:70B 模型张量并行吞吐损失仅 3%–6%,瓶颈在 GPU 显存带宽而非 PCIe 总线,昂贵的 x16/x16 工作站主板并不划算。

