10分钟用Python搭建完全本地的AI智能体教程
用Ollama+Pydantic AI,几十行Python代码在本地构建可调用工具、完全离线的AI智能体。
本文介绍了一套极低门槛的本地AI智能体搭建方案:以Ollama负责在本地下载和运行Qwen3等开源模型(通过localhost:11434提供推理服务),以Pydantic AI负责智能体编排与工具调用。整个开发流程分四步:连接本地模型、定义可供模型调用的Python工具函数(如获取时间、保存笔记)、将模型与工具组装为Agent对象、编写带历史记录的主循环。最终实现一个能调用本地工具、维护对话上下文、全程离线运行的可用智能体,核心代码仅几十行。方案的优势在于免费、隐私安全、响应快速,局限在于本地小模型在复杂推理和长上下文任务上仍不及云端旗舰模型。
在云端大模型API不断涨价、隐私顾虑日益突出的背景下,把AI智能体完全跑在自己的电脑上正变成越来越有吸引力的方案。这篇教程基于一位B站UP主的演示,展示了如何借助 Ollama 与 Pydantic AI 两个工具,用不到十分钟、几十行 Python 代码,构建一个可以调用本地工具、完全离线运行的AI智能体。
为什么选择本地部署
本地运行AI智能体的核心优势在于三点:免费、隐私、速度。使用 Ollama 这类工具,你不需要为每次调用支付API费用,所有数据都留在自己的设备上,不会上传到任何第三方服务器。演示中最直观的体验是响应速度——当模型完全在本地运行时,智能体调用工具几乎是即时完成的。
代价则是硬件要求。本地模型的能力上限直接取决于你的显存或内存大小。作者以自己使用的 RTX 4090(24GB 显存)为例说明:Windows 独显用户需要关注显存容量,而 Mac 或统一内存设备用户则要看内存大小,现代 Mac 通常在 16GB 到 128GB 之间。选择模型时的核心原则很简单——挑一个能装进你可用内存的最佳模型。
用 Ollama 下载并运行本地模型
Ollama 是整套方案的基础,它本质上是一个让你在本地下载和运行各种开源模型的工具,完全免费。安装流程也很直接:从官网下载并安装后,打开终端输入 ollama 命令,如果有正常输出,就说明环境已就绪。
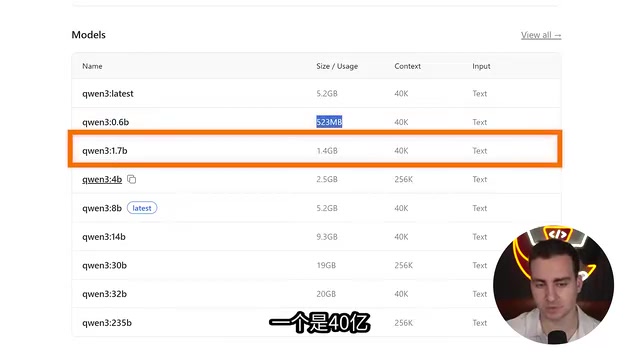
在模型选择上,作者给出了对硬件要求较低的推荐方案:Qwen 系列的小参数版本,比如 0.6B、1.7B、4B 等规格,几乎所有相对现代的硬件都能跑得动。他个人的默认推荐是 Qwen3 的 4B 参数版本,在速度和能力之间取得了不错的平衡。参数量越大性能越好,但速度也越慢,如果测试时响应太慢,就换一个更小的模型。
下载命令为 ollama pull 模型名,安装完成后可以用 ollama list 查看所有已安装的模型。想快速测试模型是否运行流畅,可以执行 ollama run 模型名,加载完成后直接在终端里对话。
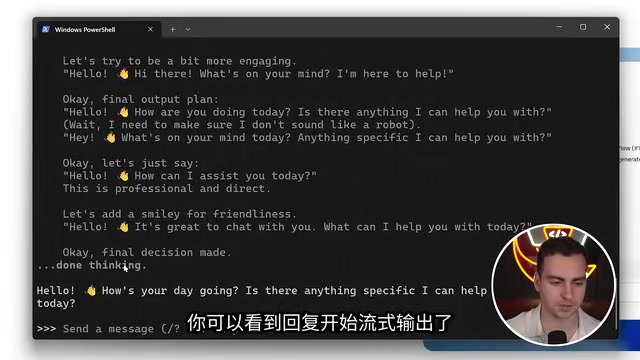
作者在演示中输入了一句简单的问候,模型很快开始流式输出回复,其中还带有一段“思维模式”(thinking)的推理过程。这一步的目的只是验证模型能否以可接受的速度响应——只要不至于等待过久,就可以进入下一步的代码开发。
Ollama 在本地启动的推理服务器遵循与 OpenAI API 兼容的 HTTP 接口规范,默认监听 localhost:11434。这一设计意味着任何支持 OpenAI 格式的客户端库,只需将 base URL 指向本地地址,就能无缝切换到本地模型,而无需修改其他代码逻辑。Ollama 内部使用 llama.cpp 作为推理引擎,能够自动检测并利用 NVIDIA CUDA、Apple Metal(M 系列芯片的 GPU 加速框架)等硬件加速能力。模型文件以 .gguf 格式存储,支持 Q4、Q8 等不同精度的量化版本——量化本质上是用更少的比特位来表示模型权重,以牺牲极少量精度为代价大幅压缩内存占用。例如一个 7B 参数模型的全精度版本需要约 14GB 显存,而 4-bit 量化后只需约 4GB,这正是普通消费级显卡得以运行大参数模型的技术基础。
用 Pydantic AI 编写智能体代码
代码部分依赖 Pydantic AI 库,可以通过 pip 或 uv 等工具安装。整个智能体的构建可以拆解为四个环节:连接模型、定义工具、组装智能体、编写主循环。
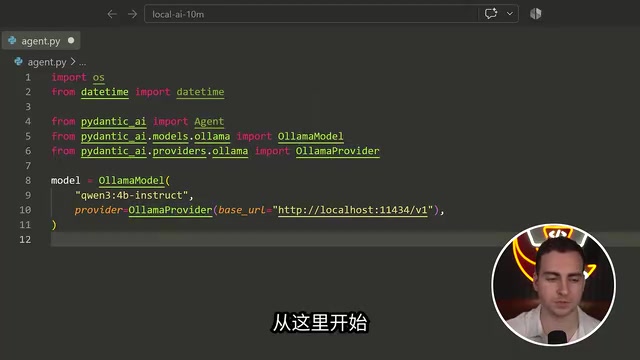
第一步:连接 Ollama。 通过 Pydantic AI 提供的 Ollama 模型类和 Ollama 提供者(provider),指定要加载的模型名称,并连接到本地地址 localhost:11434。这个端口之所以能用,是因为 Ollama 在你的设备上启动了一个推理服务器,程序可以直接向它发送请求调用模型。
第二步:定义工具。 工具本质上就是模型可以调用的 Python 函数。演示中定义了几个示例函数:获取当前时间、计算表达式、保存笔记和读取笔记。后两个函数让智能体具备了在本地文件系统里创建和读取文件的能力。Pydantic AI 能自动推断这些函数的参数类型,让模型知道如何正确调用它们。
Pydantic AI 是由 Pydantic 团队(FastAPI 生态的重要贡献者)开发的智能体框架,其设计哲学是把大模型的工具调用与结构化输出纳入 Python 类型系统的约束之下。与 LangChain 等较重的框架相比,Pydantic AI 更轻量、API 更简洁,核心抽象只有 Agent、Tool 和 RunContext 几个概念。它的关键特性是利用 Python 的类型注解自动生成工具的 JSON Schema,模型在调用工具时会依据这份 Schema 填写参数,框架再负责验证并执行对应函数。这意味着开发者不需要手动描述每个参数的格式,只要函数签名写得清晰,框架就能替你完成"告诉模型怎么用这个工具"的全部工作。它同时支持 OpenAI、Anthropic、Gemini、Ollama 等多种后端,只需切换 provider 即可迁移,非常适合本地与云端混用的场景。
组装智能体并运行
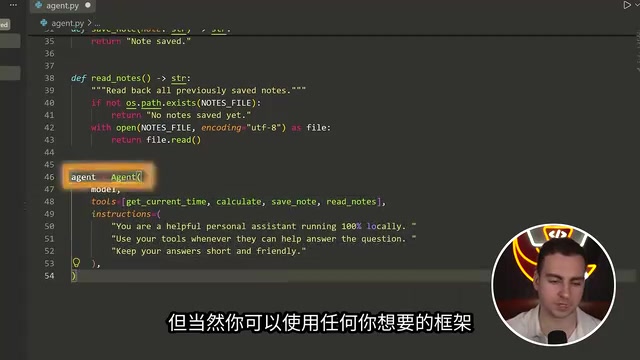
有了模型和工具后,智能体本身其实是三者的集合:系统提示词、工具列表、可用模型。在 Pydantic AI 框架里,只需把定义好的模型、工具函数名和系统提示词传入 Agent 对象即可完成组装。
最后一步是编写主循环。作者定义了一个 main 函数,用一个 while 循环持续接收用户输入,同时维护完整的对话历史记录。当用户输入 quit 或 exit 时退出循环,否则就把用户输入连同历史消息一起发给智能体,更新历史并打印回复。
运行效果验证了整套方案的可用性:终端显示 “local agent is ready” 后,作者依次测试了三类任务——普通问候、要求保存一条 “hello world team” 的笔记、读取当前笔记内容,以及询问当前日期时间。智能体准确调用了对应的工具并快速返回结果,全程在本地完成,速度令人满意。
这套方案的价值与局限
这个案例的意义不在于构建了多复杂的应用,而在于它把“本地AI智能体”的门槛降到了极低。Ollama 负责模型运行、Pydantic AI 负责智能体编排与工具调用,两个成熟工具的组合让开发者可以用几十行代码搭出一个能调用工具、维护上下文的可用智能体。
局限也很明确:本地小模型在复杂推理和长上下文任务上仍无法与云端旗舰模型相比,工具调用的稳定性会随模型能力下降而波动。对于注重隐私、需要离线运行,或只是想快速学习智能体基本架构的开发者来说,这套方案是一个理想的起点。想进一步扩展,可以在此基础上增加更多工具函数,或换用更大参数的模型来提升能力。
相关推荐
WorkBuddy是什么?国内AI智能体入门实战全解析
WorkBuddy是什么?本文解析这款国内AI智能体的核心能力:批量处理文件、对接企业微信等办公软件、连接器与技能市场,以及与豆包、Codex的对比差异,帮助新手快速理解并上手AI数字员工。
解析Agent Harness:从Claude Code源码看AI智能体架构
深度解析 Agent Harness(Harness Engineering)架构,结合 Claude Code 源码泄露事件,梳理 AI 智能体的底层原理、核心组件与工程实现思路,帮助开发者理解大模型应用的前沿架构范式。
VSCode SSH 代理机制解析:便利背后的安全隐忧
VSCode Remote-SSH 的代理转发机制引发 Hacker News 讨论。本文解析 VSCode SSH Agent 的工作原理、便利性背后的安全隐患,以及开发者应采取的防护实践。