11万显卡装不下1950亿大模型,32G机器该买哪头?

本地大模型先看装不装得下,再为速度花钱,11万显卡装不下195B模型。
B站UP主AIPC郁森通过实测对比指出,本地跑大模型的首要问题是容量而非速度。一块售价约11万的RTX Pro 6000拥有96GB显存,却装不下需122.4GB的1950亿参数DeepSync V4.1 Flash,差26GB导致无法加载。而一台192GB统一内存的迷你主机价格仅为显卡路线的零头,虽带宽较低但能装下模型。UP主强调,显存和内存装的是同一件东西,区别只在离芯片远近,决定速度而非容量。购买判据应是先确认模型能装进机器,空间够了再为速度花钱,顺序不能反。
本地跑大模型,很多人第一反应是砸钱买好显卡。但B站UP主AIPC郁森给出了一个反直觉的结论:花钱多的那条路,反而先走不通。一块售价约11万的英伟达RTX Pro 6000,带着96GB显存,依然装不下1950亿参数的DeepSync V4.1 Flash。问题不在快慢,而在能不能装进去。
先算装不装得下,再谈跑得快不快
UP主把结论直接摆在前面:一张卡11万,装不下就是装不下。这个模型有195B参数,即1950亿个参数,压到最小也需要122.4GB空间,差不多是一台128G整机的全部家当,还差26GB。有人为了这点空间,甚至把整机买回来拆卡。
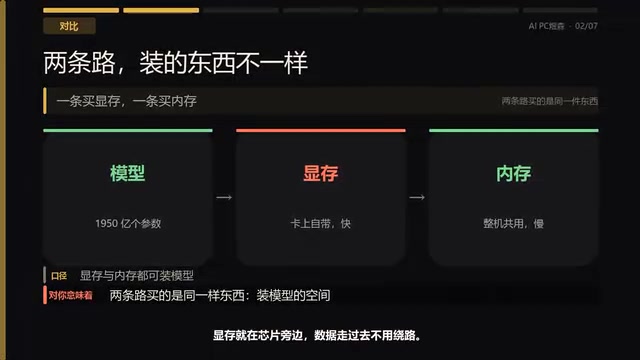
这里的关键认知是:显存和内存装的是同一件东西——模型参数。二者唯一的区别是离芯片的远近。显存就在芯片旁边,数据走过去不用绕路;内存要走一段,慢一些。所以这两条路的账,从来不是比谁跑得快,而是比谁先把模型装进去。装不进去,快是空话。
模型参数的存储单位是字节。一个参数通常以16位浮点数(FP16/BF16)保存,占2字节;量化到8位(INT8)占1字节,4位(INT4)占0.5字节。195B参数若按FP16存储需390GB,按INT8需195GB,按INT4需约97.5GB。文中122.4GB对应的是某种混合量化或带额外开销的4位方案。此外,推理时还需为KV Cache(键值缓存)预留空间,它随上下文长度和并发数增长。因此“装得下”不仅指权重放得进显存/内存,还要留出KV Cache和运行时缓冲的余量,否则长上下文或并发请求时仍会溢出。
显卡路线:快,但装不下
先看显卡这条路。这张RTX Pro 6000美国零售价16499美元,折过来大概11万。有意思的是,戴尔拿同一张卡做成整机,单卡比这台整机还贵三成,所以现在有人干脆买整机回来把卡拆下来。
96GB显存摊下来,每一个G的价格明显高于整机内存路线。它确实快,显存带宽达到1792GB每秒。显存带宽就是每秒能从显存里搬出多少数据,搬得快,出字就快。但快的是出字,它不解决装不装得下的问题。模型要122.4GB,卡只有96GB,差26GB,它不会跟你商量,加载到一半就报错。有人把多出来的部分塞进内存,能跑起来,但速度掉到内存那条线的水平。
显存带宽指GPU每秒能从显存读取的数据量,单位GB/s。它决定大模型推理时矩阵乘法的数据供给速度,直接影响出字速度(tokens/s)。RTX Pro 6000的1792GB/s远高于DDR5内存的270GB/s,但带宽只解决“搬得快”,不解决“放得下”。当模型权重超出显存,系统会把部分层卸载到内存,每次计算需通过PCIe总线搬运数据,PCIe带宽(约64GB/s)成为新瓶颈,速度骤降。因此“显存不够用内存凑”虽能跑,但性能会回落到内存路线的水平。
整机路线:慢,但装得下
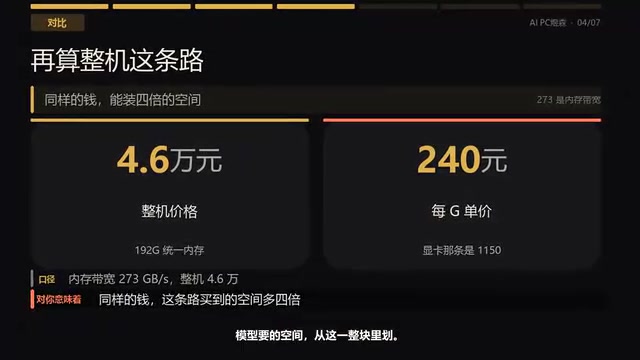
再算整机这条路。一台192GB统一内存的迷你主机,价格约为显卡路线的零头。统一内存就是内存和显卡共用一块,不分家,模型要的空间从这一整块里划。192GB摊下来,每一个G的成本不到显卡路线的四分之一。
它慢,内存带宽270多GB每秒,但它装得下122.4GB的模型,还剩70GB喘气空间。装不下和慢,你只能选一个。选错的代价不是慢一点,是根本开不了。一边是钱花了用不上,一边是能用、只是慢。
统一内存(Unified Memory)指CPU和GPU共享同一块物理内存池,无需显式拷贝数据。在迷你主机上,这意味着GPU可直接访问全部192GB内存作为显存使用,但受限于内存带宽(约270GB/s)和GPU核显的算力。其优势是容量大、成本低,适合装下超大模型;劣势是带宽低,出字速度慢。对于本地大模型,若模型能装进统一内存,即可运行,只是速度不如独立显卡。这种架构常见于苹果M系列芯片和AMD/Intel的核显迷你主机。
一句话判据:先看空间,再为速度花钱
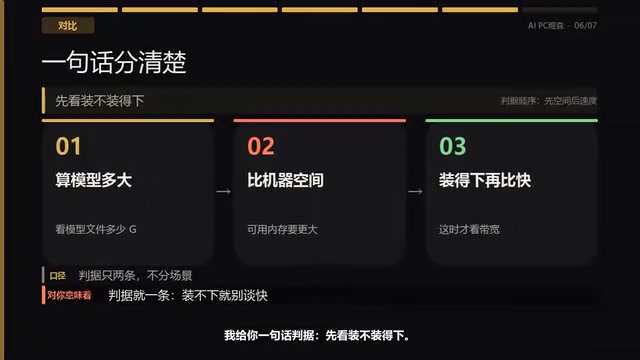
UP主给出一句话判据:先看装不装得下。装不下,快多少都跟你没关系,因为模型根本起不来。装得下之后,再比谁快,那才轮到显存。顺序不能反过来——先算你要装的模型多大,比机器能用的空间大就换模型,别换机器、别换卡;空间够了,再为快花钱,那笔钱才花得值。
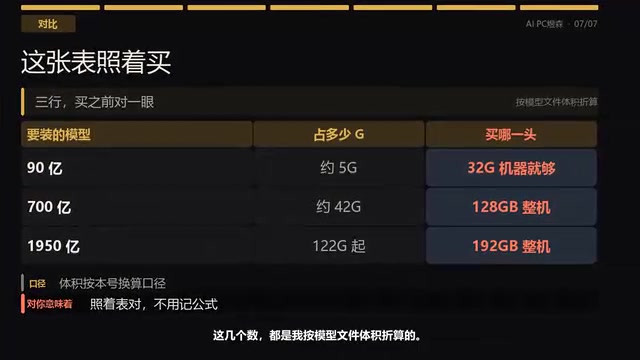
他给了一张对照表,买机器之前可以对着看:90亿参数的模型也就是9B,5个G左右,32G的机器就够;700亿的也就是70B,40来个G,得128GB内存的整机;1950亿的也就是195B,压到最小要122.4GB,得192GB的整机。这些数都是按模型文件体积折算的,模型文件多少G,一比就知道。
两条路线的本质权衡
这场对比的核心不是显卡与整机谁更强,而是两种资源分配思路的碰撞。显卡路线把预算压在离芯片最近的显存上,换来极致带宽;整机路线把预算摊在大容量统一内存上,换来装得下的余量。对于动辄上百GB的本地大模型,容量门槛往往先于速度门槛到来。先确认模型能装进去,再决定为速度付多少溢价,这是UP主反复强调的购买逻辑。
他的评测系列专注在迷你主机上跑本地大模型,一台台实测,后续还会聊同一台机器上同时开多个AI会不会卡,以及买迷你主机前该先看的几个数。
相关推荐

GitHub为无障碍声明安家:ACCESSIBILITY.md获官方支持
GitHub 上线对 ACCESSIBILITY.md 文件的识别与展示,帮助开源维护者集中记录无障碍目标、已知障碍、支持环境、贡献者预期与反馈流程,降低无障碍协作门槛。

NVIDIA协同设计:让AI工厂每字节价值最大化
NVIDIA开发者博客阐述AI工厂协同设计五种做法,聚焦HBM等高带宽内存的字节效率,从权重布局、数据搬运到软硬件共同设计,解析如何让每个字节创造更大价值。

直觉理解:神经网络如何读懂文本
从直觉层面解释神经网络如何理解文本:文本如何转为数字、注意力机制如何结合上下文、分层抽象如何从词到句构建语义。基于Hacker News讨论的延伸分析。