11条实测规则,把Claude Token消耗砍到极低
Claude Code 的 Token 成本多藏在缓存过期与上下文冗余里,十一条规则教你堵住黑洞。
文章从 Claude 缓存一小时过期导致同一消息成本可高出约 20 倍这一现象切入,系统梳理了 Claude Code 的省 Token 规则。核心思路分四层:源头控制(默认 medium 努力等级、开工前让 Claude 采访你以明确需求)、清理上下文(卸载不用的技能与连接器、任务切换用 /clear、离开超一小时前先 /compact)、用对工具(出错用 /rewind 回退而非反复纠偏、领取免费重置额度、用 /usage 定位消耗来源、开启 concise 输出风格压缩回复)、以及代理与额度防线(把 Explore 子代理降级到 Haiku、设置月度用量上限)。作者强调旧规则已有六条失效,真正稳定的是“中等努力、讲清需求、勤清上下文、切换开新会话、离开先压缩、辅助任务用便宜模型”这几条习惯。
你的Token去哪了:一个被忽视的成本黑洞
同一个问题,隔一小时再问Claude,成本可能是第一次的数倍。原因不是涨价,而是Claude的缓存机制:订阅制下Claude Code的对话缓存只保留一小时,每次发消息都会重置计时——但如果你离开超过一小时,下一条消息就得让Claude从头重读整段对话。
据YouTube创作者Doobie自述,他翻了自己30天的Claude Code日志,发现每次长时间休息回来,Claude都要重读约92%的聊天历史。Anthropic的Lydia Hawley算过这笔账:从缓存读取约为正常价格的十分之一,而重写缓存最高可达两倍,也就是同一条消息晚发一小时,成本可能高出约20倍。
Doobie此前分享的11条省Token规则曾被大量用户照搬,但他坦言其中6条已经因产品更新失效。他重新梳理了Anthropic官方文档和近半年的补丁说明,整理出新版规则。以下按逻辑分组呈现。
Prompt Caching 的计费逻辑:Anthropic 的缓存机制允许把对话前缀(系统提示、历史消息等)暂存起来,后续请求命中缓存时按约正常输入价格的 1/10 计费;而缓存未命中、需要重新写入时,写入部分按约正常价格的 1.25 倍(5 分钟缓存)或 2 倍(1 小时缓存)计费。这意味着“晚一小时再发”不只是多付一次输入费,而是把原本便宜的缓存读取换成了昂贵的缓存写入。Claude Code 订阅制下默认使用 1 小时缓存,每次新消息会刷新缓存有效期,但一旦间隔超过 1 小时,缓存失效,下一条消息就要把整段历史重新写入并计费,这正是文中“20 倍价差”的来源。
Token 与上下文窗口:Token 是模型处理文本的最小计费单位,约等于 0.75 个英文单词或半个汉字。每条消息实际发送的不只是你键入的文字,还包括系统提示、CLAUDE.md、技能描述、连接器工具定义、历史对话等“上下文”。上下文窗口有上限,且每次请求都要为全部上下文付费,因此“上下文越干净,单条消息越便宜”。文中的 19 万 Token 约合 14 万英文词,正说明日常对话里真正“你说的话”只占极小比例。
规则一与二:从源头控制消耗
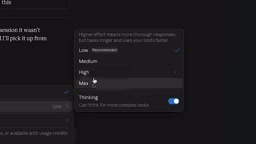
把努力等级留在medium
在Opus 5.5上,Anthropic把medium设为默认努力等级。负责Claude Code的Kat Wu表示,同样用Opus 5.5,速率限制能比上一代模型多撑25%。
更高努力等级意味着Claude花更多时间检查工作、测试边缘情况、自主做决策,但不等于结果质变。Anthropic首席工程师Tariq做过一个测试:先让Claude采访自己,明确健身App需求,再把同一份需求交给不同努力等级。medium用了22分钟,high用了33分钟,max用了79分钟,而最终设计与实现相当接近——max只是多花时间简化细节,但你为medium 22分钟能交付的东西等了超过一小时。
Tariq自己的建议也是:日常开发用medium,遇到难缠的bug、安全检查或想不到的奇怪场景再调高。
别让Claude猜你的意图
上面那个测试有个关键细节:先让Claude采访Tariq,拿到详细需求简报后,不同努力等级的结果差距明显缩小。反过来说,一句“给我做个健身App”会让Claude替你决定用户是谁、要什么功能、界面长什么样,努力等级越高,它替你做的决定越多,算力也烧得越多。
实操方法很简单:开工前让Claude先采访你——“先采访我,把不清楚的地方问出来,把我的回答整理成一份我可以批准的方案,然后再动手”。日常提问也要给出可验证的目标,比如不说“设置页坏了”,而说“刷新后通知开关会自己重新打开,它应该记住我的选择”。
努力等级(Effort Level)与推理 Token:在支持推理的模型上,努力等级控制模型在给出最终答案前进行内部思考的深度。更高等级会生成更多“推理 Token”,并触发更多工具调用、自我检查和边缘情况测试,因此耗时和成本同步上升,但不保证输出质量线性提升。对需求明确、验收标准清晰的任务,medium 往往已触及收益拐点;只有遇到隐蔽 bug、安全审计、架构权衡等需要多路径探索的场景,调高等级才划算。把努力等级理解为“给模型多少试错预算”,而不是“聪明程度旋钮”,能帮助你在成本和质量之间做出更理性的取舍。
规则三到五:清理上下文,别让历史拖累你
先卸载用不上的东西
每条消息在你说的话之前,都背着一堆额外内容:系统提示、CLAUDE.md、已安装技能的名字、开启的连接器。Anthropic文档指出,连接器和技能是最耗Token的部分。写封邮件不需要同时挂着Notion、Drive和日历。
在Claude Code里新开一个会话,输入 /context 就能看到当前上下文占用,再乘以你每天发的消息数。截图里展示的就是这类上下文构成。Doobie还写了个自定义技能叫“Claude Cleanser”,自动清理超过30天未使用的技能——因为Anthropic的技能库界面并不完整展示已安装项,很容易装了就忘。
换任务就 /clear
Anthropic官方文档把这一条称为“对质量和成本最有效的单一杠杆”。Doobie承认自己经常犯错:早上修App的bug,同一个对话里接着写落地页,再问缩略图,三个不相关的任务共享一条上下文。他查日志发现,自己典型的一条消息背着约19万Token的上下文,相当于14万词——只为说一句“润色一下”。
任务切换时,App里点New Chat,终端里敲 /clear。
/compact 与 /clear 的区别:/clear 是彻底清空当前会话、从零开始,历史完全不保留,成本最低但会丢失所有上下文;/compact 则是让模型把已有对话压缩成一段摘要,保留关键信息后继续,仍会产生一次调用成本,但远低于让整段原文反复参与后续请求。选择原则是:任务已完结或完全切换领域时用 /clear;同一任务仍需延续、但历史太长时用 /compact,并且最好在离开或休息前主动执行,而不是等缓存过期后再补,因为后者需要先重读全文才能压缩。
别把Claude晾超过一小时
这一条就是开头那个成本黑洞。缓存一小时过期,重新读取是正常价格的十分之一,重写最高两倍,同一条消息的价差可达20倍。Doobie从健身房回来后的第一条消息,只为说“继续”,就花掉约29万Token。
如果你在跑 /loop,缓存不会随之更新,跑超过一小时同样会重读全部历史。他的做法是:循环任务永远开新对话;长时间离开前先把任务做完,或先执行 /compact——在休息前压缩比休息后补做便宜得多。
规则六到九:用对工具,少花冤枉钱
回退,而不是争论
Claude走错方向时,你花五分钟纠偏,每次纠正都追加一轮消息和响应,全都进入后续上下文。此时敲 /rewind(或在输入框为空时连按两次Esc),回到出错前的节点,选“restore conversation”,需要连代码一起回滚就选“restore code and conversation”,然后用更清晰的提示重来。失败尝试不再留在活跃对话里。
领用免费重置额度
Opus 5.5上线时,付费用户获得了一次可自行保存使用的免费限额重置。路径是设置→usage→resets,点击“reset for free”即可把用量归零。注意它只在网页版或桌面App生效,终端和手机端不行,但重置后全平台(含Claude Code)限额都会恢复。所有存储的重置额度有30天有效期,别放过期。
用 /usage 找出漏点
在Claude Code里输入 /usage,它会按技能、子代理、插件、每个MCP服务器逐行拆解用量来源,并标出最近占10%以上的项目,比如长上下文或缓存未命中。建议看整周数据以获得更大样本量。看不懂就直接问Claude:“看看我这周的用量,有哪些能降低Token消耗的做法?”AI本身就能帮你分析。
让Claude少说话
输出Token比输入Token贵约五倍。让Claude重命名一个文件、它却回你一大段重新思考的过程,这笔钱就白花了。
Doobie提到一个叫caveman的开源技能曾有过十万级GitHub star,文档声称能省65%的Token,但他自测平均约41%。不过它已有些过时。更省事的做法是用Claude Code内置的concise输出风格:/config → output style → concise,Claude会先给结果、跳过叙述,工作量不变,也不占额外上下文。
规则十与十一:代理与额度的最后防线
把辅助代理降级到Sonnet 5.5
Claude Code派出的辅助代理Explore,原先跑在便宜的Haiku上,某次更新后改为跟随主模型,多数用户即Opus。相当于复印文件的实习生按高级工程师费率计费。修复只要十秒:告诉Claude“给我做一个跑在Haiku上的自定义Explore代理”,它会自动写文件,自定义代理会覆盖内置版本,其他项目重复即可。Doobie引用Spotify团队的说法:把文件读取交给更便宜的代理,成本降低约90%——你的数字会不同,但收益方向一致。
子代理(Subagent)与模型路由:Claude Code 可以把探索代码库、读取文件、搜索等辅助性工作交给子代理执行,主代理只接收子代理返回的摘要。子代理使用哪个模型由配置决定,内置代理会随产品更新调整默认值,因此可能悄悄从便宜的 Haiku 切换到主模型。自定义子代理通过在项目或用户目录下写入带 frontmatter 的 Markdown 文件来定义,其中 model 字段可指定 Haiku、Sonnet 等,自定义版本会覆盖同名内置代理。把高吞吐、低判断需求的读取类工作固定到便宜模型,是控制成本最直接的手段之一,但需定期复查,因为内置默认值仍可能随版本变化。
给用量额度设上限
触及限额后,Claude会按Token单价继续跑,避免任务中途断掉。请务必设置月度上限,尤其是代理自动运行时消耗很快。有个陷阱:一旦进入按量计费,Claude Code的缓存从一小时缩短到五分钟,去趟洗手间的功夫就足以让Claude重读整段历史。进入计费状态后,最好守着任务做完。
规则会过期,习惯不会
新旧规则的对比本身就是提醒:6条旧规则已失效,因为模型版本、默认设置、代理模型归属都在变。真正稳定的是几条原则——默认用中等努力、需求先讲清、上下文勤清理、任务切换开新会话、长离开前先压缩、辅助任务交给便宜模型。把这些变成肌肉记忆,比死记任何一版规则都管用。
相关推荐

Punchcutter:一句话或手写体,生成真实字体家族
Punchcutter 是一款免费开源的 AI 字体生成工具,兼容 Claude、ChatGPT、Codex 和 Cursor。输入一句话或手写照片,即可生成 TTF、OTF、可变字体和 Web 字体家族,自带 Studio 应用。
OffiAI:把AI编程会话搬进3D办公室的Mac应用
OffiAI 是一款免费 Mac 应用,将 Claude Code、Codex、Cowork 和 Gemini 会话放入 3D 办公室工位,支持多代理任务管理,无需账号且本地处理数据。

Puffin:为AI智能体提供身份与收件箱,接管你的数字沟通
Puffin为AI智能体提供独立邮箱、Discord/Slack/Telegram席位和日历,支持审批与全自动驾驶双模式,让智能体以数字身份融入团队协作。