12GB显卡本地跑1250亿参数大模型 Strata实测

开发者用Strata引擎将1250亿参数大模型塞进12GB显存的游戏电脑,实现本地私有化运行。
阿里放出的1250亿参数大模型原本部署成本极高,但开发者NICO 1221用Strata引擎将其成功运行在普通游戏电脑上:12GB显存、32GB内存即可,无需联网或订阅。核心策略是把模型主体放在系统内存,只把常用部分调入显存,类似图书馆按需取书。实测RTX 5070跑二比特量化版达每秒94 Token,三比特版53 Token,原生支持26万上下文。这不仅是省钱,更改变了AI所有权结构——所有数据不出本地,隐私和可控性大幅提升,为中小企业私有AI服务提供了现实路径。
本地部署大模型的门槛正在被打破
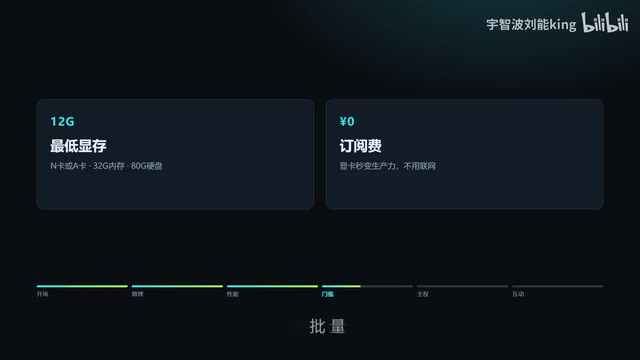
大模型能力一路狂飙,但绝大多数人想用上真正的旗舰级模型,仍然只能租云端服务器——一个月几万块起步。最近,阿里放出了一个1250亿参数的大模型,正常部署成本让普通开发者望而却步。但一位叫NICO 1221的开发者写了个叫Strata的引擎,硬是把它塞进了一台打游戏的电脑里:12GB显存就能跑,不用联网,不用交订阅费。
这件事之所以值得聊,不在于它"省钱",而在于它可能改变AI的所有权结构——你发的每一份合同、每一行代码、每一张截图,都在别人的服务器上过了一遍。Strata跑起来之后,这些东西一步都不出你的电脑。
Strata到底做了什么
核心思路:内存当仓库,显存当工作台
1250亿参数的模型体积确实庞大。ByteDance的NICO 1221选择了一条取巧的路径:把整个模型放在系统内存里,只把最常用的部分塞进显卡显存。
用原文的比喻来说——图书馆的书不全搬到你桌上,但你每次要看哪本,它30秒内给你递过来。
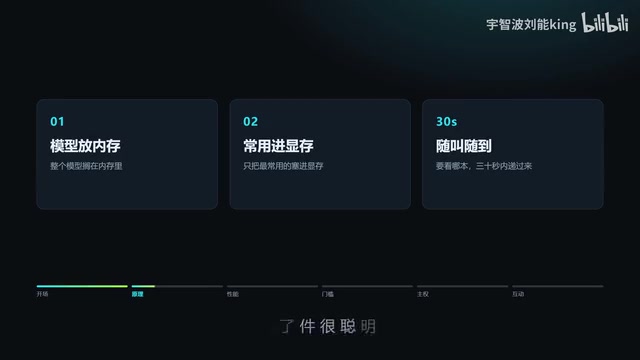
这个设计的关键在于,它没有试图把模型"压缩到很小",而是接受了大模型必须占空间的事实,转而优化"哪部分参数该待在快存储里"。这是一种工程上的务实,而不是算法上的炫技。
量化(Quantization) 是把模型参数从高精度(如16位浮点)压缩成低精度(如2位、3位、4位整数)的技术,直接决定模型占用多少显存和内存。文中提到的“二比特版本”“三比特版本”,就是把权重从16位压到2位或3位,显存占用可降到原来的1/8甚至1/16。代价是精度损失,可能让模型回答变差或者出现胡言乱语,所以量化位宽的选择本质上是在“能跑起来”和“跑得好”之间做权衡。
系统内存与显存的带宽差异 是Strata这套方案能成立的前提之一。显卡显存(如GDDR7)的带宽通常是系统内存DDR5的好几倍,所以把全部参数塞进显存速度最快,但显存容量有限;把参数放在系统内存里,通过PCIe总线按需搬到显存,会受限于PCIe带宽和延迟。Strata的“按需调页”策略,就是只在需要某层参数时搬运,避免一次性搬完,用时间换空间。
实测数据:速度超过你的阅读速度
根据实测,RTX 5070跑二比特量化版本,每秒输出94个Token。什么概念?你读一句话的功夫,它已经写完三句了。
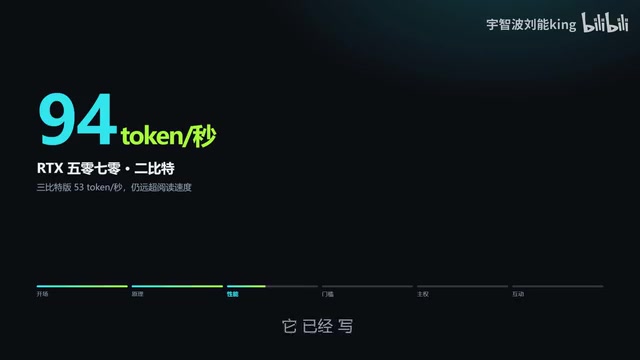
三比特版本稍微慢点,53个Token每秒,但也远超你阅读速度。而且它原生支持26万2000的上下文——你可以直接把一本技术手册扔进去,它一口气读完。
需要说明的是,这个大模型目前还在持续迭代,实测数据仅供参考,别急着下结论。
最低配置门槛
- 12GB显存以上的N卡或A卡
- 32GB内存
- 80GB硬盘空间(SSD最好)
门槛不算低,但对于一台游戏电脑来说,这已经是"本来就有"的配置。
上下文长度(Context Length) 指模型一次能“记住”的token数量。文中提到“原生支持26万2000的上下文”,意味着你可以把一本几百页的技术手册一次性输入,模型在回答时能引用其中任意位置的内容。传统模型的上下文通常只有4K到32K,超过就会遗忘;26万级别属于长上下文能力,对本地知识库、长文档分析这类场景尤其关键。但要注意,上下文越长,对显存和内存的占用也越大,实际能用的长度还受硬件限制。
显存与内存的分工 也值得解释一下。显存是显卡自带的高速内存,用来存放当前正在计算的模型层和激活值;系统内存是主板上的内存条,容量大但速度慢。Strata让模型主体常驻系统内存,只把当前推理需要的层动态加载到显存,因此12GB显存就能跑1250亿参数模型——这在传统全量加载方案里至少需要几百GB显存。
这玩意儿真能挣钱吗
装上这个模型,你手里用来打游戏的显卡立马变成生产力工具。接单写代码、做本地知识库、批量处理文档、给公司搭私有AI服务——这些都是实打实的付费场景。
对于那些需要处理敏感数据的中小企业来说,私有AI服务是一个刚需。你不需要把客户数据传给第三方,不需要担心合规问题,也不需要按Token付费。你那张卡可能比你想象的值钱得多。
私有化部署(On-Premise Deployment) 指把AI模型部署在企业自己的服务器或电脑上,数据不出内网。对于金融、医疗、法律等处理敏感信息的行业,私有化能规避数据出境和第三方泄露风险,也省去了按Token计费的持续成本。Strata这类方案把私有化的硬件门槛从“机房级”拉低到“游戏PC级”,让中小企业甚至个人开发者都能拥有自己的AI服务,这正是它可能改变AI所有权结构的经济基础。
AI到底是谁的
说到底,这玩意儿解决的不是"能不能用AI"的问题,而是"AI到底是谁的"的问题。
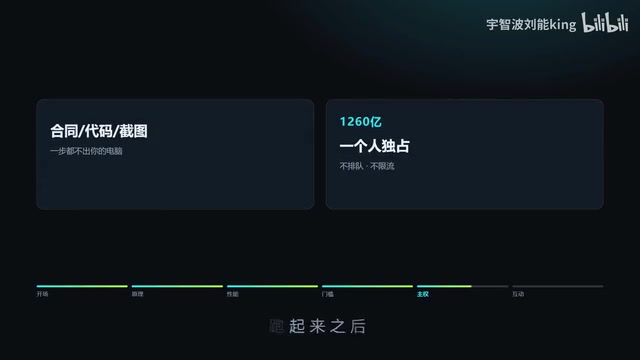
你发给云端模型的每一份合同、每一行代码、每一张截图都在别人服务器上。Strata跑起来之后,这些东西一步都不出你的电脑。1250亿的模型你一个人独占,没有排队、没有限流、没有高峰期请稍后再试。
从隐私到成本,从速度到可控性,这笔账值得每个人认真算一算。
你的显卡能不能跑
视频作者在评论区邀请观众报出自己的显卡型号和显存大小,表示可以挨个帮看。如果你手头有12GB以上显存的N卡或A卡,加上32GB内存,这件事就值得认真考虑。
一位B站UP主在实测中反复强调:别急着下结论,让子弹飞一会儿。这既是技术态度,也是对自己判断的诚实。
把大模型从云端搬回本地,不再只是极客的玩具,而是正在变成一条现实的生产力路径。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。