12GB显卡跑1250亿参数大模型?Stratavie装机实测全流程

用MoE稀疏激活+逐层量化+四层硬件分工,12GB游戏显卡在家跑通1250亿参数旗舰模型
阿里1250亿参数的Qwen3.8 Flash Next模型,全精度体积354GB,通常需要工作站级硬件。但借助开源推理引擎Stratavie,通过MoE稀疏激活(每次只激活60亿参数)与GSQ-RCO逐层量化(体积压至66~84GB),再将显卡、内存+CPU、SSD划分为四层存储与计算仓库协同工作,配合推测解码(小模型先猜、大模型批改)加速,一张12GB游戏显卡加64GB内存即可在本地运行该旗舰模型。RTX 5070实测写回答速度94 token/秒,且第三方对比显示速度显著优于Llama.cpp。代价是存在精度损失、并发受限、启动卡顿及模型绑定等边界,并非对所有场景都适用。
一张游戏卡跑旗舰模型,这事怎么成的
1250亿参数的模型,全精度体积高达354GB,按常理需要工作站级别的硬件才带得动。但B站UP主「大树大」在最新一期装机实测中给出了另一个答案:一张12GB显存的游戏显卡,配合64GB内存,就能把这个旗舰级模型请进普通游戏电脑,实测跑出每秒94 token的生成速度。
这件事能火起来,背后是知乎热榜上「12GB凭什么跑1250亿」的问题,已经斩获4.6万浏览、15条回答,头部回答拿到211赞。核心逻辑其实并不玄学:不是把1250亿参数硬塞进12GB显存,而是把整台电脑变成模型的存储与计算系统,各部件分工协作。
本期主角是开源推理引擎 Stratavie 0.1.41,采用MIT协议,GitHub上已有18400 Star、216位贡献者,专门服务超大MoE(混合专家)模型的本地运行。它要跑的模型是阿里发布的 Qwen3.8 Flash Next,1250亿总参数、每次只激活60亿、原生支持26.2万上下文。
四个数字拆解:12GB到底塞不塞得下
要理解这套方案,先把关键参数拆成四个数字看清楚:
- 1250亿 是总参数量,全精度体积354GB;
- 60亿 是每个token实际激活的参数量,不到总量的5%;
- 24576 是专家总数,每个token只调用其中约10个;
- 量化后 模型体积被压到66~84GB。
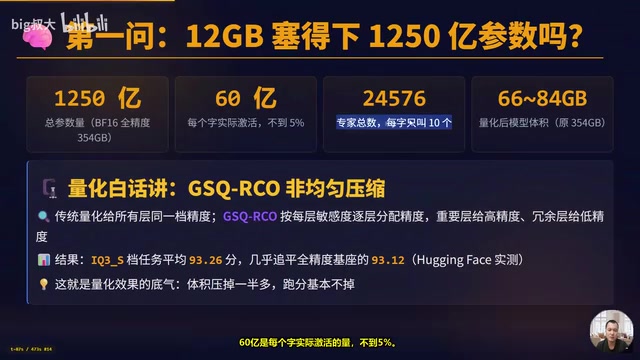
压缩的关键在于量化方式。传统量化是给所有层统一精度、一刀切,而这里采用的GSQ-RCO按每层敏感度逐层分配精度——重要的层给高精度,冗余的层给低精度,类似「按需配给」。
效果如何?据视频引用的Hugging Face实测数据,IQ3_S档在任务上平均拿到93.26分,几乎追平全精度基座的93.12分。一句话总结:体积压掉一半多,跑分基本不掉。
**MoE(混合专家模型)**是理解这套方案的前提概念。传统稠密模型(Dense Model)在推理每个token时,会激活全部参数;而MoE模型将参数分成若干独立的「专家」子网络,每次推理由一个轻量级路由器决定调用哪几个专家,其余专家完全不参与计算。Qwen3.8 Flash Next拥有24576个专家,每个token只调用约10个,这意味着实际参与计算的参数量只有总量的不到5%。对推理硬件而言,关键的显存瓶颈不再是「存下所有参数」,而是「快速找到并调用当前所需的那几个专家」。这一架构差异,是12GB显卡理论上能驾驭1250亿参数模型的根本出发点。
GSQ-RCO(按层敏感度分配精度的量化方案)则解决了「存下来」的问题。常规的统一量化(如全部INT4或INT8)对所有层一视同仁,容易在关键层引入过大误差。GSQ-RCO通过预先分析每层参数对输出的敏感程度,对重要层保留更高精度位宽,对冗余层大幅压缩,从而在整体体积与精度之间取得更优的折中——这正是它能把354GB压到66~84GB、跑分却基本持平全精度的原因。
四层仓库:模型运行时东西都放在哪
量化解决了体积问题,但运行时这些参数到底存在哪?UP主用「四层仓库」的比喻讲得很清楚。
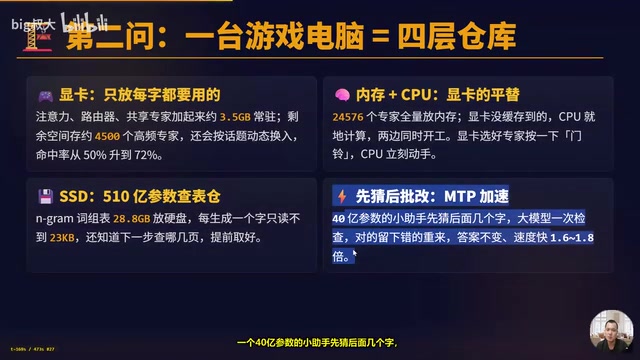
第一层·显卡(约3.5GB常驻):只放每个token都要用的东西——注意力、路由器、共享专家。剩余显存缓存约4500个高频专家,并按话题动态换入换出,专家命中率可从50%提升到72%。
第二层·内存+CPU:相当于显卡的平替。24576个专家全量放进内存,显卡没缓存到的部分由CPU就地计算,两边同时开工。显卡选好专家后「按门铃」,CPU立刻动手,谁也不闲着。
第三层·SSD:参数查表仓与N-Gram持组表约28.8GB放在硬盘上,每生成一个token只读取不到23KB,而且引擎能预判下一步要查什么,提前取好。
还有一个加速细节叫「先猜后批改」:一个40亿参数的小模型先猜出后面几个token,大模型一次性检查,对的留下、错的重来,答案不变但速度能快1.6~1.8倍。
「先猜后批改」在技术上称为推测解码(Speculative Decoding)。大型语言模型自回归生成的固有瓶颈在于:每次只能产出一个token,且必须等上一个token完成才能开始下一个,GPU利用率往往不饱和。推测解码引入一个参数量小得多的「草稿模型」(Draft Model),先快速连续猜出若干候选token序列,再交给主模型一次性并行验证:猜对的直接接受,猜错的丢弃并从出错处重新生成。由于主模型验证多个token的计算量与验证一个相差无几,整体吞吐量得以提升。本方案中用于起草的40亿参数小模型与1250亿主模型来自同一系列,知识分布相近,命中率较高,因此能实现1.6~1.8倍的实际加速,且最终输出与纯主模型推理在数学上等价,不引入额外精度损失。
一键安装与档位选择
安装门槛并不高:显存12GB以上、内存32GB起步(想跑全档位建议64GB)、磁盘留80GB建议用固态,系统支持Windows 10/11或Linux,再装上最新显卡驱动即可。
Windows下解压仓库后双击 start-here 批处理文件,Linux跑 ./setup 脚本,一路回车选推荐项即可。模型约70GB会自动下载,断线支持续传。首次启动会把35~55GB的模型搬进内存,电脑卡顿1~3分钟属于正常现象。UP主还提到一个省心做法:把安装指令直接丢给Claude Code、Cursor这类AI助手代装,全程不用盯。
档位选择由内存大小决定:
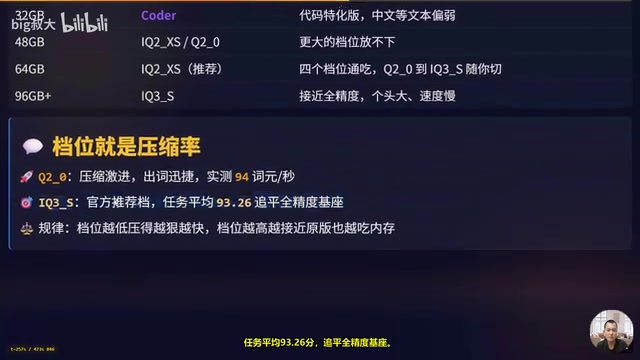
- 32GB内存:推荐Coder代码特化版,代价是中文等文本能力偏弱;
- 48GB内存:可上IQ2_XS或Q2_0;
- 64GB内存:四档位通吃,从Q2_0到IQ3_S随意切换;
- 96GB以上:直接IQ3_S,接近全精度。
规律很简单:档位越低压得越狠、速度越快;档位越高越接近原版、也越吃内存。
实测跑分:12GB显卡什么水平
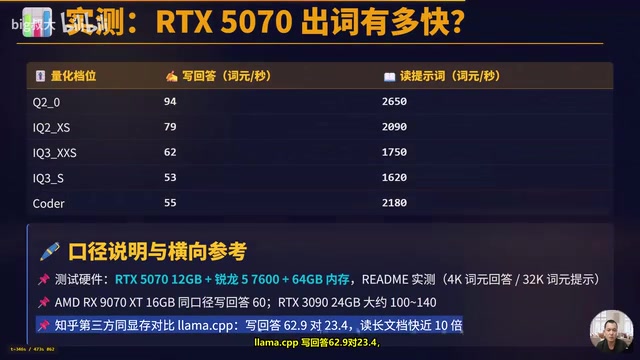
实测平台为RTX 5070(12GB)+ 锐龙5 7600 + 64GB内存,测试条件为4000 token回答、32000 token提示。
写回答速度(token/秒):
- Q2_0:94
- IQ2_XS:79
- IQ3_XXS:62
- IQ3_S:53
- Coder:55
读提示词速度从Q2_0的2650依次下降到IQ3_S的约1620。
横向对比几个参考数据:AMD RX 9070 XT(16GB)同口径写回答约60;RTX 3090(24GB)大约100~140。知乎上有第三方同显存对比显示,Stratavie写回答62.9 token/秒对Llama.cpp的23.4,读长文档更是快了将近10倍。
硬件覆盖面也很广:N卡从RTX 20系到50系全覆盖,A卡包括RX 7900/7800/7700/9060/9070/6800/6900等系列,甚至两张16GB的卡拼着跑也合适。知乎网友实测,5070 Ti笔记本可跑到83 token/秒,5090(32GB)桌面平台跑到207,游戏本加96GB内存同样能打。
这套「穷鬼方案」的边界在哪
能跑不等于没代价,UP主也诚实地列出了四条边界:
一、精度仍有差距:12GB显存只能跑2~3位压缩档,和全精度之间差距存在,追求原汁原味还得上大显存。
二、并发受限:默认一次只处理一个请求,多请求需排队。虽可设 parallel 并行,但12GB卡上每条都会变慢,编码代理的子代理功能也建议关掉。
三、启动成本:首次启动卡顿1~3分钟,且64GB大内存本身也是一笔不小的开销——省了显卡钱,内存预算仍要留出。
四、模型绑定:这套方法专为Qwen3.8 Flash Next这类「条优激活参数接近」的模型优化,接近12GB激活规模的其他模型仍需24GB级显卡。Qwen4的适配据称已在进行中。
关于模型绑定的限制值得多说一句。Stratavie当前的优化路径高度依赖「总参数量极大、但单次激活参数量极小」这一特性——即激活比例要低到让显卡只需承载极少量的实际计算。Qwen3.8 Flash Next激活60亿参数,恰好落在12GB显卡的舒适区间。若换成同样量化后体积相近、但属于稠密架构的模型(激活比例接近100%),显存需求会成倍放大,12GB方案立即失效。因此,这套思路对「超大稀疏MoE」之外的模型架构适用性有限,选型前需确认目标模型的激活参数规模,而非仅看总参数量或量化后体积。
四步回顾
整期内容拢一拢,一张12GB显卡加64GB内存,1250亿参数模型就能在本地跑起来,数据一步不出电脑:
- 稀疏激活 + GSQ-RCO量化,让12GB塞得下1250亿;
- 显卡/内存/CPU/SSD四层仓库分工,先拆后批改再提速;
- start-here或setup脚本一键装,本地接口随便接(OpenAI兼容走
/v1,Anthropic走/v1/messages); - 按内存选档位、按显卡看门槛,装前先对号入座。
对于想在本地跑超大MoE模型、又没有工作站级硬件的用户,Stratavie这套方案提供了一条值得尝试的低成本路径。但需清醒认识到:它用速度和一定的精度损失,换来了「旗舰模型跑进游戏电脑」的可能性,并非免费午餐。
相关推荐

黑人觅食者Alexis Nelson:从觅食到出书,快乐零食别死
黑人觅食者Alexis Nikole Nelson做客Talks at Google,分享从童年跟随母亲认识植物到出版食谱书《Happy Snacking, Don't Die!》的旅程,揭示美国觅食兴衰背后的种族与土地历史。

如何有效呈现你的想法:三种揭示式演讲方法
揭示式演讲是传递想法最直接的方式。本文解析奇妙漫步、动态演示和梦想图景三种演讲类型,结合David Gayo、Michael Pritchard、Sylvia Earle等经典案例,教你如何有效呈现想法。

Modern Web Guidance:让AI写原生声明式对话弹窗
Google Modern Web Guidance 让 AI 编程助手在生成代码时优先使用浏览器原生声明式 dialog 能力,替代重复的 JavaScript 事件监听,实测可显著减少样板代码。