12G显卡本地跑125B大模型?谷歌暂停开源漏洞赏金

本期速报聚焦125B本地推理、谷歌语音小模型、AI编程工具及漏洞赏金被迫暂停等开源动态。
本期AI速报涵盖四个方向的开源动态。StraightA项目宣称可通过量化与内存卸载技术,让125B参数的Qwen模型在12G显卡配合35-55G内存的消费级PC上运行,但实际推理速度仍需实测验证。谷歌开源了约8B参数的Gemma系语音小模型,支持说话人分离与纠错,8G显存即可本地部署,适合隐私敏感的会议记录场景。工具层面,Impactable以确定性规则替代大模型为AI编程提供前端设计规范,OpenMount House则以AGPL 3.0协议开源了一套智能体视频制作系统,商业使用需注意合规风险。此外,谷歌因AI自动化工具导致无效漏洞报告暴增,宣布从10月1日起暂停开源漏洞赏金计划,折射出AI普及对安全治理机制带来的新挑战。
本期AI速报聚焦几个值得开发者关注的开源动态:一个号称能让12G显卡运行125B大模型的推理引擎、谷歌面向语音处理的小模型,以及几条围绕AI编程与智能体视频制作的工具更新。此外,谷歌因自动化提交泛滥,宣布暂停其开源漏洞赏金计划。
12G显卡跑125B?本地大模型推理的新尝试
开源项目 StraightA 的 Readme 中提出了一个颇为激进的说法:它能把一个 125B 参数规模的 Qwen 3.8 Flash Next 模型,跑在拥有 12G 以上显存的消费级 PC 上,前提是需要配备 35 至 55G 的内存。项目采用 MIT 协议开源。
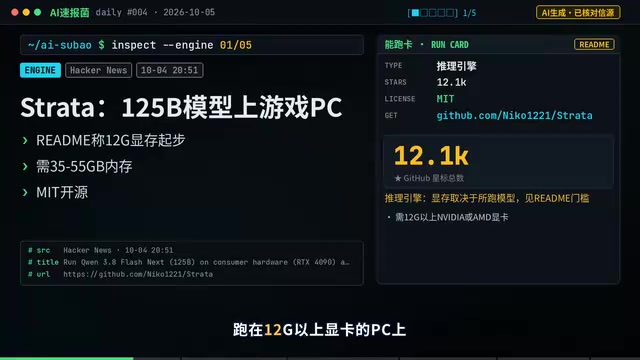
这类方案的核心思路通常是通过量化、内存卸载(offloading)等技术,把模型权重的大部分放在内存甚至磁盘中,仅在需要时调入显存计算。换取的代价是推理速度——用大量内存和带宽去弥补显存容量的不足。对于显卡预算有限、又想在本地体验大参数模型的开发者而言,这提供了一条值得尝试的路径,但实际吞吐和响应延迟仍需以真实测试为准。
量化(Quantization)是压缩模型的核心手段之一,指将模型权重从高精度浮点数(如FP16/FP32)转换为低位整数(如INT8、INT4),以此成倍缩减显存占用。Q4量化意味着每个权重只用4个比特表示,相比FP16可将体积压缩约4倍,但会引入一定的精度损失。内存卸载(offloading)则是另一层补丁:当模型权重超出显存容量时,将暂时不参与计算的层卸载到系统内存甚至磁盘,需要时再搬回显存。两种技术叠加使用,理论上可以在极低显存环境下加载远超容量的模型,但每次数据搬运都会产生额外延迟,实际推理速度往往只有纯显存运行的几分之一。因此「能跑」与「好用」之间仍有较大差距,对延迟敏感的交互场景需谨慎评估。
谷歌开源语音处理小模型
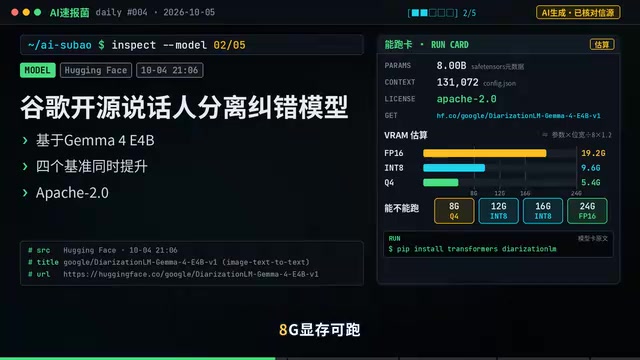
谷歌发布了一个面向语音转写场景的 Gemma 系列小模型(Readme 中标注为 Diarization Gemma 4 E4B 相关),主要用于说话人分离与纠错,全重约 8B 参数。按照 Q4 量化估算,模型体积约 5.4G,8G 显存即可运行。
说话人分离(speaker diarization)是语音转写流程中的关键一环,解决的是「谁在什么时候说话」的问题。将这一能力以小模型形态开源,意味着开发者可以在本地或边缘设备上,把转写与分离整合进自己的工作流,而无需依赖云端API,对隐私敏感的会议记录、访谈整理等场景尤其实用。
说话人分离(Speaker Diarization)与语音识别(ASR)是语音处理流水线中两个相互独立却高度互补的任务。ASR负责「说了什么」,输出文字稿;Diarization负责「谁在说」,输出带时间戳的说话人标签。传统Diarization方案通常基于声纹聚类算法(如x-vector + PLDA),对重叠说话、嘈杂环境的鲁棒性有限。用生成式语言模型承担这一任务,意味着可以结合上下文语义(如称呼、话题切换)来辅助判断说话人身份,对多人会议、访谈等场景的准确率理论上会有提升。谷歌将其整合进Gemma系列并以约8B参数的轻量规模开源,意在让开发者能以较低算力门槛将转写与分离一体化部署,而非依赖两套独立模型拼接。
三条开发者工具动态
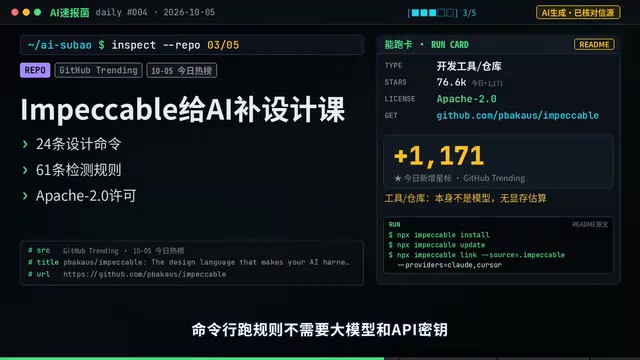
Impactable 为AI编程代理提供了一套前端设计语言。其 Readme 称内置 24 条命令和 61 条确定性检测规则,关键在于命令行即可运行,规则检测不依赖大模型,也不需要 API 密钥。
这种「确定性规则 + 命令行」的设计思路,与当下流行的「一切交给大模型」形成对比。对于前端设计规范这类有明确标准的场景,确定性检测意味着结果可复现、无额外成本,也更容易接入CI流程,是对AI编程工具链的一种务实补充。
OpenMount House 自称是首个开源智能体视频制作系统,Readme 中提到包含 12 条流水线和 100 多个工具。需要特别留意的是,该项目采用 AGPL 3.0 协议——这是一种较为严格的 copyleft 许可,对商业集成有明确的开源义务要求,使用前务必评估合规风险。
谷歌暂停开源漏洞赏金计划
据 TechCrunch 报道,谷歌因自动化提交数量暴增、且大多为无效内容,决定从 10 月 1 日起暂停其开源漏洞赏金计划,并承诺在 2027 年第一季度给出进一步更新。
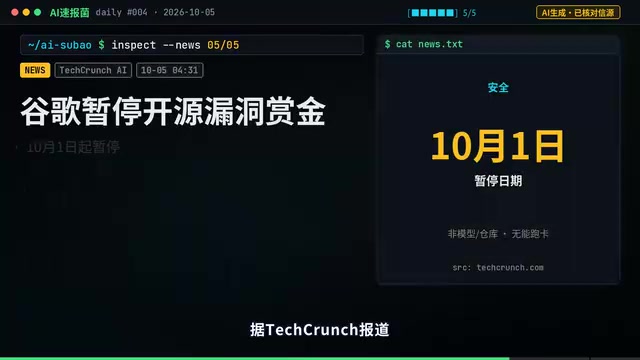
这一调整折射出AI工具普及带来的新问题:自动化批量生成的「漏洞报告」正在挤占安全团队的审核资源。漏洞赏金本意是激励真实的安全研究,但当低质量的自动化提交泛滥,审核成本反而拖累了整个计划的运转。谷歌的暂停并非终止,而是重新设计机制的信号——如何在AI时代过滤噪音、保留有价值的安全贡献,可能是未来漏洞赏金计划普遍需要面对的课题。
漏洞赏金计划(Bug Bounty Program)是企业向外部安全研究人员支付奖励、换取漏洞披露的众包安全机制,谷歌的开源版本(Open Source VRP)专门针对其托管或依赖的开源项目。AI代码生成工具的普及使得批量生成「疑似漏洞」的提交变得极为低廉——研究人员甚至不需要真正理解代码,只需让模型扫描并输出格式化报告即可。这类提交在形式上符合规范,但内容往往是误报或已知问题,安全团队需要逐条人工甄别,审核成本随提交量线性增长。谷歌的应对思路很可能包括引入机器辅助预筛选、提高提交门槛(如要求提供概念验证PoC),或调整奖励结构以惩戒低质量提交——这些方向也是整个行业在AI时代重构信任机制时共同面临的挑战。
小结
从本地大模型推理到语音小模型,从AI编程规则引擎到智能体视频系统,这几条动态共同反映出开源社区在「降低使用门槛」和「务实落地」上的持续发力。而谷歌暂停漏洞赏金的决定,则提醒我们:AI带来的不只是生产力,也包括需要重新设计的治理机制。以上数据与说法多来自项目 Readme 的自述,实际效果建议结合自身场景验证。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。