12G显卡跑1250亿参数大模型:Strata本地部署实测

开源项目Strata用MoE架构让12G显存游戏卡本地跑起1250亿参数大模型,免API费用。
文章介绍了 GitHub 上已有 26000 星的开源项目 Strata,演示如何用一张 12G 显存的游戏显卡本地运行 1250 亿参数的 MoE 大模型,从而摆脱云端按 token 计费、数据上传与高峰限流的困扰。代价是需要下载约 70G 模型并占用 58G 内存。实测 RTX 5070 每秒 94 token,双 RTX 3080 拼机达每秒 109 token。安装可双击脚本或交由 AI 代装,接口兼容 OpenAI 规范,填本机 8080 即可接入各类编程智能体。文章还梳理了按内存选型的建议、常见故障排查以及两个可再提速 4%–10% 的隐藏参数。
云端模型按token收费,本地跑不花钱
还在给云端模型按 token 交钱?B站 UP 主 FT 最近上手了一个 GitHub 上已收获 26000 星的开源项目 Strata,用一台 12G 显存的游戏电脑成功跑起了 1250 亿参数的大模型。整个过程最直观的对比是:云端模型按 token 扣钱、数据要上传、高峰期限流;而 Strata 模型在本地随便跑,不花钱。
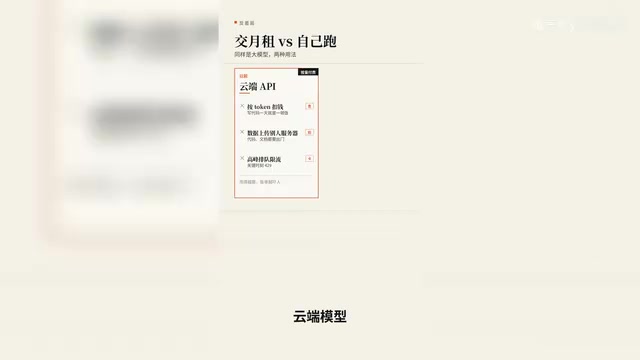
代价也很明确——大约 70G 的模型下载量,加一张 12G 显存的显卡。UP 主在视频里那句总结很到位:"差的不是模型,是你还在交月租。"
实测数据来自它自带的监控页,不是 PPT 跑分:RTX 5070 每秒吐 94 个 token,A 卡 9070 XT 也有每秒 60 个(注:原文另有"独厂温档每秒2650个"表述含混,未予采信)。显存吃到 11.2G,刚好塞满一张 12G 卡;内存用了 58 个 G。单条请求稳定在每秒 50 个 token 左右。
安装简单到离谱:双击脚本,或让 AI 替你装
装法简单到离谱。下载减压后,Windows 双击启动脚本,Linux 跑 setup,全程只问三件事:模型选哪个、上下文多长、看不看图。全程回车即可,70 个 G 断了自动续传,装好浏览器自己弹出来,命令都懒得敲。
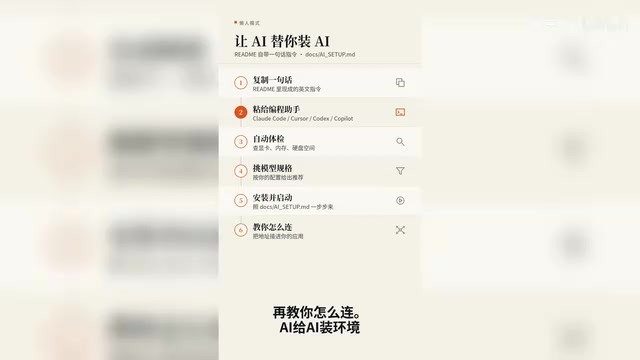
更有意思的是"AI 给 AI 装环境"这条路径:把 README 里那句话直接粘给 cloud code,它会自己查显卡、内存、硬盘,挑好模型、装完启动,再教你怎么连。UP 主对此的评价是"属实离谱"。
装好之后聊天、写代码、看图样样行。思考强度分四档,关掉最快,"高达"这档专啃难题。视频里的规格建议按内存来选:32G 内存选 Coder(专攻写代码,跑分有满写版 91%),48G 选 2 比特,64G 随便装,96G 以上直接上最大。注意聊中文别选 Coder。
文中反复提到的 cloud code 与 Codex 属于"编程智能体"(coding agent)类工具:它们本身不产生智能,而是作为一个外壳去调用背后的大模型 API 完成读文件、改代码、执行命令等任务。这类工具普遍兼容 OpenAI 的 Chat Completions 接口规范,只要把 base URL 指向本机服务、密钥任意填写,就能把后端从云端换成你本地跑着的模型。这也是"地址填本机 8080、密钥随便写"能生效的原因——智能体不再按 token 向云端付费,成本转移到了自己的电费和显卡上。
凭什么塞得下:24000 个小专家,每词只叫醒 10 个
1250 亿参数塞进 12G 显存,靠的是 MoE 架构。模型里有 24000 多个小专家,每个词只叫醒 10 个小助手,先猜大模型再验证,速度提升 6 到 1.8 倍。常用的放显卡,全部的放内存——内存越大越能装。
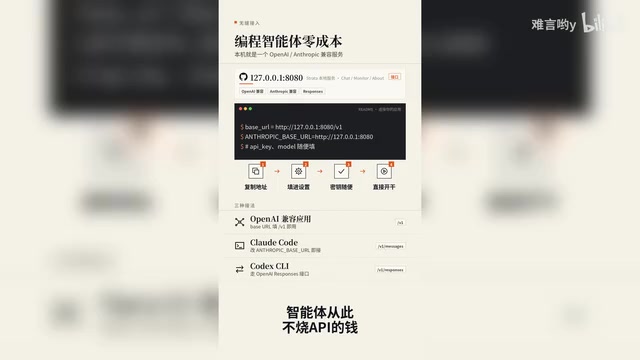
接口支持 OpenAI 应用:地址填本机 8080,密钥随便写,cloud code 改个环境变量就接上,Codex 也行。从此智能体写完不烧 API 的钱。
MoE(Mixture of Experts,混合专家)是一种把大模型拆成多个"专家"子网络的架构。与传统稠密模型每次推理都要调动全部参数不同,MoE 在每一层设有一个路由器(router),对每个 token 计算各专家的匹配分数,只激活得分最高的少数几个专家参与计算。因此模型的总参数量和单次推理实际用到的参数量是两回事:前者决定模型能力上限和存储需求,后者决定算力与显存开销。这正是 1250 亿参数模型能塞进 12G 显存的关键——显存里只需常驻当前活跃的专家,其余专家可以放在内存甚至硬盘上按需换入。代价是内存带宽成为新瓶颈,且不同 token 走不同专家,批处理效率会受影响。
文中"先猜大模型再验证"指的是投机解码(Speculative Decoding)。它的做法是先用一个体积小、速度快的草稿模型连续猜出若干个 token,再交给大模型一次性并行验证这些猜测是否正确,接受正确的前缀、丢弃错误部分。由于大模型一次前向就能校验多个位置,相当于用少量额外计算换取了更多的有效输出,在输出分布不变的前提下提升吞吐。这也是本地推理常见的提速手段,与 MoE 的稀疏激活可以叠加使用。
网友玩疯了:双卡拼机、老卡硬跑
社区已经把配置玩出了花。两张 RTX 3080 拼起来,每秒 109 个 token;官方说一张 3090 有望到 100 到 140。还有人拿老卡 Mac 硬跑。
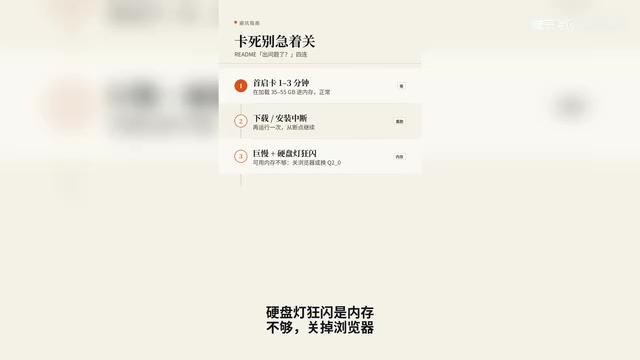
几个常见坑值得提前知道:首次启动卡死了别慌,它在往内存塞几十个 G,等一到三分钟;下载断了就重跑;硬盘灯狂闪是内存不够;关掉浏览器;提示 8080 被占,说明它已经在跑了。
还有两个隐藏提速开关:配置文件里参数加"自适应"、环境变量加"按需锁定",生成快 4% 到 5%,写代码快 7% 到 10%。Windows 读题再快 4.4%。第一次下 70G 模型加载要等好几分钟,之后双击秒开、不重复下载,关窗口就停。想升级跑更新脚本,想加模型再跑一次安装。
上车清单
重点划一下:12G 显存加 32G 内存就能上车;双击安装,或者让 AI 替你装;接口填本机 8080;别光点赞,今晚就让游戏显卡打工。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。