#MoE架构
共 15 篇相关文章

阿里Qwen4-Max发布:2.4T MoE架构、百万上下文
阿里发布Qwen4-Max旗舰模型:2.4T MoE架构、71B激活参数、原生视觉与100万token上下文,输入定价每百万token 1.5美元,Work360基准单任务成本降低62%。本文解析其架构取舍、成本逻辑与闭源旗舰策略。

Thinking Machines发布Inkling 2 Small:594B参数MoE模型
Thinking Machines Lab 发布 Inkling 2 Small,594B 参数 MoE 模型仅激活 17B,Artificial Analysis 得分 31,通过 Tinker 运行并计划以 Apache 2.0 开放权重。
 科技前沿
10款开源MoE模型路由机制对比:DeepSeek、Qwen、Mixtral、Llama 4、gpt-oss
基于配置核查对比10款开源MoE模型的路由机制,解析DeepSeek、Qwen、Mixtral、Llama 4、gpt-oss在专家数量、top-k、共享专家、门控函数与负载均衡上的设计差异,为模型选型与微调提供参考。

DeepSeek V4.1 Flash 1017技术拆解:MoE架构如何突破吞吐瓶颈
深度拆解DeepSeek V4.1 Flash 1017(Max)的技术架构:MoE动态路由如何解决专家饥饿、MLA如何压缩KV缓存突破内存墙,以及TTFT与吞吐提升背后的kernel级调优和部署硬约束。
Reflection-Beam-1.0发布:501B参数MoE模型首日支持vLLM
Reflection-Beam-1.0发布:501B总参数、23B激活的MoE模型,支持1M token上下文与Harmony格式推理,获vLLM Day-0推理支持和SkyRL Day-0强化学习训练支持,混合注意力架构与融合kernel优化细节解析。

Mistral Large 4:欧洲首个万亿参数开源模型深度解析
Mistral AI发布Mistral Large 4预览版:1.05万亿参数多模态MoE模型,每token激活520亿参数,配备16亿参数视觉编码器。开源权重承诺、大规模RL训练管线、网络安全基准测试表现及自托管硬件需求全面解析。

本地部署Qwen3 Next实测:128G显存跑MoE大模型的真实体验
本地部署Qwen3 Next MoE大模型实测体验:128G显存设备上解码速度达241-274 token/秒,运行丝滑。本文梳理硬件平台、性能数据与智能体建模测试,并对内容可信度做客观分析。
8GB显存本地跑大模型:低配玩家的模型选择指南
8GB显存加16GB内存能否流畅运行本地大模型?本文从r/LocalLLaMA社区热帖出发,解析低配硬件下的模型选择、QAT量化技术与MoE架构,为入门级本地AI玩家提供实用参考。
Aleph Alpha开源Kolibri:78B参数MoE模型深度解析
Aleph Alpha发布开源模型Kolibri,采用Apache 2.0许可,78B总参数、3B激活参数的MoE架构,支持100万token上下文和英德双语。本文解析其架构优势、vLLM部署方式及适用场景。
 科技前沿
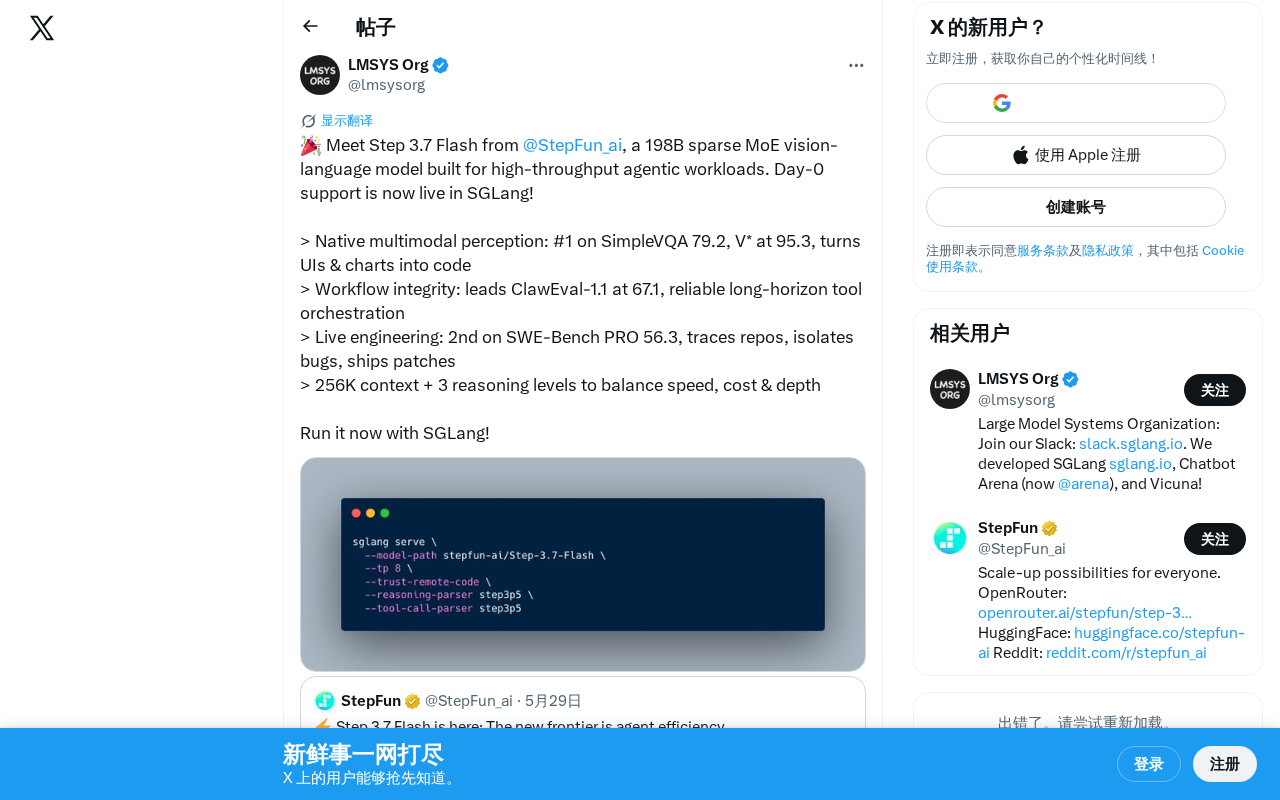
Step 3.7 Flash:198B稀疏MoE多模态模型深度解析
深度解析StepFun AI发布的Step 3.7 Flash,一款198B参数稀疏MoE视觉语言模型,支持256K上下文与三级推理,在多模态理解、AI编程和Agent工具编排方面表现顶尖,已获SGLang首日支持。
 科技前沿
LFM2.5-8B-A1B:1.5B激活参数实现4倍体量效果的MoE模型
Liquid AI发布LFM2.5-8B-A1B模型,采用MoE架构,8B总参数仅激活1.5B,在工具调用场景中媲美6B级模型表现。支持128K上下文、本地部署、多语言,SGLang即时支持。
 科技前沿
Kimi K2.5全量开源:1T参数MoE架构+Agent集群能力深度解析
深度解析月之暗面Kimi K2.5全量开源大模型:1T参数MoE混合专家架构、视觉编程截图转代码、百Agent并行集群能力,在AI编程和多模态理解赛道登顶开源榜首,为开发者提供媲美GPT-4O的免费开源方案。
 产品体验
小米MiMo V2.5 Pro深度实测:代码、3D、SVG生成能力全面评测
深度实测小米MiMo V2.5 Pro开源大模型,1.2万亿参数MoE架构,覆盖macOS克隆、前端UI、Three.js 3D场景、SVG图形生成等实际任务,对比GPT-5.4、Claude Opus 4.6、DeepSeek V4,附详细测试结果与成本分析。
 教程攻略
GPT-OSS开源模型本地部署教程:实测效果与显存占用分析
详细介绍OpenAI开源GPT-OSS模型的本地部署全流程,使用Ollama在RTX 4090上实测20B版本的中文理解、逻辑推理等能力表现,分析MoE架构下的显存占用与硬件需求。
 产品体验
GLM-4.6深度实测:性能、价格与编程能力全面评估
深度实测智谱AI开源模型GLM-4.6,从MoE架构、编程实战、价格对比到适用场景全面解析。输入价格仅$0.06/百万Token,比Claude便宜7-20倍,一次生成代码无需调试,帮你判断是否值得纳入技术栈。