12款AI Agent框架横评:没有一款能阻止Agent超支

调查显示12个主流Agent框架无一提供货币计价的支出预算控制,通用护栏不能替代支付层专项风控。
Pink Agentic AI Payments对LangChain、CrewAI、OpenAI Agents SDK等12个主流Agent框架进行了系统性文档审查,围绕8个维度评估其开箱即用的工具调用控制能力。结果显示:货币计价支出预算(C5)得分为0/12,幂等性(C7)和带参数的审计日志(C8)同样为0/12,仅步数限制(9/12)和人工审批(10/12)覆盖较好。8个框架同时具备审批和步数限制却仍无货币预算,说明通用控制不知道每步花了多少钱。文章论证system prompt不是执行点,步数限制无法映射金额,重试场景下缺乏幂等性可能导致重复扣款。结论是:当Agent能调用支付工具时,预算、白名单、审批和幂等性必须在支付执行层单独解决,而非依赖框架的通用护栏。
一个被12个框架集体忽略的问题
当你的Agent能调用支付工具时,谁来阻止它花光你的钱?
Pink Agentic AI Payments对12个最流行的Agent框架做了一次系统性审查,结果很直白:没有任何一个框架在文档中提供了以货币计价的工具调用预算控制。
这不是小问题。LangChain/LangGraph、CrewAI、OpenAI Agents SDK、Vercel AI SDK、Google ADK、Microsoft AutoGen、Microsoft Semantic Kernel、LlamaIndex、Pydantic AI、Mastra、Claude Agent SDK和smolagents——开发者构建自主Agent时最常用的这些框架,能让你暂停Agent、限制步数、要求人工审批,但没有一个能让你设定"这个Agent今天最多花50美元"并强制执行。
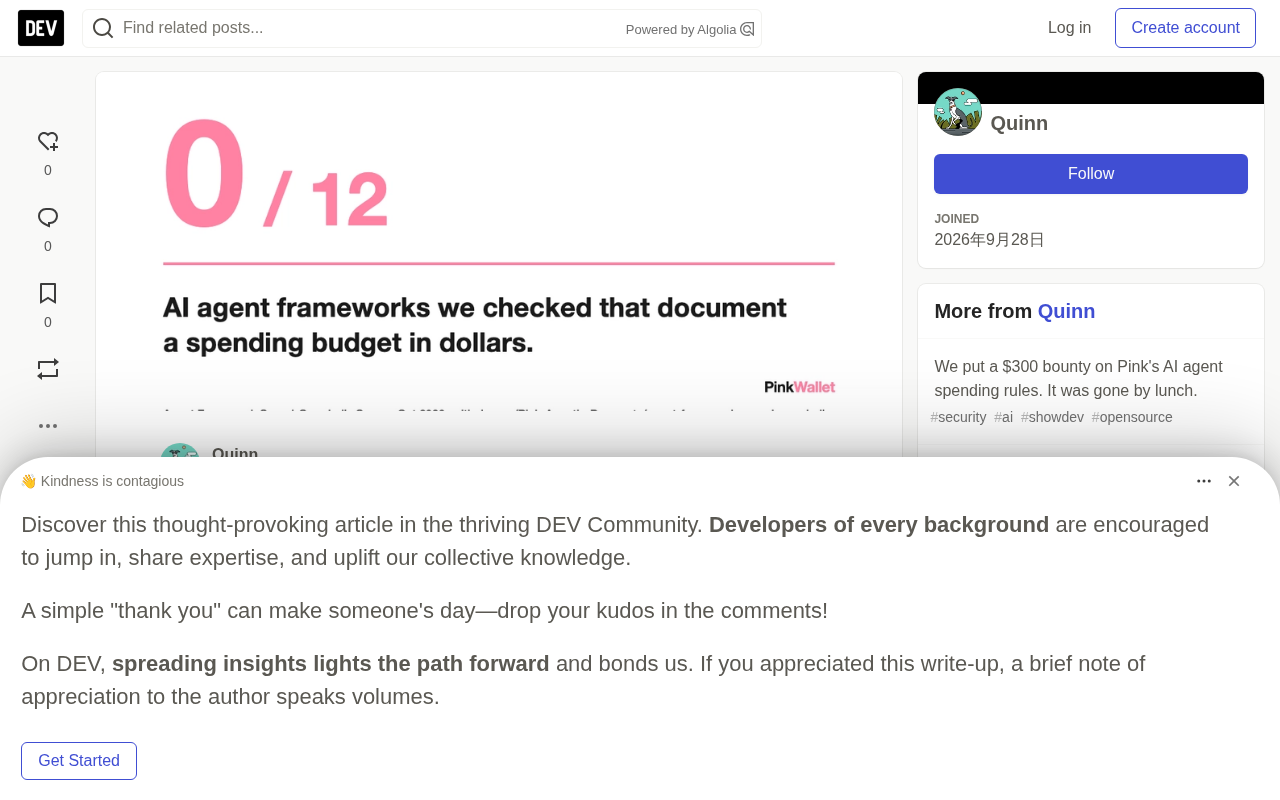
这项调查的方法论相当严格:每个框架只查其官方文档站点或GitHub源码,不采信博客文章、第三方教程或AI生成的摘要。每一个"yes"或"partial"的判定都附有URL和不超过25词的原文引用,任何人都可以独立验证。
八个审查维度说明了什么
调查围绕8个标准(C1-C8)展开,逐项检查每个框架"开箱即用"提供了什么:
- C1 工具执行前的人工审批(human-in-the-loop)
- C2 可编程的按工具守卫/钩子,能在代码层面阻断调用
- C3 最大步数/迭代次数/轮次限制
- C4 单次运行的token或LLM成本预算
- C5 面向工具的货币计价支出预算
- C6 工具调用速率限制/每工具最大调用次数
- C7 工具调用的幂等性/去重
- C8 内置的工具调用审计日志(含参数)
12个框架在C5上的得分是0/12。这倒也公平——它们是通用Agent框架,不是支付产品,货币计价的支出上限从来不是它们的职责。但问题在于:当Agent真的能调用支付工具时,这个缺口就变成了真实的风险敞口。
MCP(Model Context Protocol) 是Anthropic于2024年底开源的一项协议,旨在标准化大语言模型与外部工具、数据源之间的连接方式。在MCP出现之前,每个Agent框架都有自己定义工具接口的方式,导致同一工具需要为不同框架重复适配。MCP将工具抽象为"服务器",模型通过统一的JSON-RPC接口调用这些服务器暴露的"工具",使得支付、数据库、文件系统等能力可以一次实现、多框架复用。本文提到的支出控制产品正是以MCP服务器形式分发,意味着它可以被任何支持MCP的Agent框架挂载,而不需要针对每个框架单独集成。这也解释了为什么支付层控制可以独立于Agent框架存在——MCP提供了一个天然的、框架无关的执行边界。
框架们做了什么,又漏了什么
从数据看,框架们在"通用控制"上表现不错,但在"支付感知"上集体失明。
做得最多的:步数限制。 12个框架中有9个文档化了最大步数或最大迭代限制(C3),这是本次调查中覆盖率最高的控制项。
人工审批覆盖率高但深度不一。 10/12的框架文档化了某种形式的人工介入审批(C1为yes或partial),但只有部分框架能在特定工具调用执行前进行拦截。比如smolagents的agent.interrupt()停止的是整个运行,而非审批单个动作。
可编程阻断钩子也较普遍。 9/12的框架文档化了能在代码层面阻断特定工具调用的钩子(C2),而不仅仅是通过prompt指令。
成本预算覆盖薄弱。 只有5/12的框架文档化了任何token或成本维度的运行预算(C4),其中仅2个是干净的"yes",3个为"partial"。
速率限制几乎空白。 仅3/12的框架文档化了工具调用速率限制或每工具最大调用次数(C6),8个框架完全找不到相关文档。
幂等性是最大盲区。 没有任何一个框架(0/12)文档化了内置的工具调用幂等性或去重机制(C7),9个框架在这一点上完全没有文档。这意味着:超时或重试的支付调用可能重复执行,除非支付层自己做了去重。
审计日志同样缺失。 没有任何框架文档化了带参数的内置工具调用审计追踪(C8)。6个框架有tracing、telemetry或内存中的运行日志记录工具调用,被归为partial。
一个值得注意的组合是:8/12的框架同时具备审批步骤和步数限制,却仍然没有货币计价预算。 这说明了一个核心问题——步数限制和审批提示不知道每一步花了多少钱。
幂等性(Idempotency) 是分布式系统中的核心概念,指同一个操作执行一次和执行多次产生的结果相同。在支付场景中,这意味着即使请求因超时被重试,资金也只应被扣除一次。业界通行做法是客户端为每笔支付生成唯一的幂等键(idempotency key),服务端记录已处理的键,遇到重复键时直接返回首次结果而非再次执行。Agent框架天然容易触发重试:网络超时、模型重新规划、步数循环都可能让同一个工具调用被多次发出。如果框架不内置幂等去重,开发者就必须在支付工具的实现层自行维护幂等键和去重表,否则一次本应失败的支付可能变成两次成功扣款。
通用控制为什么不够用
把支出规则写进system prompt("永远不要花超过100美元")不是控制手段。Prompt是对模型的建议,不是执行点,没有任何机制能阻止一个忽略它的工具调用。
步数限制在N个动作后停止Agent,不管这些动作移动了5美元还是5万美元。审批提示说"批准这个工具调用",却不告诉审批人金额、收款方,或者是否符合政策——除非开发者自己构建这些逻辑。
真正需要的地方是支付实际执行的节点。如果Agent能调用移动资金的工具,那么预算、收款方白名单和审批步骤必须存在于支付层,而不是Agent框架的通用步数或token计数器里。
重试场景同样关键。由于12个框架都没有文档化内置的幂等性,一次超时或重试的支付调用可能重复执行,除非支付层自己做了去重。
System prompt作为控制手段的局限性值得展开:System prompt是模型推理的输入上下文,模型在生成下一个动作时会"参考"它,但没有任何运行时机制能强制模型遵守。这与代码层面的guard(守卫)有本质区别——guard在工具调用真正执行前拦截并抛出异常,是确定性的执行点。把"不要花超过100美元"写进prompt,相当于把财务风控交给一个可能被后续对话内容覆盖、被越狱提示绕过、或单纯因模型幻觉而忽略的软约束。真正可靠的预算控制必须在工具执行的代码路径上完成:在支付工具被调用前,检查累计金额、收款方、单笔限额,任一不满足则拒绝执行并返回结构化错误,而不是寄希望于模型自觉。
缺口背后的产品逻辑
这项调查由Pink Agentic AI Payments发布——他们构建的正是MCP服务器形式的按Agent支出控制产品,包括预算设定、金额规则、收款方允许/阻止列表和阈值以上的人工审批,在支付执行前进行检查。调查结果与他们的产品直接相关,原文也做了披露。
这并不意味着调查数据不可信。恰恰相反,完整数据集、方法论和能从survey.csv重新生成所有数字的compute.py脚本都放在GitHub上,采用CC BY 4.0许可。如果你维护上述任何一个框架,发现某个单元格有误或过时,可以提交包含文档链接的更正issue。
透明度足够高,数据自行说话。对于正在构建能调用支付工具的Agent的开发者来说,这项调查指出了一个明确的事实:Agent框架的通用护栏不能替代支付层的专项控制。 如果你的Agent能花钱,你需要在框架之外,单独解决预算、白名单、审批和幂等性问题。
相关推荐

OpenCode保姆级教程:从安装到实战,零基础快速上手
OpenCode保姆级教程:详解OpenCode安装的桌面版、命令行与WSL三种方式,剖析其Agent编程助手与聊天助手双重定位,附核心配置、模型选择与真实使用体验评价。

FDE前沿部署工程师:AI落地的新风口岗位全解析
解析FDE前沿部署工程师岗位:从Palantir起源到OpenAI、Anthropic等大厂实践,拆解FDE与普通工程师的核心差异、岗位能力清单与程序员转行方向,把握AI落地新风口。

Rivian旗下Mind Robotics挖来Doug Field任总裁
Rivian分拆的机器人初创公司Mind Robotics任命苹果Project Titan前负责人Doug Field为总裁。本文解析这次人事任命背后的技术迁移逻辑、Rivian的分拆策略,以及自动驾驶人才流向机器人赛道的行业信号。