13分钟搞懂开源模型:AI Agent技术栈与成本优势全解析

开源模型凭借掌控权、极低成本与可审计性崛起,中国模型成为全球主力。
文章系统梳理了开源 AI 的定义、优势、格局与局限。开源模型允许用户本地部署、微调与二次开发,闭源模型则只能通过 API 或平台调用。DeepSeek R1 的发布是转折点,使开源模型首次能与顶尖闭源模型抗衡,Vercel 数据显示 Token 使用正明显向开源倾斜。四大优势分别是完全掌控、成本悬殊(输出价格差距可达数百倍)、可审计性和促进二次创新。全球顶级开源模型几乎都来自中国,A16Z 合伙人称美国初创公司有 80% 概率使用中国模型,Airbnb、Cursor、Perplexity 等均有实际采用。文章也指出配置复杂、硬件门槛、开箱即用性差和数据自管等局限,并给出模型层、Ollama、编排工具组成的 Agent 技术栈,强调信息所有权与平台风险是当下必须关注开源的核心原因。
开源模型到底是什么?
开源人工智能(Open Source AI)指的是部分或全部核心组件由开源软件构建的AI系统。你不仅可以使用它,还能拿到部分核心组件进行部署、修改甚至二次开发。与之相对的闭源AI(Closed Source AI),用户只能通过API、网页应用或企业平台使用,背后的技术并不公开。
一个形象的比喻:闭源AI像租来的车,能开能用,但发动机设计、核心参数你完全看不到也改不了;开源AI则像拿到了部分设计图和零件,可以自己动手改装。
据B站UP主的梳理,从ChatGPT问世以来,闭源模型长期占据主导地位,OpenAI和Anthropic两家公司是全球AI的主角。直到2025年1月DeepSeek广告 R1发布,开源模型才第一次真正能与当时最顶尖的闭源模型相媲美。这件事的意义在于,它为更多开源模型的研发打开了大门。
这一转折的直接反映是使用趋势的变化。网页和AI应用的云部署平台Vercel发布的一张图显示,其平台上开源模型与闭源模型的Token使用比例正在明显向开源倾斜。
开源许可证与模型权重的区别值得单独说明。传统开源软件(如 Linux)的核心是源代码开放,而 AI 模型的"开源"判断标准更复杂:除了推理代码,关键在于模型权重(即训练后得到的参数文件)是否公开可下载。业界常用的许可证包括 Apache 2.0、MIT(较宽松,允许商用和闭源衍生)以及 OpenRAIL-M、Llama Community License 等带有使用限制的自定义许可证。因此"开源模型"内部也有光谱:有的完整公开权重、训练细节和数据配方,有的只公开权重而训练数据保密。理解这一点,才能准确评估一个模型的实际开放程度与商用自由度。
开源模型的四大核心优势
完全掌控与自由定制
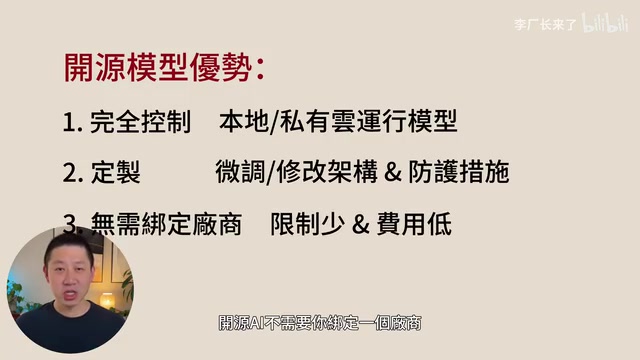
开源模型可以跑在本地设备和私有云上,你能进行微调、修改架构,还能加入自己喜欢的防护措施。它不需要绑定某个厂商,而闭源AI意味着你得绑在对方的生态里,限制更多、费用更高。
成本差距悬殊
成本是开源AI最大的优势之一。以输出价格为例,Claude Fable 5每输出100万Tokens要50美元,而DeepSeek V4 Flash每输出100万Tokens只需要18美分,差距极其悬殊。当然,当遇到特别棘手、开源模型解决不了的问题时,额外付费用闭源模型仍然是值得的。
可审计性
开源AI能被审计,这对医疗、金融等受监管行业尤为重要。
受监管行业为何特别看重可审计性:在医疗、金融、保险等领域,监管机构(如金融监管局、FDA、欧盟 AI Act)要求算法决策可追溯、可解释。使用闭源 API 时,企业无法查看模型内部逻辑,也无法在监管问询时提供模型版本、参数和训练数据的证据链。将开源模型部署在自有环境中,企业可以保留完整日志、固定模型版本、做差分测试和偏差审计,必要时还能对模型进行修改以满足合规要求。这也是许多金融机构宁可在私有云上运行开源模型、也不愿直接调用闭源 API 的核心原因。
促进二次创新
全球开发者都能参与进来,为开源模型做贡献。网上已经有超过15万个通义千问广告的衍生模型,开发者下载后进行各种定制化微调,懒得自己动手的人直接下载现成的即可。
中国开源模型为何成为全球主力
目前全球顶级的开源模型几乎都是中国研发的。从下载量数据看,美国一直领先,但到2025年6至7月发生逆转,中国模型的下载量开始飙升。
美国大型风险投资公司A16Z的合伙人Martin Casado表示,现在美国的初创公司有80%的概率用的是中国做的开源模型。实际案例也印证了这一点:法律AI领域的重要玩家采用阿里巴巴的通义千问,AI编程公司Cursor用的是Kimi K2.5,全球最大短租平台Airbnb也在用通义千问,AI智能搜索公司Perplexity用的是DeepSeek模型。
这些公司选择中国开源模型,除了成本,更重要的是隐私保护——处理客户敏感信息时,企业希望用自己能完全掌控的模型,并会用内部数据对模型进行微调。
有人担心用中国开源模型会把数据跑到中国服务器上,这种担心没有必要:开源的意义就在于你可以把它下载到本地,按自己的方式部署,数据隐私有保障。
面对这一趋势,西方也开始加大开源投入。OpenAI在几周前将GPT5.6 LUNA模型价格下降了80%,GPT5.6 SO的输入和输出Token价格也分别下降了20%和33%。对普通消费者来说,这意味着用更少的成本用到更好的模型。
开源模型的局限与挑战
开源并非没有代价。首先是配置复杂,不像闭源模型点个链接就能用,开源模型需要多几步操作。其次硬件是门槛,运行开源模型需要大量资源,基于大部分人现有的硬件,能运行的模型是有限的。第三,它不像常用的大语言模型那样开箱即用,缺少用户已经习惯的各种功能。最后,没人帮你管理数据,数据安全需要自己负责。
尽管有这些局限,当前正处在开源模型的爆发期。放在两年前,没有商用级硬件或专业编程技能,普通人根本做不到这些。
构建AI Agent的开源技术栈
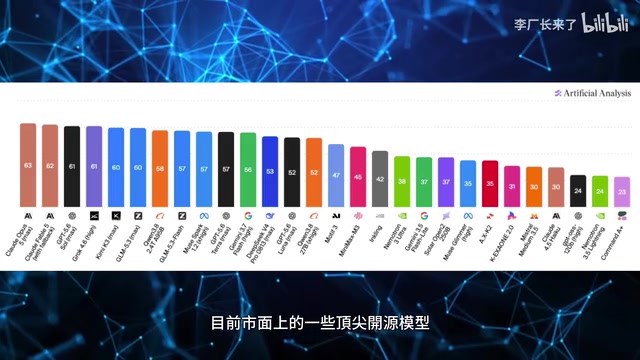
开源AI技术栈不是某一个工具,而是从底层模型到最终应用的整套技术和框架组合。
模型层:截至视频录制时,顶尖开源模型包括月之暗面的Kimi、智谱的GLM、阿里巴巴的通义千问。模型排名会不断变化,可以在 artificialanalysis.ai、LLM Stats、Arena Leaderboard 等网站比较当前顶尖模型,也可以选择性能没那么强但满足任务需求的模型。
模型管理器:如果想本地运行和开发,最受欢迎的工具是Ollama。下载安装后直接下载想试用的模型即可运行,它简化了大量设置,尤其适合新手。
Agent编排:给模型权限、工具、记忆和背景知识,就是在构建自己的AI Agent。常用编排工具包括n8n,开发者也可以用OpenAI的Agents SDK和谷歌的Agent Development Kit,它们都支持开源模型。开源模型和基础设施在AI编程领域尤其火爆,值得关注相关开源编程工具。
为什么现在必须关注开源模型
最核心的是信息所有权。使用闭源模型时,即便没有敏感信息,你实际上也在告诉这些公司你是如何操作的,它们因此获得足够数据训练自己的模型。Anthropic的Fable模型就因保留用户数据而受到不少批评。
这引出了平台风险:当所有信息绑定在一家公司上,你承担的风险最大。如果哪天OpenAI或Anthropic倒闭,数据可能就全没了。开源模型则不同,市面上有几十个选择,觉得不好随时可以换,商业竞争对用户是好事。
定制化同样是关键优势。你可以把所有数据喂给模型,让它学会你的生意怎么做、软件怎么开发。
总结来看,开源模型让用户用更便宜的Token获得更好的使用体验,对隐私和数据安全有完全控制权。它很可能成为推动企业和个人把AI整合进工作流程的关键推手。
背景补充
本地推理中的量化与硬件门槛:在本地运行开源模型时,用户常会遇到"模型太大跑不动"的问题,量化(Quantization) 是主要解决方案。它把模型权重从 16 位浮点数压缩到 8 位、4 位甚至更低精度,大幅降低显存占用和内存需求,代价是精度略有损失。常见格式包括 GGUF(配合 llama.cpp 生态,Ollama 即基于此)。例如一个 70B 参数的模型在 FP16 下需要约 140GB 显存,而 4 位量化后可压缩到 40GB 左右,使消费级显卡甚至部分高端笔记本可以运行。理解量化等级(如 Q4_K_M)有助于在效果与硬件成本之间做权衡。
Agent 编排的本质是把大模型从"一问一答"升级为"能规划、能调用工具、能记住上下文"的执行体。一次典型的 Agent 循环包括:接收目标 → 拆解任务 → 调用工具(搜索、代码执行、数据库查询)→ 观察结果 → 修正计划。工具调用(Function Calling / Tool Use) 是其中关键能力,模型需要按结构化格式输出要调用的函数名和参数。记忆则分为短期上下文窗口和长期向量数据库检索(RAG)。n8n 这类可视化工具把上述流程做成节点拖拽,而 Agents SDK 和 ADK 提供代码级控制。选择开源模型时,必须确认其是否支持稳定的工具调用格式,否则编排链路容易断裂。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。