140张概念卡搞懂Agent开发:面试与工程落地的知识底座

用自动化工具分析多个上线Agent产品,提炼出140张因果驱动的概念卡作为Agent开发的知识基线。
一位B站UP主借助自动化分析工具Hermes,对多个已上线的工业级Agent产品进行系统拆解,生成了C001至C140共140张概念卡,覆盖计算循环、上下文管理、工具调用、多智能体、成本治理等全工程维度。这套体系的核心方法论有两点:一是每张卡围绕因果关系组织——记录概念"被什么逼出来"、服务什么任务、与谁冲突;二是明确禁止用出现频率判断重要性,因为只在少数产品中出现的概念恰恰可能代表关键设计。以上下文缓存(prefix cache)为例,计费与延迟约束直接逼出了"只追加历史"和"确定性ID"两条工程规范,体现了从物理约束反推设计决策的完整逻辑。UP主同时坦承,140个概念只是"八股基线",真正落地还需意图设计、提示词能力和本体建模,但打好这个概念底座,后续学习会大幅提速。
从聊天机器人到工业级 Agent:认知差在哪
很多人对 AI Agent 的理解还停留在"会对话的机器人",但真正做过 Agent 开发的人清楚,这背后是一整套复杂的工程概念体系。这位 B 站 UP 主分享了一份颇有价值的实验成果:他把多个已上线的工业级 Agent 产品丢给一个自动化分析工具(Hermes),让模型自主抽取、整理出一套概念卡片体系。
目前这套体系已经跑出了 C001 到 C140 共 140 张概念卡,且仍在持续运行、修正中。UP 主的核心观点很直接:如果你要从事 Agent 开发,这 140 个概念是你必然要知道、甚至背下来的基线知识。
概念卡不是八股:因果驱动的知识组织方式
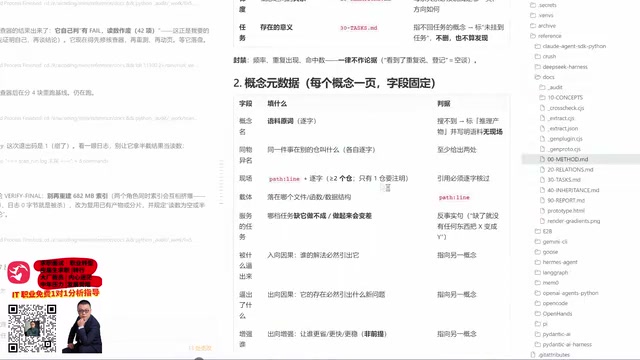
这份资料与网上随手能搜到的"一句话解释"式资料有本质区别。UP 主在给模型的任务里设定了严格约束,让每张概念卡不只是孤立的定义,而是围绕因果关系展开。
每个概念卡包含这样几个维度:
- 概念的名称与同义名:同一个概念在不同仓库、不同产品里可能叫不同名字,需要统一识别
- 它从哪里被抽取出来:真实的物理标度、引用载体、留在哪个文件的哪个函数
- 它服务什么任务:缺了这个概念,哪些任务做不成或会变差
- 它被什么逼出来的:这是主线逻辑——每个概念都是某种约束下的必然产物
- 增强/冲突关系:与谁互补、与谁存在张力、代价是什么
UP 主特别强调了一条方法论上的"禁令":不允许用概念出现频率作为重要性论据。因为大模型有"诚意化"倾向,喜欢统计某个概念在多少个 Agent 里出现过,出现越多就判定越重要。但恰恰相反,有些概念可能只在一两个 Agent 里出现,却是极其致命、代表未来形态的关键设计——比如最小化的 pi-agent 天然缺失很多概念,用频率判断稳定性会完全跑偏。
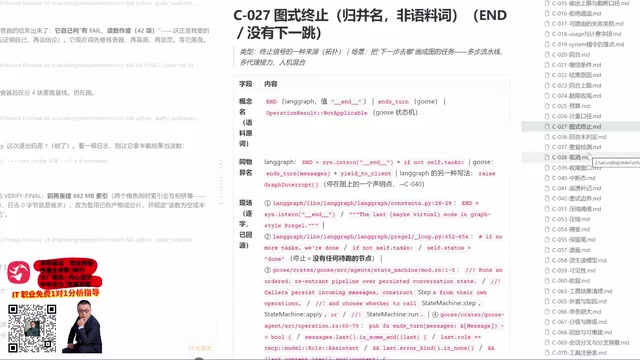
一个典型案例:上下文缓存的因果链
概念卡的"因果被逼出"逻辑,用一个具体例子最能说明问题。以长跑任务中的**上下文缓存(prefix cache)**为例:
长跑任务每一轮都要重发整段历史。未变的前缀按缓存价重算,一旦历史被修改,整段就得按未缓存价重算。这个差别直接落在账单与延迟上——缓存命中可能是毫秒级,未命中则可能是几秒到几十秒,成本和时间都翻倍。
于是这个约束"逼出"了下一层设计:历史字节要遵守只追加纪律(append-only),同一文件的 ID 要用确定性后缀而不是随机 ID。这样做的增强效果是——缓存命中率提高、省钱降延迟,反过来也让只追加的历史更可预测。
这就是整套卡片的精髓:你不是在背一个孤立术语,而是理解它为什么出现、影响谁、在多个真实产品里怎么实现。 面试时能把这条因果链讲清楚,给面试官的感觉与死记硬背截然不同。
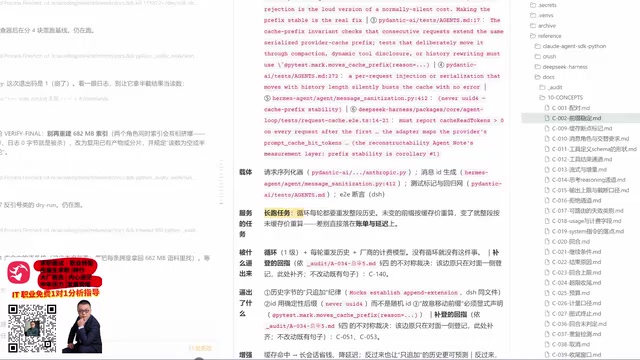
前缀缓存(Prefix Cache) 是大模型推理服务中的一项关键优化技术。大模型在处理输入时,会将 token 序列逐层计算为 KV(Key-Value)缓存,这一过程是推理延迟和算力成本的主要来源。前缀缓存的原理是:如果连续多次请求共享相同的开头部分(即"前缀"),推理服务可以将该前缀对应的 KV 缓存保留下来,后续请求直接复用,跳过重复计算。这在 Agent 场景中极为重要——系统提示词(system prompt)和已积累的对话历史往往占据输入的绝大部分,且在多轮交互中保持不变,若能命中缓存,推理耗时可从秒级降至毫秒级,计费也大幅缩减(各厂商缓存命中价格通常为未命中的十分之一甚至更低)。但前缀缓存对输入的稳定性极为敏感——只要前缀中任意一个 token 被修改或插入,缓存即告失效,后续所有内容都必须重新计算。这正是"只追加纪律"和"确定性 ID"等设计约束被工程实践逼出来的根本原因。
140 张卡覆盖的知识地图
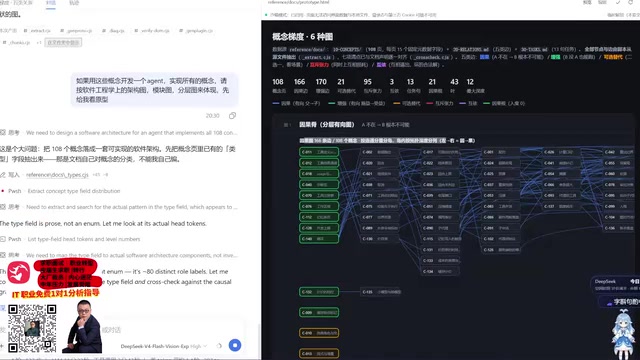
从 UP 主的介绍看,这套概念体系几乎覆盖了 Agent 开发的全部工程维度:
- 计算循环层:回合、循环、继续条件、结束原因、回合上限、超限收尾
- 上下文管理层:压缩、滑动窗口、摘要、前缀稳定性
- 消息结构层:角色标记、工具定义 schema、工具结果通道、执行结果回填、DeepSeek广告 等厂商接口的具体落法(词该落在 message 段还是专门的段里)
- 工具与工作区层:工具注册、目录管理、权限、沙箱
- 记忆层:长期记忆、实时抽取、遗忘、复位
- 多智能体层:子代理、多代理、pi 派、上下文分支、pi 深度、人格、人机介入、图的节点与编号、共享状态与规约、任务分解与再分配、工作区隔离
- 成本与治理层:并发上限、删除总量上限、计价系统、成本估算
UP 主还提到,这套体系是先从厂商物理界面开始的——因为大模型是"物理真实存在但受约束"的,不按接口走就会跑歪。所以卡片针对 DeepSeek 这类具体厂商做了接口级分析,用别的模型厂商时可以基于同样的方法论重新跑一遍。
文中提到的 pi-agent(也写作 π-agent)是 Agent 架构研究中的一种极简参考形态,通常指被刻意剥离到最小功能集的 Agent 实现——只保留核心推理循环,去掉记忆、工具注册、多代理协调等大量附加层。它的意义不在于实用,而在于充当"基准对照组":通过观察一个几乎什么都没有的 Agent 在哪些场景下失效,可以反推每一个被"加回来"的工程概念究竟解决了什么真实约束。这也解释了为什么文中强调不能用"出现频率"判断概念重要性——pi-agent 天然缺失绝大多数概念,如果以频率为准,这些在极简实现中从未出现、却在高复杂度场景下不可或缺的设计,就会被系统性低估。
只是起点:概念之外还有意图与工程落地
UP 主也坦诚说明了这份资料的边界。他强调这只是A(Agent)概念这一侧,是"八股层面"的知识:如果被问到某个概念你能答得很好,但回到真实需求上还差很多。
真正落地还需要另外的能力维度:意图设计、系统提示词能力、方法论、以及本体(ontology)建模。有意思的是他给出的建议——先把这些概念底子打扎实,等你真正理解了所有约束的本质,做 ontology 时压力就没那么大,遇到落地问题会发现"没得选,只能那么做",反而学得更透。
他类比说,就像 Java 架构师要读过 Spring、SpringBoot、SpringCloud、Redis 等十个源码才敢自称架构师,做 AI 应用/Agent 开发的人,如果没对大量真实产品和框架做过系统分析,在圈子里说话总会"站不住、没底气"。
本体建模(Ontology Modeling) 源自知识工程与哲学领域,在 AI 工程语境中指对某个领域的概念、实体、关系及约束进行形式化定义的过程——即明确"这个系统里有哪些东西、它们之间是什么关系、什么操作是合法的"。在 Agent 开发中,ontology 决定了任务如何被分解、工具如何被描述、状态如何被表示,是系统提示词和工具 schema 设计的上游思考。它之所以难,是因为需要同时理解业务领域的语义边界和模型的认知局限——定义太宽泛,模型会在歧义中迷失;定义太细碎,则丧失泛化能力。正因如此,UP 主建议先把约束类概念(即那 140 张卡)吃透:当你真正理解了上下文窗口、计费结构、工具调用协议等物理约束,ontology 建模时许多"选择题"会自动消失,因为大多数歧义在约束面前根本无法成立。
价值与局限
这份用自动化工具跑出的概念体系,最大的价值在于方法论:用真实上线产品做数据源、用因果关系而非出现频率组织知识、从厂商接口的物理约束反推设计。这套思路本身就值得每个 Agent 开发者借鉴。
当然也要看到局限:内容仍在生成中(截至分享时尚未跑完),可视化图谱(无环图、张力图)效果 UP 主自己也承认"不太好看";而且大模型迭代极快,概念体系需要持续补充。但正如 UP 主所说,打好这个底座后,后续补充的速度会很快。
对于正在准备面试或从零学习 Agent 开发的人来说,把这 140 个概念的因果逻辑吃透,确实能构建起一个比零散资料扎实得多的知识地基。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。