16GB GPU微调Qwen:让模型回答禁用字母e

在16GB GPU上微调Qwen模型,使其回复避开字母e,探索约束满足型生成与小显存微调。
本文介绍了一项趣味实验:在16GB GPU上微调Qwen模型,要求其生成的回复完全不包含字母“e”。文章分析了该任务对词汇选择、句法结构的挑战,讨论了16GB显存下通过LoRA等参数高效微调技术实现模型定制的可行性,并详述了构造训练数据(改写以剔除字母e)的难点与tokenization层面的问题。文章指出此类约束满足型生成任务可检验模型对硬性规则的遵循能力,同时体现了小显存微调的普及趋势。最后强调原始分享缺少细节,效果难以量化,建议后续工作建立评估集进行复现。
一个有趣的约束:当语言模型必须避开字母e
在Hacker News上,有开发者分享了一项颇具趣味性的实验:在16GB GPU上微调Qwen模型,使其生成的回复完全不包含字母“e”。这个看似简单的约束,实际上对语言模型的词汇选择、句法结构和生成策略提出了不小的挑战。字母“e”是英语中出现频率最高的字母之一,禁用它意味着模型需要绕开大量常用词,比如“the”、“be”、“are”、“we”、“they”等,从而被迫使用更迂回或更少见的表达方式。
这项实验的核心价值不在于产出实用的对话系统,而在于探索模型在极端约束下的适应能力。它像是一场语言游戏,却能揭示模型对字符级指令的遵循程度、微调数据的设计技巧,以及小显存环境下的训练可行性。
硬件门槛:16GB显存下的微调现实
在16GB GPU上微调语言模型,是一个对显存管理要求很高的任务。Qwen系列包含不同参数规模的版本,开发者需要选择与显存匹配的模型尺寸,并借助参数高效微调技术(如LoRA)来降低训练开销。原文信息有限,没有透露具体的Qwen版本、微调方法和训练数据规模,但可以确定的是,16GB的显存足以支撑中小规模模型的轻量级微调。
这一实践的意义在于降低了实验门槛。并非每个人都有多卡A100集群,但一块消费级或工作站级的16GB显卡就能完成有明确约束的微调任务,这让更多开发者能够尝试自己的想法。
参数高效微调(PEFT)与LoRA
LoRA(Low-Rank Adaptation)是参数高效微调的代表性方法。它不修改预训练模型的原始权重,而是在Transformer层的注意力模块中注入低秩矩阵,训练时只更新这些小规模参数。例如,对于一个d×d的权重矩阵,LoRA将其分解为两个低秩矩阵A(d×r)和B(r×d),其中秩r通常取8、16或64,远小于d。这样可训练参数从d²降至2dr,显存占用和计算量大幅降低。在16GB GPU上,LoRA使得7B参数级别的模型微调成为可能,因为大部分显存被冻结的模型权重占据,而优化器状态和梯度仅针对少量LoRA参数。
量化技术
量化是另一项关键显存优化技术。它通过降低模型权重和激活值的数值精度来减少显存占用,常见形式有8位整数(INT8)和4位整数(INT4)量化。例如,将FP16权重量化为INT4,显存占用可降至原来的四分之一。结合LoRA,量化低秩适配(QLoRA)进一步降低了微调门槛,使得在单块16GB GPU上微调更大模型成为现实。
禁用字母e:模型如何学会“文字游戏”
要让模型稳定地输出不含字母“e”的文本,仅靠推理时的提示词约束往往不够可靠,微调是更直接的手段。核心思路是构造训练数据:输入常规问题,输出经过人工或程序处理、剔除了字母“e”的回复。模型通过监督微调学习这种映射关系,逐渐内化“避开e”的生成习惯。
这里的难点在于数据构造的质量。简单地删掉e会导致拼写错误和语义断裂,需要重写句子、替换词汇,同时保持语义通顺。这种数据清洗和改写的工作量可能远超训练本身。另外,模型在生成时仍需处理tokenization层面的问题——字母e可能隐藏在子词单元中,模型需要学会在解码阶段规避特定字符。
Tokenization与字符级约束
语言模型并不直接处理字符,而是通过分词器将文本切分为子词单元(token)。字母“e”可能作为独立token出现,也可能嵌入在更长的子词中(如“the”中的“e”)。因此,要求模型避开字母“e”实际上是一个字符级约束,而模型的生成过程是基于token的。要在解码阶段规避特定字符,需要建立token到字符的映射,并在生成时动态屏蔽包含目标字符的token候选。微调时,模型通过训练数据学习到哪些token序列符合约束,但tokenization的粒度仍可能导致意外包含“e”的情况,这增加了任务难度。
这类实验的启示
约束生成是检验模型能力的试金石。 类似“禁用某个字母”的任务属于约束满足型生成,它测试的不仅是语言流畅度,还有模型对硬性规则的遵循能力。这类能力在需要格式控制、敏感词规避或风格限定的实际场景中有对应价值。
小显存微调正在普及。 16GB GPU完成Qwen微调说明,参数高效方法和量化技术的成熟让个人开发者也能进行有意义的模型定制。实验的门槛从“拥有集群”降到“拥有一块不错的显卡”。
趣味项目驱动技术传播。 用禁止字母e这样的创意任务作为载体,比枯燥的基准测试更容易引发社区讨论。它把微调流程、显存优化、数据构造等知识点包装成一个可传播的话题,对技术普及有正面作用。
约束满足型生成
约束满足型生成(Constrained Generation)指模型在生成文本时必须满足特定硬性条件,如禁用某些词汇、遵循特定格式、或控制情感极性。与常规生成任务不同,它要求模型在解码过程中主动规避违反约束的输出,而不仅仅是追求流畅性或相关性。这类任务在工业界有广泛应用,例如生成不含敏感词的营销文案、符合JSON格式的API响应、或避免性别偏见的文本。评估时通常需要同时衡量约束遵循率(Constraint Satisfaction Rate)和语言质量(如困惑度、人工评分),两者往往存在权衡。
局限与未解之处
原始分享只提供了标题和少量互动数据,缺少模型版本、训练细节、评估方法和实际效果展示。因此无法判断模型在禁用e的任务上达到了多高的准确率,也不清楚是否出现了语义质量下降。这类实验的真正价值需要更完整的复现记录来支撑。对于想尝试的开发者,建议从明确的评估集出发,量化模型在约束遵循和语言质量两个维度上的表现。
相关推荐
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。
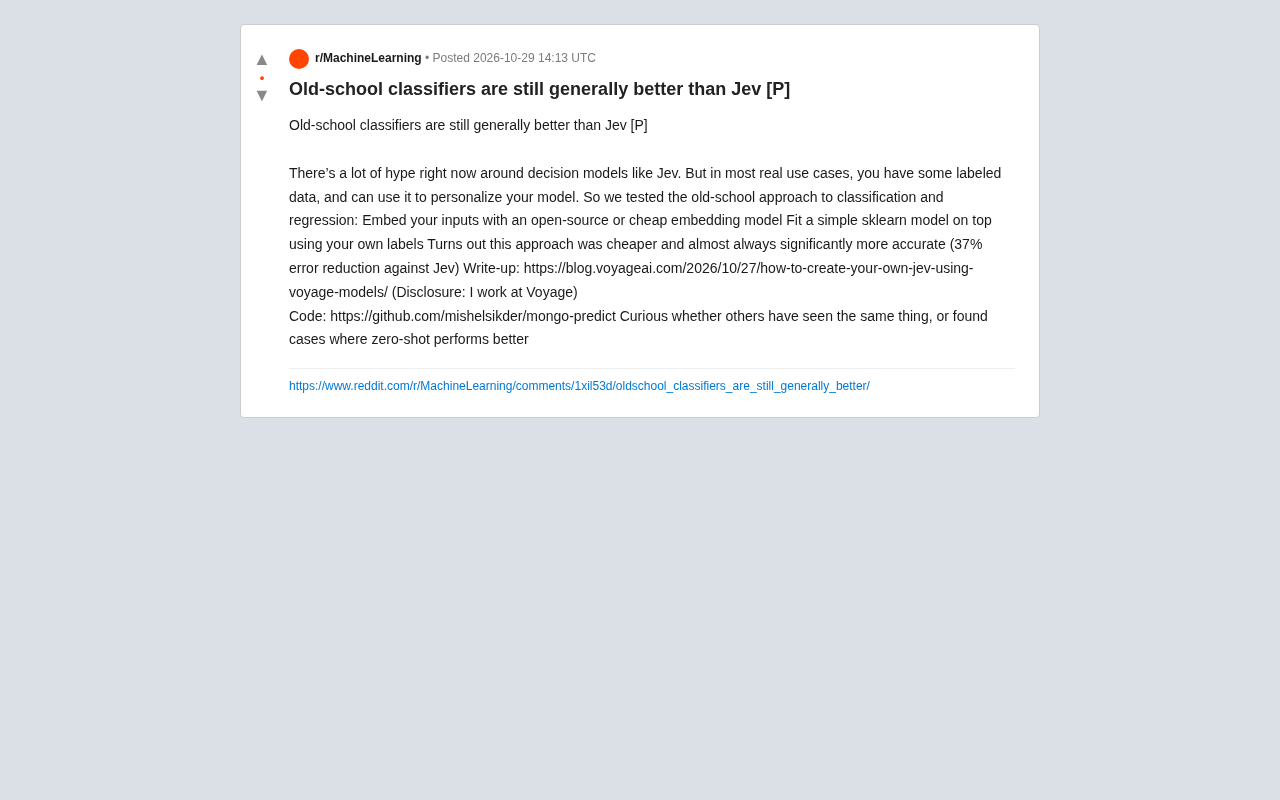
老派分类器仍胜Jev:嵌入+sklearn误差降37%
Voyage AI工程师测试发现,用开源嵌入模型加sklearn分类器的老派方案,比当红决策模型Jev更便宜且错误率降低37%。讨论有标注数据时传统方法是否被低估,以及零样本与有监督学习的适用边界。