192GB统一内存Framework台式机:本地跑超大AI模型
Framework台式机搭载AMD Gorgon Halo,192GB统一内存让单机本地运行500B级开源大模型成为现实。
搭载AMD Gorgon Halo(Ryzen AI Max+ Pro 495)的新款Framework台式机将统一内存从128GB提升至192GB,恰逢DeepSeek V4.1 Flash、MIMO V2.6 Flash等超大开源权重模型发布。192GB内存使单台机器无需集群或SSD流式加载即可运行5000亿参数级模型:DeepSeek采用Q2量化后主权重约163GB,MIMO则可保留MXFP4原生精度。性能实测中,DeepSeek提示处理约307-360 tokens/s,MIMO起始更快但随上下文增长衰减明显,生成速度均在14-18 tokens/s区间。额外内存还支持双模型同时驻留——以快速的Qwen 3.8 Flash Next作主力,通过secondopinion工具在卡壳时调用更强模型提供指导。Framework改进的PCIe插槽缺口设计进一步扩展了外接独立GPU做异构推理或加装RoCE网卡搭建集群的可能性。
当硬件遇上恰逢其时的新模型
外观看起来和过去那台Framework台式机没什么两样,但内部已经完全不同。新机搭载AMD代号Gorgon Halo的处理器,也就是Ryzen AI Max+ Pro 495版本,最关键的升级是把统一内存从128GB提升到了192GB——整整多出50%的可用内存。
这个时间点非常微妙。恰逢DeepSeek广告 V4.1 Flash、MIMO V2.6 Flash等新一代开源权重模型发布,而192GB正好是本地运行这些大模型的理想内存容量。它们在同规模模型中,是目前编程和Agent任务上最强的开源权重模型之一。
硬件参数上,Gorgon Halo保留了16个Zen 5 CPU核心和40个RDNA 3.5 GPU计算单元,GPU频率从2.9GHz小幅提升到3GHz,更快的内存把理论带宽从256GB/s拉高到约273GB/s,提升约7%。但真正改变使用体验的,还是那多出来的内存。
一台机器塞下半万亿参数模型
额外内存最直接的价值,是让单台机器就能运行更大的模型,而不必依赖SSD流式加载或搭建集群。
DeepSeek V4.1 Flash是个典型例子。它虽然拥有超过5000亿参数,却通过架构创新降低了长上下文所需的内存,并引入了一种名为SWA-bounded replay的模式。在这种模式下,长输入提示中的大多数token只需要经过模型一半的层,大幅加快了提示处理速度。这是一种用精度换速度的近似策略,但DeepSeek专门训练模型来适应它。
目前在Gorgon Halo上运行该模型的最佳方式,是使用作者的Dwarf Star实现,搭配Q2量化版本,主模型权重约占163GB。很多人对2-bit量化心存疑虑,但这类模型其实对量化相当耐受,而且量化方案会把注意力投影等最关键的部分保留在更高精度,质量损失有限。完整文件约366GB(含Ngram表),但这些表不需要全部加载进内存。
实测中,作者让模型用three.js构建一个带重力、碰撞和吸引力的浏览器3D粒子模拟器。这个任务要求模型同时理解物理、推理粒子行为、实现模拟逻辑并设计交互界面,最终结果相当惊艳。
SWA-bounded replay 是DeepSeek V4.1 Flash引入的一种近似推理策略,名称来源于滑动窗口注意力(Sliding Window Attention,SWA)。传统Transformer在处理长输入时,每个token都需要经过所有层的完整计算,内存和计算量随上下文长度线性增长。SWA-bounded replay的核心思路是:对于长提示中的大多数早期token,只让它们通过模型的浅层(约一半层数),跳过深层的精细推理,仅对最近的窗口内token执行完整的全层计算。这样做的代价是牺牲部分精度,但DeepSeek专门针对这种"有损快进"模式进行了训练,使模型能够在精度损失可控的前提下大幅压缩长提示的处理时间和峰值内存占用。对于编程、Agent等需要频繁发送长上下文的任务,这种设计带来的速度收益尤为明显。
Q2量化(2-bit量化)是将模型权重从原始的16-bit或32-bit浮点数压缩到平均每个参数只用约2个比特存储的技术,可将模型体积缩小至约1/8。由于信息损失较大,传统认知认为2-bit量化会严重损害模型质量。但现代混合量化方案(如GGUF的Q2_K_XL)会对注意力投影、输出层等对精度最敏感的权重保留更高位宽(4-bit或更高),只对专家层中的冗余参数激进压缩。MoE(混合专家)架构的模型因为每次推理只激活少量专家,对权重压缩的容错性本身也更高,这使得Q2量化在500B级MoE模型上的实际表现往往优于直觉预期。
可选模型与性能表现
除DeepSeek V4.1 Flash外,还有两个值得尝试的大模型。
GLM 5.3 Flash约3200亿参数、每token激活180亿,被不少人视为近几个月最好的开源权重模型之一。它比DeepSeek更稠密,当前速度更适合长时间运行的任务而非交互式使用。作者还专门做了一个2-bit与4-bit混合的量化版本以适配Gorgon Halo,牺牲速度换取更高精度。
MIMO V2.6 Flash由小米发布,拥有3090亿总参数、每token激活150亿。由于比DeepSeek更小,GGUF量化可以把专家层保留在原生的MXFP4 4-bit格式,不必进一步压缩,从而保持原始精度。它架构相对传统,但小米在训练数据和后训练上投入很多,这解释了它在编程和Agent基准上的出色表现。
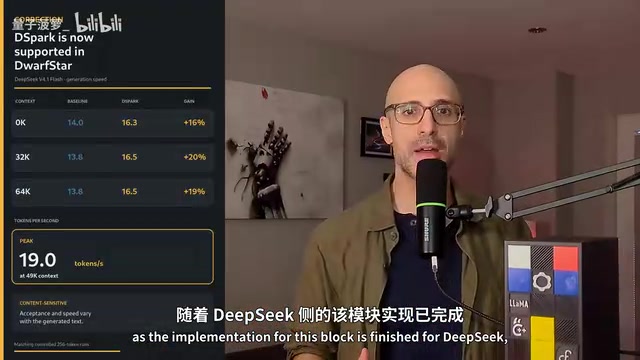
性能方面,以2000 token新提示为例:DeepSeek V4.1 Flash在Q4下提示处理起始约360 tokens/s,在32K上下文时约342,在64K时仍有约307。MIMO在MXFP4下起始更快约477,但衰减更明显,32K时降到354。token生成速度随上下文增长变化较小,DeepSeek稳定在约14 tokens/s,MIMO从18逐渐降到16。GLM 5.3 Flash整体慢得多,Q2量化生成约12 tokens/s(64K时约10)。作者指出,由于这些模型在llama.cpp中的实现仍较新,未来几周性能有望进一步提升。
让两个模型同时在线协作
额外内存的另一种玩法,是同时在内存中保留两个模型。
作者的思路是:用较快但仍有能力的Qwen 3.8 Flash Next作为主模型,同时把DeepSeek V4.1 Flash或GLM 5.3 Flash这样更强的模型常驻内存,在Qwen卡壳时随时求助。
直接在编码Agent中切换模型并不理想,因为新模型每次都要重新处理整段对话,速度很慢。更聪明的做法是给主模型一个工具,让它把特定任务委托给更慢但更强的模型。作者尝试了Adobe为pi制作的secondopinion扩展——它允许Qwen把问题描述和上下文发给评审模型,由后者分析并给出指导。Qwen既可以被明确要求使用该工具,也可以在卡住时自行决定调用。
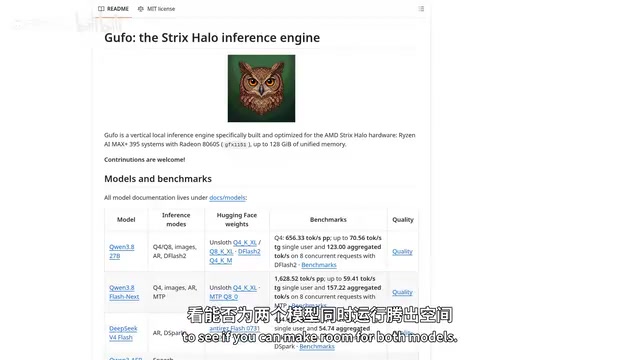
实际运行需要留意不同推理引擎(Dwarf Star、llama.cpp、Halogen等)如何分配和固定内存,才能为两个模型腾出空间。
secondopinion 是Adobe为pi(一款AI编程助手环境)开发的扩展,实现了一种轻量级的"模型路由"机制。它以工具调用(tool call)的形式暴露给主模型:主模型可以在自身推理遇到瓶颈时,将问题描述、关键上下文和具体疑问打包发送给指定的"评审模型",后者独立分析后返回建议或分步指导,主模型再据此继续生成。这种方式的优势在于评审模型不需要重新处理完整的对话历史,只接收主模型精炼后的问题描述,大幅降低了调用大模型的成本;同时主模型保留了对"何时求助"的自主判断权,避免了对每个请求都走双模型路径的低效。这与完整的多Agent框架不同——它更像是在主模型内部嵌入一个"可随时拨打的热线",适合在单机多模型共存场景中平衡速度与能力。
PCIe插槽的实用改动
Framework还对PCIe插槽做了一个受欢迎的改动。这是一个4通道的短插槽,通常末端是封闭的,显卡那种16通道的长连接器无法物理插入。Framework在插槽末端开了一个缺口,让更长的连接器可以伸出去,不需要转接卡也不必自己动手切割、冒着损坏主板的风险。
这个插槽有两种典型用途:一是加装独立GPU做异构推理,让集成显卡和独立显卡分担负载(lucebox团队正在Strix Halo上探索这一方向);二是加装网卡,比如Intel E810,它支持RoCE,可通过RDMA over Converged Ethernet让多台机器以更低延迟、更高带宽交换数据,用于搭建集群。
RoCE(RDMA over Converged Ethernet) 是一种在标准以太网上实现远程直接内存访问(RDMA)的协议。传统TCP/IP网络在节点间传输数据时,数据需要经过操作系统内核的多次拷贝和协议栈处理,延迟高且CPU占用大。RDMA允许一台机器的网卡直接读写另一台机器的内存,绕过CPU和操作系统,延迟可降至微秒级,带宽利用率接近物理上限。Intel E810支持RoCE v2,在25GbE或100GbE网络上可为多机推理集群提供接近InfiniBand的通信性能,但成本远低于专用InfiniBand方案。对于需要在多台Gorgon Halo机器间分片运行超大模型(张量并行或流水线并行)的场景,低延迟的节点间通信是决定整体吞吐量的关键瓶颈,这也是文章提到网卡用途时特别强调RoCE支持的原因。
结语
Gorgon Halo与DeepSeek V4.1 Flash、MIMO V2.6 Flash几乎同期出现,时机绝佳。额外的内存让这些大模型能在单台机器上运行而无需拆分权重,也让两个优秀模型得以同时驻留内存——快模型卡住时可以向慢模型求助。对于想在本地部署超大开源模型的开发者而言,192GB统一内存的方案提供了一条无需集群、无需SSD流式加载的新路径。
相关推荐

堕胎权为何是经济民生议题?Jessica Valenti的观点解析
作家 Jessica Valenti 在访谈中论证堕胎权为何是经济民生议题:从个人医疗债务到爱达荷州妇产科医生流失,她解释了为何这是真正的"餐桌议题"。

Sparrow Studio 入门:一站式生态数据AI分析平台解析
Sparrow Studio 是一站式生态数据AI分析平台,支持相机、无人机、传感器多源数据接入,内置53个AI模型自动完成检测与分类,并提供重标注与PDF/CSV导出功能。本文解析其核心能力与项目工作流。

AI客服有知识库还答错?RAG检索的真正难题在这里
AI客服有知识库仍会答错,根源在于RAG只做相似度检索,召回了不该用的内容。本文解析如何通过metadata标注、条件识别与冲突仲裁,让AI Agent在正确条件下只使用正确内容。