Sparrow Studio 入门:一站式生态数据AI分析平台解析

Sparrow Studio 是面向生态研究的一站式平台,集成53个AI模型,打通从多源数据上传到分析、校正、导出的全流程。
Sparrow Studio 是专为生态研究人员设计的数据处理与管理平台,核心价值在于将野外监测数据的上传、AI自动分析、人工校正和结果导出整合为一条端到端的处理链路。平台内置53个模型(22个检测器、27个分类器、2个航拍模型),支持4G相机、Sparrow Edge边缘设备、第三方无人机及GPS传感器等多源数据接入。以「项目」为基本组织单位,研究者可针对归档数据、实时数据流或边缘设备管线分别配置分析任务。AI识别结果支持手动重标注以修正误判,最终数据可导出为PDF或CSV格式,兼顾报告展示与后续科学分析的需求,使平台能无缝嵌入既有研究工作流。
什么是 Sparrow Studio?
Sparrow Studio 是一个面向生态研究人员的数据处理与管理平台,核心目标是把生态数据的上传、分析和导出整合到同一个工作流中。对于长期与海量野外监测数据打交道的研究者来说,分散在不同工具之间的处理流程往往耗时耗力,而 Sparrow Studio 试图用统一的平台降低这种复杂度。
从官方教程的介绍来看,平台支持多种数据来源:既可以上传历史归档数据,也能接入近乎实时的图像、音频和视频。这些数据可以来自 4G 联网相机、官方的 Sparrow Edge 边缘设备,或是第三方无人机。此外,平台还支持集成第三方传感器,例如 GPS 追踪标签,为动物行为与分布研究提供位置维度的信息。
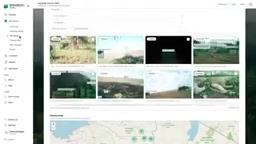
模型库:53 个预置 AI 模型
Sparrow Studio 的核心能力之一,是数据上传后由平台内置的「模型库」(Model Zoo)自动完成分析。这意味着研究者不必自行搭建或训练模型,就能直接获得结构化的识别结果。
根据教程披露的数据,平台目前提供 53 个模型,其中包括 22 个检测器(detectors)、27 个分类器(classifiers)以及 2 个航拍专用模型(aerial models)。检测器负责在图像或视频中定位目标,分类器则对目标进行物种或类别判定,而航拍模型显然是针对无人机采集的高空视角数据做了专门优化。
这种「检测 + 分类 + 航拍」的模型组合,覆盖了生态监测中最常见的几类任务。对于使用者而言,关键价值在于不需要在模型选型和部署上投入大量工程资源,而是可以把精力放回到科学问题本身。
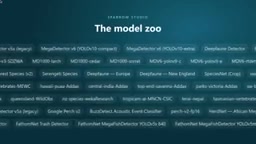
检测器与分类器的分工在计算机视觉流水线中有明确定义:检测器(通常基于 YOLO、Faster R-CNN 等目标检测架构)负责在图像中输出目标的边界框(bounding box)和置信度分数,解决「目标在哪里」的问题;分类器则在检测器圈定的区域基础上,进一步判断「目标是什么」——例如将某个动物轮廓归类到具体物种。这种两阶段设计比单阶段端到端分类在生态场景中更实用,因为野外图像往往同时包含多个个体、复杂背景和遮挡情况,先定位再识别能有效提升准确率并降低漏检率。航拍专用模型则需应对高空俯视视角带来的比例失真和目标尺寸极小等特殊挑战,通常会在训练数据和模型结构上针对性调整。
项目机制与数据处理流程
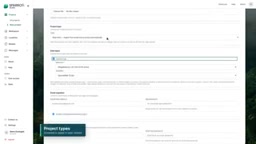
使用 Sparrow Studio 的起点是创建一个「项目」(project),然后为该项目指定一个或一组模型来分析上传的数据。平台提供了多种项目类型,教程中提到的包括:
- 归档数据处理:针对此前采集、已有积累的历史数据进行批量分析;
- 实时数据处理:对接入的近实时数据流进行即时识别;
- 数据处理管线:面向兼容设备或 Sparrow Edge 边缘设备的流水线式处理。
这种以项目为单位、按需挂载模型的设计,让不同研究场景可以采用不同的分析配置。无论是回溯多年前的监测影像,还是处理相机刚刚传回的实时画面,都能在同一平台内按统一逻辑组织。
「边缘计算」(Edge Computing)在这里指的是 Sparrow Edge 设备在数据采集端本地完成部分计算,而非将原始数据全部传输到云端再处理。对于野外监测场景,这一架构有明显优势:偏远地区的网络带宽往往有限,将初步的检测或过滤任务前置到边缘设备,可以显著减少上行数据量、降低传输成本,同时缩短从采集到获得结果的延迟。边缘侧通常运行轻量化的模型(如量化或剪枝后的版本),而更复杂的分类任务则交由云端平台完成,形成「边缘预筛 + 云端精分」的分工链路。
结果管理、重标注与数据导出
Sparrow Studio 强调的另一重点,是让 AI 模型给出的预测结果「易于管理」。AI 识别难免存在误判,平台因此提供了**重新标注(re-annotate)**功能——当某条数据被错误分类时,使用者可以手动修正,保证最终数据集的准确性。这一点对科研场景尤为重要,因为数据质量直接决定研究结论的可信度。
在数据导出方面,平台支持两种主要格式:PDF 适合生成报告与成果展示;CSV 则便于导入其他科学工具或数据处理平台做进一步分析。这种开放的导出能力,意味着 Sparrow Studio 并不打算做成封闭的数据孤岛,而是可以嵌入研究者既有的工作流中。
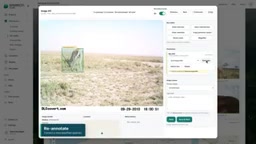
重标注(re-annotation)在生态 AI 工作流中扮演的角色,不仅是纠错,也是持续改进模型的数据来源。经过人工校正的标注数据可以反馈到模型微调(fine-tuning)流程中,使模型逐步适应特定研究地点的物种组成、光照条件和拍摄角度。这一「人在环路」(human-in-the-loop)机制在生态监测中尤为关键——不同栖息地、季节和设备型号产生的图像分布差异较大,仅依赖通用预训练模型往往会产生系统性偏差,而持续的人工校正与数据回流是缩小领域差距的主要手段。CSV 格式的导出也为将校正后的标注数据导入其他标注工具或训练框架提供了便利。
对生态研究工作流的意义
把上传、AI 自动分析、人工校正和多格式导出串联在一起,Sparrow Studio 本质上是在为生态数据提供一条端到端的处理链路。相机、边缘设备、无人机、传感器等多源输入的统一接入,加上开箱即用的模型库,降低了技术门槛;而重标注与标准化导出,则兼顾了科研对数据准确性和可复用性的要求。
作为教程系列的第一集,本视频主要是概念性的介绍。按官方说明,后续内容将进一步讲解如何创建初始项目、各类项目类型的区别,以及如何为项目分配不同的模型。对于关注野外监测与 AI 结合的研究团队,这一平台值得持续跟进其具体功能的落地效果。
相关推荐

UniEvo-VL:自蒸馏训练如何让多模态模型自我进化
UniEvo-VL 提出用自蒸馏训练实现多模态模型的自我改进。本文解读自蒸馏在视觉语言模型中的工作机制、潜力与局限,探讨这一自我进化路线能否破解图文数据标注瓶颈。

斯坦福团队软骨再生研究:能否终结关节炎?
斯坦福科学家被报道找到再生软骨、阻止关节炎的方法。本文梳理软骨再生的医学难点、常见研究思路,并对这一突破消息进行理性解读。

Penguin Mail:用 Rust 打造的开源 Linux AI 邮件客户端
Penguin Mail 是一款用 Rust 编写的开源 Linux 邮件客户端,内置 AI 能力。本文解析其技术选型、AI 功能想象空间及开源社区意义,探讨它在 Linux 桌面生态中的定位。