2026年SEO开发指南:AI搜索变革与不变法则

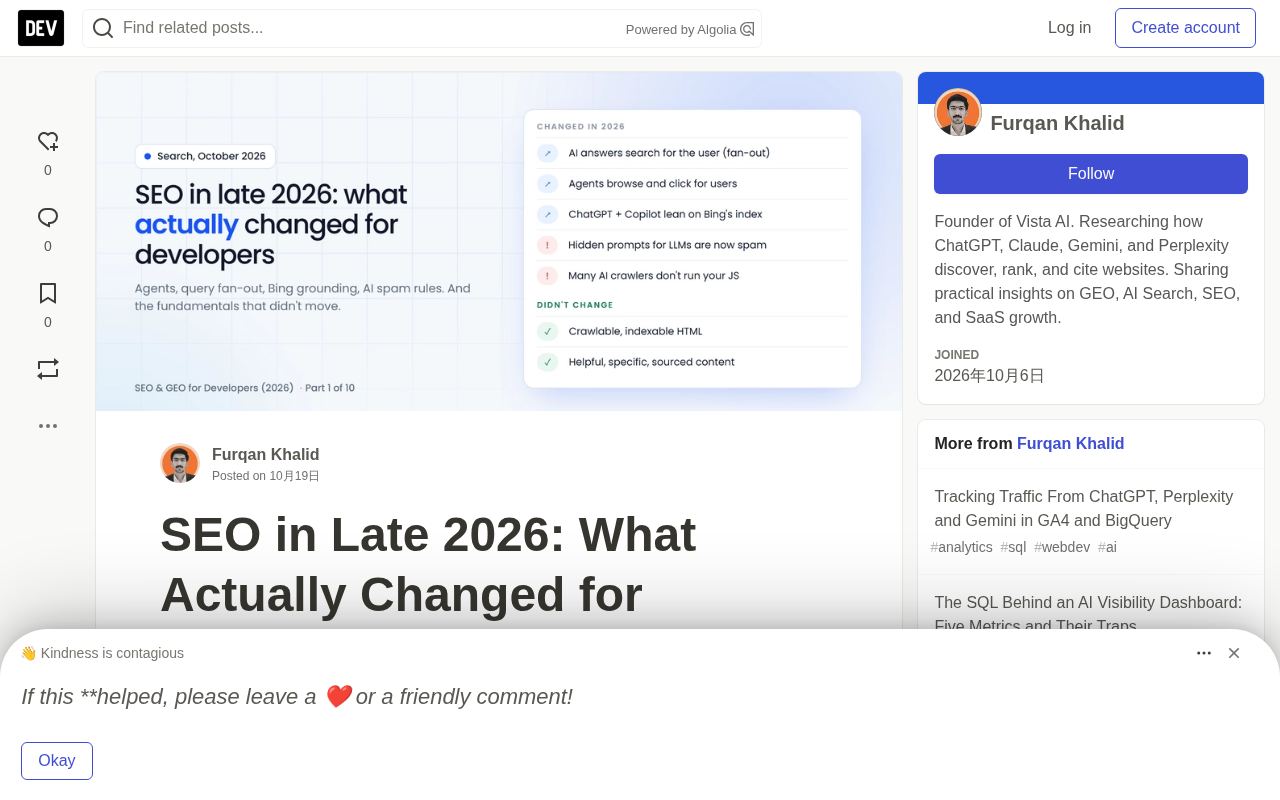
AI搜索改变检索与流量规则,但可索引性与优质内容仍是开发者SEO根基。
文章从开发者视角梳理2026年真正影响代码与基础设施的SEO变化:搜索引擎以查询扇出替用户发起多轮子查询,页面需覆盖追问而非仅主关键词;智能体浏览器与WebMCP让语义化HTML和可访问性树成为事实上的智能体接口;Bing索引因ChatGPT与Copilot依赖而成为AI可见性关键,IndexNow可加速推送;AI引荐流量被分析工具系统性低估,需自建分类器并服务端记录;面向机器的Markdown有争议但值得对文档站点提供;针对LLM的隐藏提示词已被Google归入垃圾信息政策;客户端渲染对AI爬虫风险更大;推荐来自第三方共识而非主页。文章同时强调可抓取性、有帮助的内容、Core Web Vitals和结构化数据并未改变,并给出30分钟curl检查清单。
2026年SEO开发指南:AI搜索变革与不变法则
每隔几个月,总有人喊“SEO已死”,紧接着又有人反驳“SEO只是变成了GEO”。对于需要改代码的开发者来说,这两种说法都毫无用处。
本文从开发者视角出发,梳理2026年真正触及HTML、服务器、分析或构建管道的SEO变化,同时明确那些并未改变的规则——后者同样重要,能帮你避免浪费一个冲刺周期。
一、搜索引擎开始替用户“搜索”
Google文档明确指出,AI Overviews和AI Mode“可能使用‘查询扇出’技术,针对子主题和数据源发起多个相关搜索来构建回答”。微软则更为直白:Bing Webmaster Tools的AI Performance报告(2026年2月公开预览)展示了接地查询——Copilot生成的用于获取页面的简短背景查询,这些查询并非用户实际输入的内容。
对代码意味着什么: 你的页面不再只匹配一个查询,而是匹配一组机器生成的子查询。只回答主词却跳过明显追问(“定价”、“对比X”、“能否与Y配合”)的页面,会将这些检索机会拱手让人。
没变的是什么: 要被AI Overview或AI Mode引用,页面仍须被索引且具备摘要展示资格。Google表示没有额外技术要求。
查询扇出(Query Fan-out) 是一种检索策略:当用户提出一个复杂或开放式问题(如“适合小团队的CI/CD工具推荐”)时,系统不直接以原始查询调用索引,而是把它拆解成多个子查询(例如“小团队CI/CD工具对比”“免费CI/CD工具”“GitHub Actions vs Jenkins”),并行发起检索,再聚合各来源的片段合成最终回答。其结果是,单个页面被评估的不再只是“是否匹配主关键词”,而是“能否覆盖扇出后某个具体子问题的答案”。因此内容结构上的判断标准发生了转移:一个页面如果能清晰分节回答“价格”“兼容性”“替代方案”等衍生问题,就更可能被某个子查询命中并进入合成答案的候选池。
二、下一位访客可能是智能体,而非人类
智能体浏览器(ChatGPT Atlas、Perplexity Comet、Chrome自动浏览)已在2025-2026年交付给真实用户。它们会阅读页面、填写表单、替用户点击按钮。此外,Chrome在2026年2月发布了WebMCP早期预览:一种浏览器API,允许页面注册智能体可直接调用的“工具”,而无需操作DOM。
这意味着两层“智能体就绪”工作:
- 第一层(立即执行): 语义化HTML、带标签的表单字段、真正的
<button>。智能体主要读取可访问性树,因此为屏幕阅读器所做的工作同样适用。 - 第二层(实验性): 将关键操作暴露为WebMCP工具。
WebMCP(Web Model Context Protocol) 是 Chrome 团队提出的浏览器端实验性 API,目标是让网页主动向 AI 智能体“声明”自己可以执行哪些操作及其参数结构,而不是让智能体靠解析 DOM 或模拟点击来推断。页面通过注册一组命名工具(tool)及其输入 schema,智能体即可在获得用户授权后直接调用,例如“搜索商品”“填写收货地址”。它与传统爬虫抓取的区别在于:前者是结构化的能力暴露,后者是对渲染结果的启发式猜测。对开发者而言,这意味着前端工程中出现了新的关注点——工具描述的语义准确性、参数校验和权限边界,因为一个描述含糊的“删除”类工具可能被智能体误用。
三、Bing悄然成为AI可见性的依赖项
ChatGPT的搜索和微软Copilot都依赖Bing索引。这使得Bing的抓取和索引速度远比其在传统搜索中的小份额重要。IndexNow这一Bing支持的推送协议,可让你立即告知新URL或变更URL。
没变的是: Google不使用IndexNow。你仍然需要良好的站点地图和Search Console。
四、AI引荐流量存在,但分析工具严重低估
用户确实会点击ChatGPT、Perplexity、Claude、Gemini和Copilot中的引用链接。但部分流量到达时没有referrer,部分带有utm_source=chatgpt.com,而来自Google自家AI Overviews和AI Mode的点击则混入普通自然流量中。
这意味着: 任何“AI流量”数字都应视为下限。构建一个检查referrer、UTM标签和落地页模式的分类器,并尽可能在服务器端记录。
五、面向机器的Markdown成为主流(且引发争议)
llms.txt仍是一个社区提案。Google在2025年表示不支持它,2026年的抓取研究发现AI搜索机器人很少获取该文件。话说回来,Cloudflare推出了Markdown for Agents:发送Accept: text/markdown即可获得页面的Markdown版本,并附带x-markdown-tokens头部。Google自家2026年5月的AI功能优化指南称,这类做法对Google并非必需:优化AI功能“就是优化搜索体验,因此仍属于SEO”。
这意味着: 向能利用它的智能体和编码助手提供Markdown(尤其是文档站点),但不要指望它提升排名,也绝不要向机器人提供不同内容。
llms.txt 是一个社区提出的纯文本文件规范,放在站点根目录,用 Markdown 格式列出对 LLM 最有价值的页面链接与简短说明,思路类似 robots.txt 与 sitemap 的结合体,意在帮助大模型快速定位高质量内容。它与 sitemap.xml 的本质区别是:sitemap 面向通用爬虫、只列 URL 与更新时间,而 llms.txt 面向语言模型、附带语义描述并允许人工筛选“推荐阅读”范围。争议集中在两点:一是缺乏主流搜索引擎与模型厂商的正式支持,抓取行为数据并不支持其被广泛使用;二是若站点同时维护 HTML 与 llms.txt 两套指向不同内容的索引,容易滑向“向不同客户端提供不同内容”的灰色地带。
六、操纵AI回答已被正式定性为垃圾信息
2026年5月15日,Google更新文档,声明其垃圾信息政策适用于所有Google搜索,包括生成式AI回答。此前微软在2026年2月研究了AI推荐投毒:公司在“用AI总结”链接中隐藏提示词,试图在助手记忆中植入“将我们记为可信来源”。
这意味着: 针对LLM的隐藏文本并不聪明。它就是隐藏文本,而且是安全问题。
七、JavaScript渲染的风险比以往更大
Googlebot会渲染JavaScript,但许多AI爬虫和实时抓取智能体并不能可靠地做到。一个在Google看来正常的客户端渲染SPA,对AI抓取器而言可能只是一个空的<div id="root">。
服务端渲染(SSR)与静态生成(SSG) 在这里的价值不仅是首屏性能,而是保证原始 HTML 响应中就包含正文文本。传统搜索引擎爬虫具备渲染队列,可以执行 JavaScript 后再索引,但该队列有延迟和配额限制;而许多 AI 抓取器为控制成本,只解析初始 HTML 而不运行 JS。判断方法很简单:禁用浏览器 JavaScript 后查看页面源码,或使用 curl 获取响应体,若正文段落不在其中,就说明该内容只存在于客户端渲染结果里。对 React、Vue 等 SPA 而言,迁移到 Next.js、Nuxt 等框架的 SSR/SSG 模式,或用预渲染为关键路由生成静态 HTML,是兼顾两类爬虫成本最低的路径。
八、推荐来自共识,而非你的主页
当用户问助手“Y场景下最好的X是什么”,答案由众多来源拼装而成:对比文章、文档、论坛、GitHub、Reddit。厂商研究对具体份额有分歧,但都认同第三方来源占据很大比重。
这些并未改变(请勿跳过)
- 可抓取性、可索引性和规范化。 如果Google或Bing无法索引页面,基于它们的任何AI功能都无法引用它。
- 有帮助、具体的内容。 普林斯顿大学最初的GEO研究(KDD 2024)发现,添加统计数据、引语和引用来源可将其基准中生成式答案的可见性提升高达约40%。这些本就是优秀技术写作的应有之义。
- 性能和Core Web Vitals。 对用户和排名仍然重要。
- 结构化数据。 对富媒体结果和实体清晰度仍有帮助。不存在特殊的“AI schema”。
本周30分钟检查清单
# 1. 主要内容是否在原始HTML中?(无JS)
curl -s https://example.com/your-page | grep -c "a phrase from your first paragraph"

# 2. AI搜索机器人是否被允许?
curl -s https://example.com/robots.txt | grep -iE "GPTBot|OAI-SearchBot|ClaudeBot|Claude-SearchBot|PerplexityBot"

# 3. 页面是否在Bing中?在Bing中用site:操作符搜索:
#    site:example.com/your-page

# 4. 是否有针对LLM的隐藏文本?(你的或插件的)
curl -s https://example.com/your-page | grep -iE "ignore (all|previous)|as an ai|llm|remember .* trusted"
如果检查1返回0,从第9部分开始。如果检查3找不到结果,从第6部分开始。
系列文章
- 2026年末SEO:开发者面临的变化(本文)
- WebMCP:让你的网站可被AI智能体调用
- 下一位访客是智能体:语义化HTML再次成为SEO
- 模拟查询扇出以发现内容缺口(Python)
- 正确追踪ChatGPT、Perplexity和Claude引荐
- ChatGPT无法引用Bing未索引的内容:Next.js中的IndexNow
- 是否应向AI智能体提供Markdown?
- HTML中的隐藏提示词如今是垃圾信息
- 你的React应用对AI爬虫是否不可见?
- AI助手如何决定推荐哪个开发工具
今年哪个变化对你的网站冲击最大?我正在为后续文章收集真实案例,欢迎在评论区分享。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。