24GB MacBook Air 跑本地 AI:为什么我选 Qwen 9B?
24GB MacBook Air 本地大模型实测:千问3.5 9B以5GB内存占用兼顾翻译与看图,是常驻后台的务实之选
这篇文章记录了一位B站UP主在24GB内存的M5 MacBook Air上选择本地常驻大模型的测试过程。核心结论是:千问3.5(Qwen)9B版本在能力与内存占用之间取得最佳平衡——MLX峰值约5.1GB,远低于27B或35B模型的约14GB,为日常任务留足内存空间。在翻译能力上,16段专业测试显示术语表带来的提升(43→47分)比追加前文更显著,建议同领域用户优先维护术语表而非追求更大模型。9B本身支持视觉能力,9张图片测试对了8张,但视觉模块运行时内存峰值可达10.8GB。工作流层面,UP主以OLLAMA管理模型、复用Codex作为Agent入口,完整流程仍在验收中。
在 24GB 内存的 M5 MacBook Air 上跑本地大模型,选哪个才能兼顾能力和内存余量?这位 B 站 UP 主经过实测,最终把常驻后台的小模型锁定在千问(Qwen)3.5 的 9B 版本。它既能做思维量化翻译,又能看图,还能给内存留出足够空间让电脑干别的活。这篇文章把 UP 主的测试逻辑梳理清楚:先看能力,再看内存,最后看怎么用好。
为什么是 9B,而不是更大的模型
选模型的核心矛盾在于:MacBook Air 不是专门的推理服务器,后台跑模型的同时,电脑还得干别的正事。24GB 内存看似宽裕,但一旦模型吃满,系统体验就会明显下降。
UP 主对几个候选模型做了短文本测试,从内存峰值角度做了横向对比:
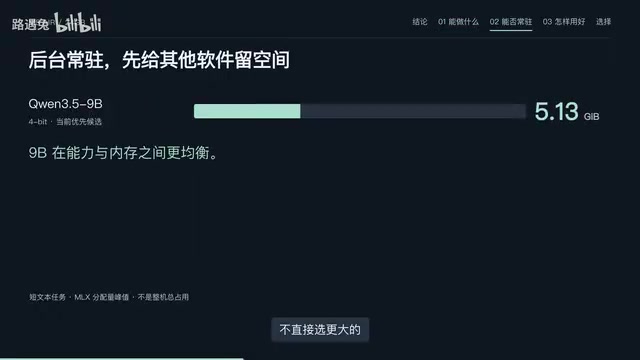
- 9B 的 MLX 峰值约 5.1GB
- 27B 的一些句子翻译更精确,但需要约 14.6GB
- 35B 的 A3B 三位量化也要约 14.4GB
这里有个容易被误解的点:A3B 的"激活 3B"并不代表内存只装 3B 的权重。激活参数少不等于占用内存少,权重整体仍需加载。所以别被"3B 激活"迷惑,实际内存开销依然接近 14GB 级别。
对于一台还要开浏览器、写代码、处理日常任务的笔记本来说,5GB 出头的占用和 14GB 的占用是完全不同的体验。9B 的性价比就体现在这里——能力够用,内存克制。
MLX 是苹果专门为 Apple Silicon(M 系列芯片)开发的机器学习框架,能够利用统一内存架构(Unified Memory)让 CPU 和 GPU 共享同一块物理内存,避免传统 PC 上 CPU 内存与显存之间的数据搬运开销。这使得 M 系列 Mac 在跑本地大模型时有独特优势:标注为"MLX"的量化模型包专门针对这一架构优化,相比通用的 llama.cpp 格式通常有更好的推理速度和内存利用率。文中提到的"5.1GB MLX 峰值",指的就是用 MLX 格式加载 9B 模型时框架侧分配的显存/内存量,这个数字比模型文件本身的磁盘大小更能反映实际运行时的内存压力。
翻译能力:自然度和精确度的取舍
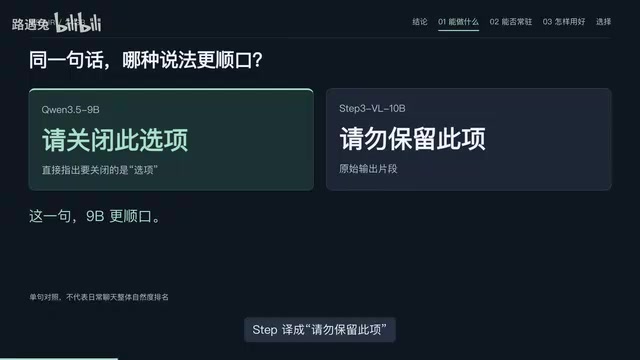
翻译好不好,不能只看单句。UP 主用具体案例做了对比:同一句涉及设置项的文本,9B 翻出的"请关闭此选项"比另一种"请勿保留此项"更顺口、更符合中文表达习惯。
不过 UP 主也坦承,单个案例代表不了日常聊天的整体自然程度。更系统的评估来自 16 段专业翻译测试(满分 48):
- 9B 直接翻译:43 分
- 加前文上下文:45 分
- 加术语表:47 分
- 前文 + 术语表都加:47 分
这组数据揭示了一个实用结论:术语表带来的提升比追加前文更明显。对于同一领域反复翻译的场景,与其每次喂大段上下文,不如先让大模型整理好专业名词、核对译法、存到本地反复复用。
如果需求仅限于纯翻译,UP 主提到混元 MT2 的 7B 版本也是不错的选择,只是这次没有参加本机横向对比。
文中提到的"思维量化翻译"对应的是带有 Thinking 模式的模型推理方式——模型在给出最终答案前,会先在内部生成一段推理过程(chain-of-thought),再输出结果。千问 3 系列的部分版本支持在推理时动态控制思考深度,可以在速度和质量之间做出调节。对于翻译这类需要理解语境、处理歧义的任务,开启思维模式通常能显著提升输出质量,但也会带来更长的等待时间和更高的 token 消耗。术语表(glossary)作为系统提示的一部分注入上下文,能让模型在"思考"阶段就锁定关键词译法,这解释了为何术语表对得分的拉升效果优于单纯追加前文——前文增加的是语境信息,而术语表直接约束了翻译决策中最容易出错的节点。
看图能力与视觉模块的内存代价
9B 本身就具备看图能力,这是它相比纯文本小模型的一大优势。UP 主用 9 个图片案例测试"给出保存/删除建议"的场景,结果 9 个里对了 8 个,基本符合预期。
一个典型例子:一张退款纠纷的收据,模型正确判断出"这是唯一凭证,应该保留"。这类判断在实际使用中很有价值——但 UP 主特别提醒,实际用时应该先让模型给建议,不要让它自动删除照片,毕竟是小样本,还不能完全托付。
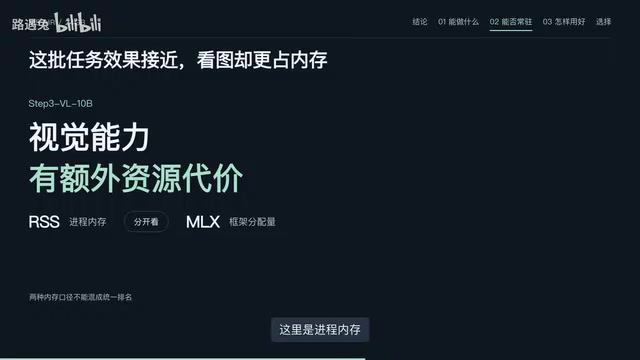
视觉能力也有代价。文本测试进程内存峰值约 6.5GB,而视觉模块跑图片测试时飙到了 10.8GB。作为对比,另一个模型(STEP)任务效果和千问接近,却要为看图付出更多内存。
这里要注意口径问题:进程内存峰值(6.5GB / 10.8GB)和前面提到的 MLX 分配量(5.1GB)测量口径不同,不能直接混在一起排名比较。
怎么用好:本地工作流的搭建思路
选好模型只是第一步,怎么把它嵌进日常工作流才是关键。UP 主给出的工具配置思路是:
- OLLAMA 负责模型的加载、卸载和提供本地接口
- Agent 入口优先复用本机的 Codex,需要搜索时再接现有的云端工具
目前搜索单项已经跑通,但由千问驱动整条流程还没有完全验收,需要 Python 工作流才能进一步串联。至于让千问 Agent 长时间后台运行的稳定性,还需要单独测试。
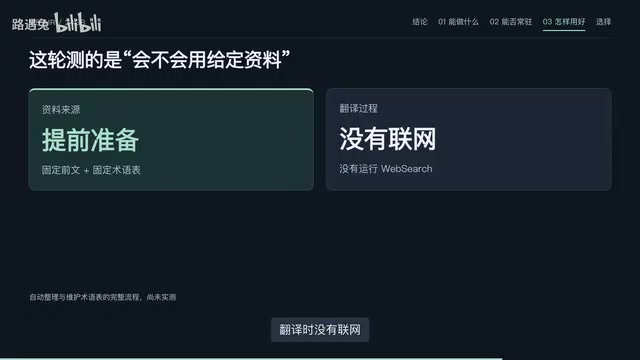
另外,翻译时全程没有联网,资料都是提前准备好的。所谓"术语表自动维护流程"目前也还没实测,属于规划中的能力。
OLLAMA 是目前最主流的本地大模型管理工具之一,核心功能是将不同格式的模型统一封装,并在本地提供兼容 OpenAI API 格式的 HTTP 接口(默认端口 11434)。这意味着任何支持自定义 API endpoint 的客户端或脚本,都可以无缝切换到本地模型,无需改动调用逻辑。OLLAMA 还负责模型的按需加载与超时卸载——当一段时间没有请求时,它会自动将模型从内存中移除,把资源还给系统,这对"后台常驻但不持续占用内存"的使用场景尤为关键。文中提到的 Codex 指的是苹果平台上的本地 Agent 入口工具,通过将其与 OLLAMA 提供的本地接口对接,可以在不依赖云端 API 的情况下驱动 Agent 完成工具调用和多步骤任务。
结论:给同类用户的实用建议
对于 24GB 的 MacBook Air 这类既要跑本地 AI、又要兼顾日常使用的机器,UP 主的选择清晰明了:常驻后台用 9B。它在翻译自然度、看图能力和内存占用之间找到了平衡点。
如果你的使用场景是在同一领域反复翻译,最值得投入的不是换更大的模型,而是把术语表维护好——数据显示这带来的收益比追加上下文更实在。而更大的 27B、35B 模型虽然精度更高,但对这类笔记本来说内存代价过高,不适合长期常驻。
本地 AI 的本质是在有限硬件下做权衡,9B 在这台机器上给出的,是一个务实且可持续的答案。
相关推荐
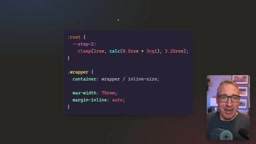
修复流式排版难题:容器查询与@property的组合技
流式排版在容器达到最大宽度后字号仍持续增长、多容器下字号不一致,是 CSS Fluid Typography 的常见痛点。本文讲解如何用容器查询单位配合 @property 注册自定义属性,锁定统一字号,兼顾响应式布局与设计一致性。
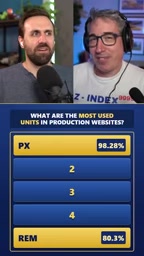
生产环境网站最常用的CSS单位排名揭晓
生产环境网站最常用的CSS单位排名出炉:px居首,em以91.3%覆盖率超越rem,而degrees和seconds竟排进前四。本文解析这份榜单背后的前端现实。
在对象存储上运行Git:重构Packfile的技术思路
探讨如何通过重新生成Packfile让Git运行在S3等对象存储之上。分析Git存储模型与对象存储的兼容难点、打包策略的优势,以及一致性与写放大等现实权衡。