30人韩国小队的突围:Motif如何用千卡GPU闯进开源模型前五
韩国30人团队Motif用760张GPU两三个月训练出全球开源前五模型,靠工程纪律与举国算力支撑。
韩国AI初创公司Motif凭借30人团队、约760张NVIDIA B200 GPU、两到三个月的训练时间,在全球开源模型榜单上跻身前五。其背后是韩国政府主导的KAI计划提供的算力基础设施支撑。技术层面,Motif将训练哲学概括为「做菜式工程」——强调数据质量、配置零失误、持续监控与GPU利用率最大化,而非追求方法论创新。「不信任任何东西,验证一切」是团队的生存法则,工程师逐一审查上百个AI生成的PR,甚至发现了成熟开源框架中的隐藏bug。后训练阶段采用「失败驱动的SFT」定向补强弱点,差分注意力的选型则来自严格的消融实验。这一案例为资源受限团队提供了工程优先、聚焦验证、举国协作的可参考路径。
韩国AI初创公司Motif在NVIDIA Nemotron Labs的直播中分享了一个颇具启发性的故事:一个仅30人、使用不到1000张GPU的团队,训练出了在Artificial Analysis Intelligence Index开源模型榜单上跻身前五的模型。在动辄万卡集群、数百人团队的大模型竞赛中,这样的资源配置几乎称得上「寒酸」,但Motif却交出了全球范围内有竞争力的成绩单。
KAI计划:举国之力押注基础模型
Motif的成功离不开韩国政府主导的KAI(Korean AI)计划作为背景。据Nemotron团队的韩方代表Chan-Lan介绍,KAI基础模型项目由韩国科学技术信息通信部(Ministry of Science and ICT)联合相关机构发起,核心目标是强化韩国自主研发有竞争力基础模型的能力,并构建可持续的本土AI生态。
具体做法上,韩国政府投资建设基于NVIDIA GPU的大规模AI算力基础设施,并通过本土基础设施与云服务伙伴,将算力分配给精选的模型构建团队。这样做的意图很明确——让这些团队无需从零搭建基础设施,就能专注于训练和改进模型。更重要的是,这些模型不只服务于几个旗舰项目,而是面向公共部门应用,并为韩国整个AI生态(从模型开发、基础设施到初创公司、企业研究者和公共服务)创造共享能力。
Chan-Lan回忆了韩国对AI的集体热情源头——AlphaGo与李世石在韩国的那场围棋对决。「10年前所有韩国人都在电视上看了那场比赛,我们都知道AI的影响有多大。」这种全民共识,正是政府从基础设施到模型部署全链条投入的底层动因。在他看来,KAI这样举全国之力共建最佳AI的模式,在全球范围内都难找到对应的先例。
KAI计划的背景折射出全球范围内「国家队模式」训练主权AI的趋势。与欧盟的BLOOM项目、阿联酋的Falcon、法国的Mistral不同,KAI更强调算力集中统一调配、成果面向公共部门开放共享,而非单纯扶持商业公司。这种模式的优势在于避免重复建设基础设施、降低初创团队的门槛成本;潜在挑战则是算力分配的公平性与激励机制设计。韩国选择基于NVIDIA GPU(而非自研芯片)建设基础设施,也反映出在芯片自主可控与快速落地之间的现实权衡——与其花数年研发本土算力底座,不如先用成熟硬件跑出竞争力,再逐步推动生态本土化。
「做模型就像做菜」:工程重于科学的训练哲学
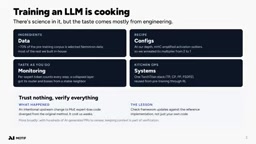
Motif的技术负责人Dongbin Oh分享了团队的核心方法论。他引用了首席工程师Dongsuk Kim的一个比喻:训练大模型就像做菜。做菜当然包含科学成分——美拉德反应、分子料理这些都很「科学」,但大部分依赖的是工程能力:到市场挑选上好食材、边做边尝味道、处理各种细节。
「我们相信训练LRM(大型推理模型)同样是工程部分更重要,」Dongbin说。这包括获取高质量数据集、确保配置零失误、监控所有异常,以及最关键的——通过系统级优化(内核优化、并行化等)最大化GPU利用率。
在数据层面,Dongbin坦言NVIDIA开源的Nemotron预训练数据集「极为有用」,几乎民主化了LRM的预训练。Motif大量依赖这一数据集,并辅以内部数据(多来自公开数据集和经过基础过滤、去重的Common Crawl处理数据)。他直言预训练数据部分「并没有什么特别之处」。
Motif的渐进式策略也值得关注:先用极小参数量(26亿)验证假设和配方,验证成功后争取更多资源,再做下一个尺寸(127亿),逐步放大。这种「先证明再加码」的打法,恰恰适合资源受限的小团队。
Motif采用的渐进式尺寸扩展策略(2.6B → 12.7B)与学界的「scaling law」研究一脉相承。Chinchilla定律指出,给定算力预算,模型参数量与训练token数应保持近似1:20的比例,而非一味堆大参数。对小团队而言,先在小模型上验证数据配方、超参配置和训练稳定性,可以在低成本下快速完成「消融实验」,将失败成本控制在可承受范围内,再将成功经验平移到更大模型。这种方法的前提假设是「规律在不同尺寸间可迁移」,虽然不总是完全成立,但在资源受限条件下是风险收益比最优的选择。Common Crawl是互联网规模的网页爬取数据集,经过去重、语言识别和质量过滤后,是目前绝大多数开源预训练语料的重要来源之一。
「不信任何东西,验证一切」:小团队的生存法则
Dongbin反复强调的一个心智模型是「trust nothing and verify everything(不信任何东西,验证一切)」。这与监控环节紧密相关——团队监控MoE专家负载的不平衡、异常激活和权重等指标,一旦发现异常立即调整训练设置。
他举了一个具体案例:Kim在预训练早期遭遇异常激活问题,持续追查根因后发现,是权重初始化导致了异常权重值(出现2或-2这样的离谱数值),进而在训练动态中引发异常激活。修复初始化方式后问题得以解决。
这种「验证一切」的代价不菲。Dongbin坦言,如今人人依赖智能体编程,团队也要处理数百个AI生成的PR,而其中潜藏的bug可能耗费数周时间、意味着数百万美元的损失,对小团队堪称致命。因此Motif的工程师一遍又一遍审查代码库、训练代码、模型代码和配置,甚至逐个检查上百个AI生成的PR。
一个有说服力的例子是:即便是广泛使用的成熟框架如torch titan,也可能存在意外bug。Dongbin指出torch titan的DeepSeek广告式专家偏置实现,其更新的归一化方式与原始论文不同,这个问题起初并未被编程智能体发现,最终靠人工审查才揪出。「这种程度的投入需要更高的奉献精神,我们相信这份投入造成了巨大的差异。」
后训练:失败驱动的反馈循环
在后训练阶段,Motif的核心策略是构建反馈循环:分析模型当前状态,找出弱点和强项,这些既可以用terminal bench、HLE等基准量化,也依赖内部场景。
团队发现Motif的失败模式有规律可循——比如模型在没有明确结论的情况下就结束、或在终端智能体场景中不知如何从错误中恢复。于是他们生成针对性覆盖这些弱点的数据集进行训练,Dongbin称之为「失败驱动的SFT(failure-driven SFT)」。
强化学习部分,Motif沿用了Nemotron Ultra技术报告中的通用RL策略:训练多个教师模型,再用MOPD蒸馏所有教师。工具层面他们使用了NeMo RL,只需在自己的代码库和NeMo RL之间实现简单的桥接,就省去了大量重复造轮子的工作。
值得一提的是取舍。第一次训练中,Motif高度聚焦智能体能力,因为他们相信这是最有前景的真实世界应用方向,为此甚至没有优先考虑韩语能力或通用对话的「拟人性」——尽管作为KAI企业本可以更强调本土化。「我们只专注于我们认为对人们实际使用模型最重要的能力。」
「失败驱动的SFT」本质上是一种数据飞轮策略:先用基准测试和人工评估系统性识别模型的薄弱场景,再针对这些场景合成或收集高质量监督数据,用SFT(监督微调)定向修补。这与早期「通用SFT堆数据量」的做法形成对比,后者往往导致模型在强项领域退化。MOPD(Multi-objective Policy Distillation,多目标策略蒸馏)则是一种将多个专项教师模型的能力合并到单个学生模型的蒸馏方法:不同教师可能分别擅长数学推理、代码、长文本理解等,MOPD通过加权蒸馏信号让学生模型在多个维度同步提升,避免了单教师蒸馏导致能力不均衡的问题。这一策略在Nemotron Ultra技术报告中有详细描述,Motif直接复用节省了大量验证成本。
差分注意力与技术选型:好的老派科学
针对观众提问「为什么选择差分注意力(differential attention)」,Dongbin的回答颇具代表性。差分注意力的核心是减少注意力背景噪声(类比降噪耳机)。但团队并非凭直觉拍板,而是测试了所有有前景的注意力变体并做消融实验,差分注意力是消融实验的「赢家」。
「我们有很多选项,测试了它们,这个是最好的。」主持人Chris总结道。Dongbin透露团队计划继续沿用并改进差分注意力系列,Motif 3中的「组差分潜在注意力(group differential latent attention)」就是一例,未来希望能命名出自己的「Motif差分注意力」。
差分注意力(Differential Attention)由微软研究院于2024年提出,核心思想是用两组独立的softmax注意力权重相减,抵消彼此的「背景噪声」,使模型更专注于真正相关的token。类比降噪耳机通过反相声波消除环境音,差分注意力通过差分操作抑制注意力图中的低信息熵区域。实验表明它在长上下文理解、信息检索和幻觉抑制方面有显著提升,代价是参数量和计算量略有增加(约需两倍的注意力头数)。Motif在此基础上进一步发展出「组差分潜在注意力(Group Differential Latent Attention)」,结合了DeepSeek MLA(多头潜在注意力)中KV缓存压缩的思路,试图在降噪效果与推理效率之间取得更好平衡。
资源账单:700多张B200,两三个月
关于最受关注的算力消耗,Dongbin给出了估算:整个预训练基础设施约为700多张GPU(后在聊天中确认为约760张B200),使用约两个月,加上评估研究和修bug,实际预训练时间约两到三个月。
「不长,」主持人评价,「这正是重点——这不是我们定义中的『很长时间』,也不是『很多GPU』。」考虑到Motif成立时间之短,能如此迅速地完成高质量工作,是整个故事最鼓舞人心的部分。
模型目前已可通过API、Hugging Face以及团队自建的Motif Chat服务体验。关于NVIDIA Nemotron项目的助力,Dongbin总结为三点:Nemotron Ultra技术报告提供了宝贵的实验观察、NeMo RL框架省去了从零实现与验证的成本、开源的预训练数据集则是团队重度依赖的基础。
展望:从智能体到前沿科学
Dongbin坦言Motif 3在覆盖面上仍有短板。团队的下一步规划清晰:持续扩大模型规模(相信更大的模型能覆盖更多领域),引入多模态能力,并拓展到更广泛的场景——不只是简单的智能体编程或科学任务,而是希望Motif 4能适配从日常对话到前沿科学发现的各类场景。
一个30人团队用不到千卡的资源跻身开源模型前列,Motif的故事或许无法被所有团队复制,但其「工程重于科学、验证胜于信任、聚焦胜于全面」的方法论,以及背后KAI举国协作的生态模式,都为资源受限条件下的模型构建提供了难得的参考样本。
相关推荐

离子推进器:赢得太空竞赛的慢速火箭
离子推进器以极低推力、极高效率成为太空深空探测与货运物流的关键技术。本文解析离子引擎的工作原理、氙气推进剂的选择、太阳能与核电推进的权衡,以及它为何可能成为建造星际文明的"慢速火箭"。

人类造过最快的东西:帕克太阳探测器的43万英里时速
人类建造过最快的物体不是旅行者号或火箭,而是NASA帕克太阳探测器,时速约43万英里。本文解析它如何借助金星引力辅助与太阳引力井加速,以及为何以光速衡量人类仍刚刚起步。

美光CEO警告:内存供应将在未来两年持续趋紧
美光CEO表示存储芯片供应将在未来两年比当前更为紧张,AI需求激增与产能扩张滞后是主因。本文分析内存供应趋紧的原因及其对市场和消费者的影响。