3DCodeEdit基准:指令驱动3D程序编辑,最强模型成功率不足60%

3DCodeEdit基准揭示模型编辑3D代码时几何预见不足,独立审查反馈可显著提升成功率。
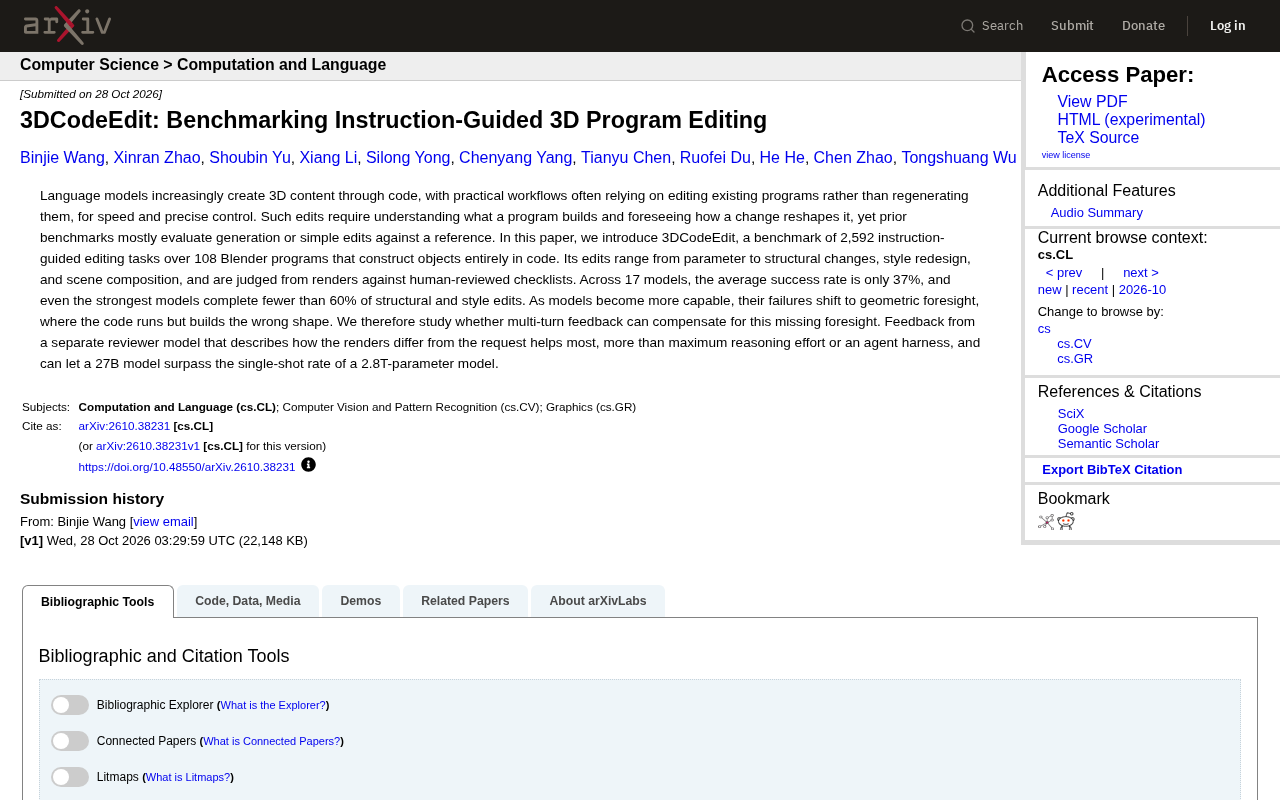
研究者推出3DCodeEdit基准,包含2,592个指令引导的编辑任务,覆盖108个完全用代码构建对象的Blender程序,任务从参数调整延伸到结构变更、风格重设计和场景组合。对17个模型的测试显示平均成功率仅37%,最强模型在结构和风格编辑上也不足60%。随着模型能力提升,失败模式从无法生成可运行代码转向几何预见不足——代码能跑但形状错误。研究进一步发现,由独立审查模型提供渲染差异反馈效果最佳,可使27B模型单次成功率超过2.8T参数模型,优于最大化推理努力和智能体框架。
语言模型正越来越多地通过代码生成3D内容,但在实际工作流中,编辑现有程序往往比从头重新生成更常见——前者速度更快、控制更精确。然而,这种编辑要求模型不仅理解程序构建了什么,还要预见一处改动会如何重塑最终结果。现有基准大多只评估生成能力或针对参考结果的简单编辑,缺乏对复杂编辑任务的系统衡量。为此,研究者推出了 3DCodeEdit,一个包含2,592个指令引导编辑任务的基准,覆盖108个完全用代码构建对象的Blender程序。
任务设计:从参数调整到场景重构
3DCodeEdit的任务跨度很广,包括参数修改、结构变更、风格重设计以及场景组合。每个任务都要求模型根据自然语言指令修改现有代码,最终从渲染结果出发,对照经过人工审核的检查清单进行评判。这种评判方式更贴近真实创作场景:用户关心的不是代码本身,而是渲染出来的三维对象是否符合预期。
与以往基准相比,3DCodeEdit强调编辑而非生成,并且编辑的复杂程度更高,不是简单替换某个数值就能完成。
Blender 程序化建模指的是使用 Blender 内置的 Python API(bpy)通过脚本创建和操作三维对象,而非依赖手工建模。脚本可以参数化地定义几何体、材质、灯光和相机,因此同一段代码改变数值就能生成不同变体。这种方式的优势在于可复现、可批量生成,并且天然适合作为语言模型的输出目标——模型生成的是可执行代码,渲染器负责将其转化为图像。3DCodeEdit 中的 108 个程序正是这类完全由代码构建对象的 Blender 脚本,编辑任务因此转化为对 Python 代码的修改,而非对网格顶点的直接操作。
17个模型平均成功率仅37%
研究者测试了17个模型,平均成功率只有37%。即便是表现最好的模型,在结构编辑和风格编辑上的完成率也不到60%。这说明当前模型在理解代码构建的几何结构、并预测修改后果方面仍有明显短板。
有趣的是,随着模型能力提升,失败模式也在转移。早期模型往往无法生成可运行的代码,而更强模型的失败更多集中在“几何预见”上:代码能跑通,但构建出的形状不对。换言之,模型学会了写语法正确的代码,却还没学会在脑海中模拟几何变换的结果。
**几何预见(geometric foresight)**是指模型在真正执行代码或渲染之前,在内部推演一段代码修改会如何改变三维形状、空间布局和视觉结果的能力。它与代码语法正确性不同:一段代码可以毫无错误地运行,却生成比例失调、部件错位或风格不符的模型。对语言模型而言,这要求它将符号化的代码映射到连续的三维几何变换上,而训练数据中这种映射信号相对稀疏。因此,能力更强的模型虽然很少再写出崩溃的代码,却更常出现“能跑但形状不对”的失败,这正是几何预见短板的体现。
多轮反馈:弥补几何预见短板
既然单次生成难以保证几何正确,研究者探索了多轮反馈能否弥补这一缺陷。他们比较了多种反馈策略,包括提高推理强度、使用智能体框架,以及引入独立的审查模型。结果显示,来自独立审查模型的反馈——描述渲染结果与请求之间的差异——效果最好。
这种反馈不仅优于最大化推理努力,也优于智能体框架。更引人注目的是,一个27B参数的模型在获得这种反馈后,其单次成功率可以超过一个2.8T参数模型的单次表现。这意味着,通过合理的外部反馈机制,较小模型也能在复杂编辑任务上达到甚至超越巨型模型的一次性输出水平。
独立审查模型反馈是指用一个与生成模型分离的模型来检查渲染结果,并以自然语言描述渲染图与用户请求之间的差异,再将这些差异反馈给生成模型进行修正。与让同一个模型延长推理链或自我反思相比,独立审查模型能获得生成模型看不到的渲染图像信息,从而提供更客观、更具针对性的信号。实验中这种反馈优于提高推理强度和智能体框架,说明外部、基于渲染结果的评判比单纯增加计算量更能弥补几何预见缺陷。
对3D创作工作流的启示
3DCodeEdit的推出为3D程序编辑提供了一个更贴近实际的评估标准。对于依赖代码生成3D内容的开发者而言,这项研究提示我们:单纯追求更大的模型或更长的推理时间,未必能解决几何预见问题;引入针对渲染结果的迭代反馈,可能是更有效的路径。
同时,基准本身也暴露了当前模型的普遍不足——结构编辑和风格编辑仍是难点。未来,如何让模型在代码执行前“看到”几何结果,或是设计更高效的反馈循环,将是提升3D程序编辑能力的关键方向。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。