#基准测试
共 102 篇相关文章
DaisyRose-27B:1,200任务RL将Qwen3.8在Terminal-Bench 4.1上的得分从5.6%提升至12%
DaisyRose-27B项目通过1,200个任务的强化学习训练,将Qwen3.8在Terminal-Bench 4.1基准上的得分从5.6%提升至12%,翻倍以上的相对提升展示了轻量RL在终端任务上的有效性,为中小团队提供了可复现的模型调优思路。

Qwen 4 Max预览版发布:实测数据矛盾,官方基准缺失
Qwen 4 Max Preview于11月11日发布,官方未公布基准分数。ModelDial独立测试得分78.8排名第14,GameFeel维护者称其表现不如老款Qwen。本文分析测试矛盾、CoDuck插曲、技术线索与开源权重缺席问题。

Qwen 4 Max预览版实测:百万上下文与基准争议
Qwen 4 Max Preview 实测汇总:百万上下文、39.3万输出token与80%折扣下的成本优势,对比GameFeel RE基准低分、外部框架兼容性和3D导航短板。

高分代码模型并未提升实际产出:一项自然实验的启示
一项自然实验追踪297名开发者发现,SWE-Bench Pro得分高11分的Claude Fable 5并未显著提升PR合并率,基准分数与真实生产力脱节。研究覆盖1900余名开发者,为AI编程工具评估提供新视角。

LLM交易代理的真相:财报与坏消息后的Alpha来自记忆而非推理
新研究构建无前视基准测试LLM交易代理在财报公告前和坏消息暴跌后的表现,发现没有代理能战胜简单策略,唯一优势来自训练数据记忆,GPT模型在训练截止前方向判断准确率59.2%,截止后降至53.3%。
Genie基准测试:企业数据任务通过率91%背后的业务上下文之争
Genie与两个前沿智能体在企业数据任务基准中对比:Genie通过率91%,对手为45%和58%,且token用量不到一半、速度快3–4倍。核心差异在于业务上下文检索,而非SQL语法。

GPT-6.2 Astra 在 ARC-AGI-3 上拿下 100% 满分
GPT-6.2 Astra 在 ARC-AGI-3 基准上取得 100% 满分,引发对 AI 抽象推理能力的关注。本文分析该成绩的含金量、版本命名信号,以及评测信息缺失与社区反应偏冷带来的不确定性。
dhAIBench:用293次实验重新定义大模型语言标注评测
查尔斯大学团队推出dhAIBench,一个记录提示词、配置与预测的Python语言标注评测框架。通过48个模型、九个任务、293次实验证明:大模型评测应针对具体语言任务,而非依赖通用排名。
LoCoMo分数波动揭秘:记忆上下文、回答提示与评判者的影响
研究揭示LoCoMo基准分数受评判者和回答提示影响显著,仅更换评判者波动7.2分,提示词差异达9.3分。Becos记忆系统在弱模型上表现优异,但在强模型上优势消失,呼吁评估透明化。

能量模型CRAM:推理速度超循环模型千倍
新研究提出CRAM能量模型,在数独和迷宫任务上训练速度比循环模型快至少1000倍,推理FLOPs减少282倍,并警示简单基准的局限性。
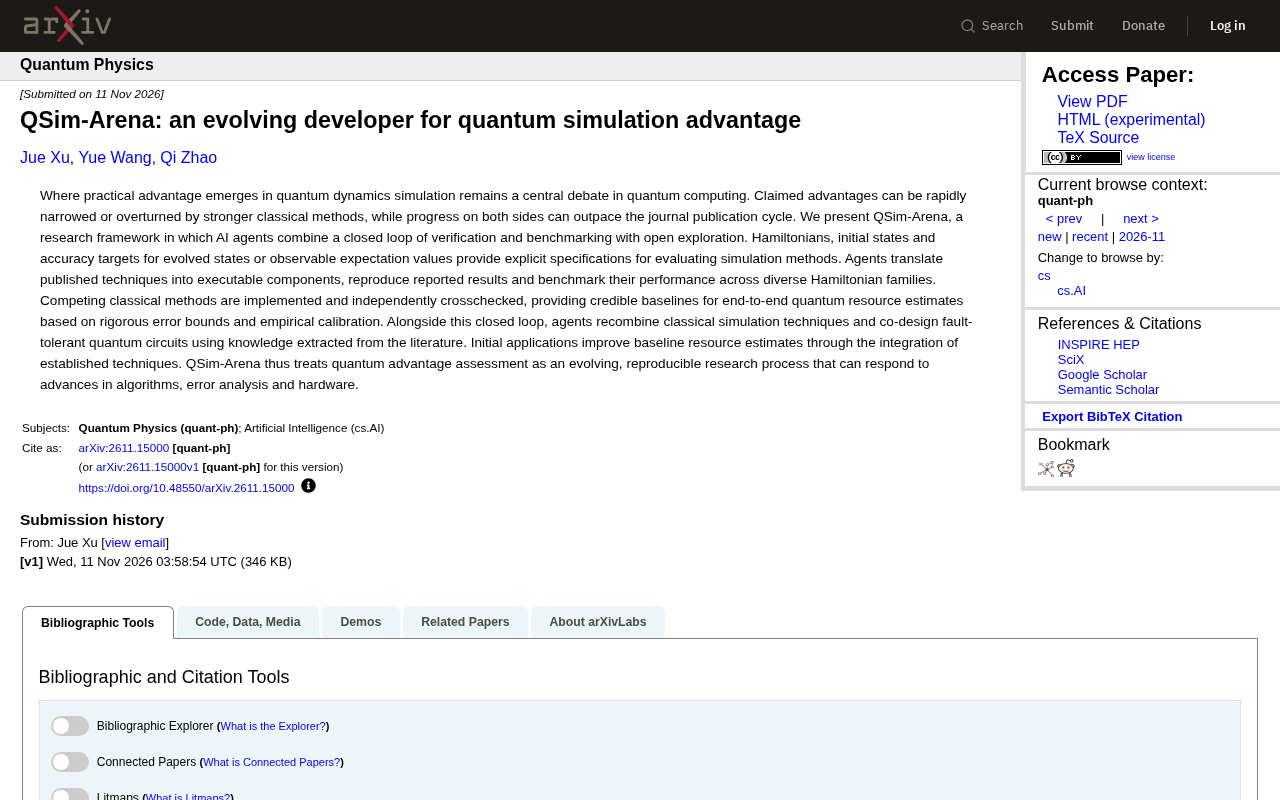
QSim-Arena:AI智能体如何重塑量子模拟优势评估
QSim-Arena 是一个利用 AI 智能体闭环验证与开放探索的研究框架,旨在将量子模拟优势评估转变为持续演进、可复现的过程,应对经典方法快速追赶的挑战。
602个视觉模型跨5款GPU实测:性能差异全解析
Reddit分享的大规模基准测试覆盖602个视觉模型与5款GPU,揭示模型架构与硬件配置的交互影响,为视觉模型部署选型提供跨硬件性能参考。

Continual-ARC:终身学习新基准,揭示AI技能习得的真实瓶颈
Continual-ARC是一个基于ARC-AGI的终身学习基准,通过反馈预算和冻结后测试,公平比较记忆与权重学习。实验发现harness持久化难以提升记忆,缓存基线仍难超越,而权重学习在泛化上优势明显。
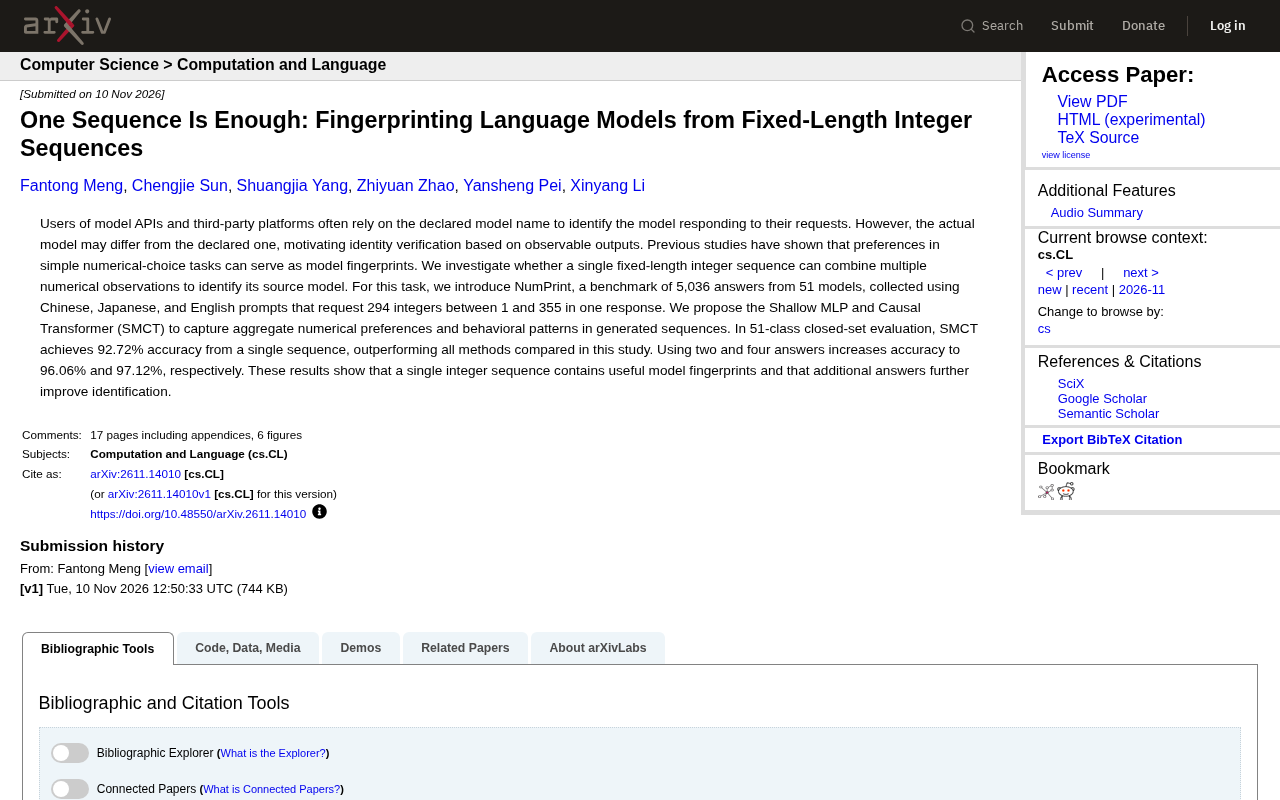
一条整数序列就能指纹识别大模型?NumPrint基准发布
论文提出NumPrint基准,用单条固定长度整数序列识别语言模型身份。SMCT模型在51类闭集评估中单序列准确率达92.72%,两条和四条答案分别提升至96.06%和97.12%。
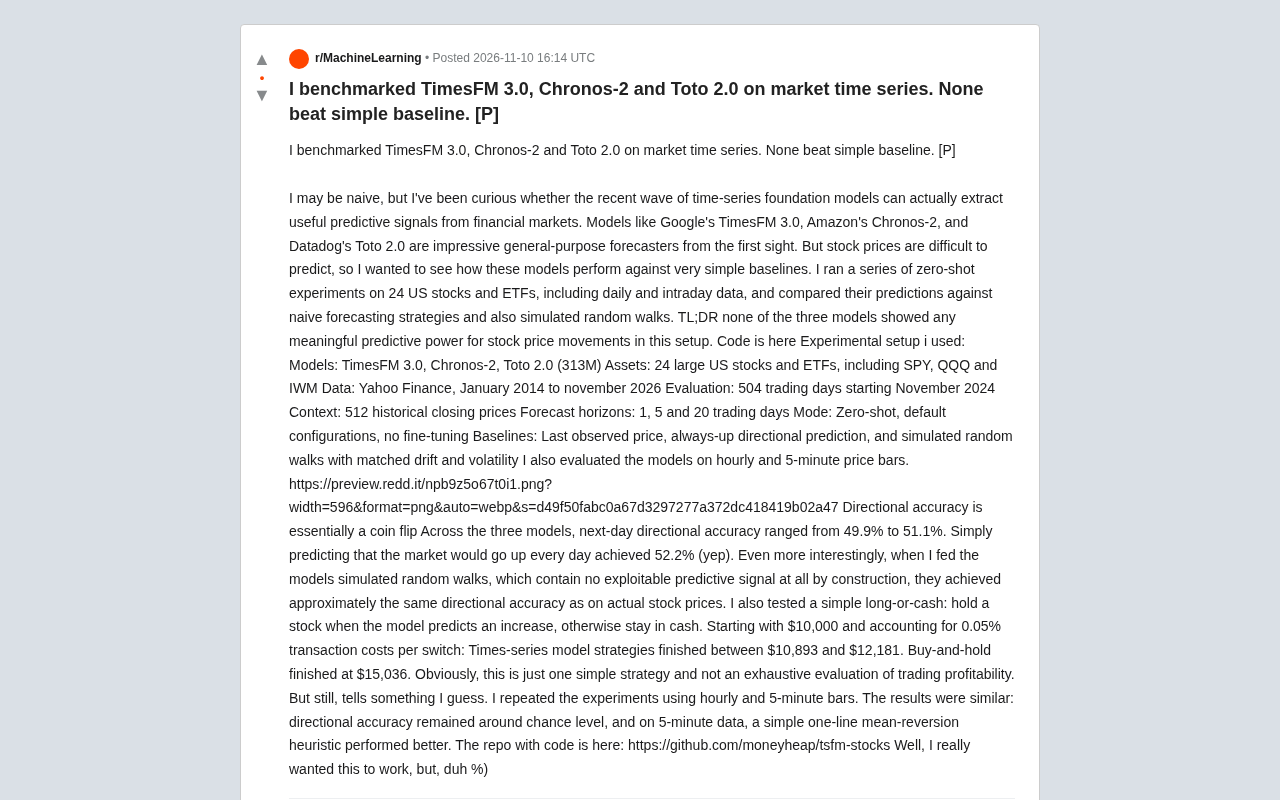
实测TimesFM 3.0、Chronos-2、Toto 2.0:时序大模型跑不赢简单基线
开发者零样本实测TimesFM 3.0、Chronos-2和Toto 2.0在24只美股及ETF上的预测表现,方向准确率仅49.9%-51.1%,模拟交易跑输买入持有策略,时序基础模型在金融数据上未展现超越简单基线的能力。

Infrathon基准:AI智能体长周期优化真实基础设施
Infrathon基准评估语言智能体在真实AI基础设施上的长周期优化能力,发现模型排名随评估周期变化,智能体可超越人类设计基线,并揭示任务违规、测试不可靠等持续改进障碍。

CHO-Bench:上下文提示如何影响LLM广告排名?
CHO-Bench将LLM广告中的上下文提示设计定义为优化问题,通过超119万次配对评估发现:上下文提示能提升广告排名,但嵌入与LLM排序器偏好不同信息维度,且提示预算存在边际递减。

RealEmbedBench:大模型在嵌入式应用层开发中的真实表现
RealEmbedBench 基准包含 5,142 个样本,评估大语言模型在嵌入式应用层代码生成、状态机建模与跨系统翻译中的真实表现,揭示上下文影响与翻译方向性差异。

