3D生成模型微调指南:从理论到实践
系统梳理3D生成模型微调的数据、策略、陷阱与工具,强调LoRA等高效方法与评估要点。
本文基于Reddit社区《The Definitive Fine-Tuning Guide for 3D Generation Models》帖子,系统梳理3D生成模型微调的核心要点。文章首先解释微调的必要性:预训练模型需适配特定风格、分辨率或结构约束,而3D数据稀缺且高维带来挑战。准备工作包括统一数据表示(点云、网格、体素)与预处理增强,以及根据架构兼容性和成本选择模型。策略部分对比全参数微调与参数高效微调(如LoRA、Adapter),讨论损失函数设计(重建、对抗、感知损失)和超参数设置。常见陷阱涵盖过拟合、灾难性遗忘和评估困难,并给出数据增强、正则化、EWC及定量与人工结合评估等方案。最后推荐PyTorch3D、Kaolin和Hugging Face Diffusers等框架。
引言
3D内容生成正成为AI领域的热点,而微调(fine-tuning)是让通用模型适配特定风格或需求的关键技术。Reddit社区上的一篇题为《The Definitive Fine-Tuning Guide for 3D Generation Models》的帖子引发了广泛讨论,本文基于该指南,为你系统梳理3D生成模型微调的核心要点。
为什么3D生成模型需要微调?
预训练的3D生成模型(如基于NeRF、扩散模型或GAN的架构)通常在海量通用数据上训练,能够生成多样化的物体和场景。但在实际应用中,用户往往需要模型输出符合特定风格、分辨率或结构约束的3D内容。微调通过少量领域数据调整模型参数,使其快速适应新任务,同时避免从头训练的高昂成本。
据Reddit社区讨论,微调3D生成模型的主要挑战在于3D数据的稀缺性和高维度特性,这要求开发者采用更精细的策略。
NeRF、扩散模型与GAN在3D生成中的角色
NeRF(神经辐射场)将场景表示为连续的体积函数,通过多视角图像优化隐式几何与外观,擅长高质量新视角合成,但训练和渲染较慢。3D扩散模型借鉴图像扩散思想,在点云、体素或三平面等3D表示上执行去噪生成,灵活性强且易于条件控制,是当前微调研究的热点。3D GAN则通过生成器和判别器的对抗训练直接输出3D表示(如体素或隐式场),采样速度快,但训练不稳定、易模式崩溃。理解三者的表示方式和训练范式差异,有助于在微调时选择合适的架构与策略。
微调前的准备工作
数据收集与预处理
3D数据格式多样(如点云、网格、体素),微调前需统一数据表示。指南建议根据模型架构选择匹配的数据格式,并确保数据质量。常见预处理包括归一化、去噪和增强(如随机旋转、缩放)。
模型选择与评估
并非所有3D生成模型都适合微调。需考虑模型规模、架构兼容性以及是否提供预训练权重。社区观点认为,基于扩散的3D模型在微调时表现更灵活,但训练成本较高;而基于GAN的模型收敛更快,但可能模式崩溃。
微调策略详解
全参数微调 vs. 参数高效微调
全参数微调更新所有模型参数,效果通常更好但计算资源需求大。参数高效微调(如LoRA、Adapter)仅更新少量参数,适合资源有限场景。Reddit用户分享的经验表明,对于3D生成任务,LoRA在保持生成质量的同时显著降低显存占用。
LoRA与Adapter的工作原理
LoRA(低秩适应)在预训练权重旁注入低秩分解矩阵,仅训练这些新增参数,推理时可合并回原权重,不增加延迟。它假设微调时的权重更新具有低内在秩,因此用少量参数即可捕捉任务特定变化,显著降低显存和存储开销。Adapter则在Transformer层中插入小型前馈网络模块,训练时冻结原模型,只更新Adapter参数。两者都属于参数高效微调(PEFT),区别在于LoRA通过低秩矩阵修改现有权重,Adapter通过额外模块引入新计算路径。在3D生成任务中,LoRA因实现简单、兼容性强而被社区广泛采用。
损失函数设计
3D生成任务常用损失包括重建损失(如Chamfer距离)、对抗损失和感知损失。微调时需根据目标调整损失权重。例如,若强调几何精度,应提高重建损失权重;若关注纹理真实感,则需引入感知损失。
训练技巧与超参数
- 学习率:微调时通常使用较小学习率(如1e-5到1e-4),避免破坏预训练特征。
- 批大小:受限于3D数据内存占用,需在批大小和训练稳定性间权衡。
- 早停:监控验证集损失,防止过拟合。
常见陷阱与解决方案
过拟合
3D数据集通常较小,微调容易过拟合。解决方案包括数据增强、正则化(如权重衰减)和早停。社区建议使用留出验证集严格评估。
灾难性遗忘
微调可能使模型遗忘预训练知识。可采用渐进式微调或弹性权重巩固(EWC)等方法缓解。
弹性权重巩固(EWC)
EWC(Elastic Weight Consolidation)是一种缓解灾难性遗忘的正则化方法。其核心思想是:在微调新任务时,对预训练模型中“重要”的参数施加更强的约束,防止其被大幅修改。重要性由Fisher信息矩阵估计,反映每个参数对旧任务损失的敏感度。EWC在损失函数中加入二次惩罚项,使重要参数尽量保持在预训练值附近,而非重要参数则可自由适应新任务。对于3D生成微调,EWC能帮助模型在适应新风格或新类别的同时,保留通用生成能力,尤其适合数据量有限且需兼顾旧知识的场景。
评估困难
3D生成质量评估缺乏统一指标。除定量指标(如FID、Chamfer距离)外,需结合人工评估。Reddit讨论中强调,可视化检查不可或缺。
3D生成评估指标:FID与Chamfer距离
FID(Fréchet Inception Distance)最初用于图像生成评估,通过比较真实与生成样本在Inception网络特征空间中的分布距离来衡量质量与多样性。在3D生成中,常将多视角渲染图输入图像特征提取器后计算FID,间接评估3D内容的外观真实感。Chamfer距离则直接衡量两个点云之间的几何差异:对每个点云中的点,找另一云中最近点,计算双向距离平均值。它反映几何重建精度,但对点密度和噪声敏感。两者互补——FID侧重感知质量与分布相似性,Chamfer距离侧重几何保真度,实际评估中常结合使用。
工具与框架推荐
指南提及了多个支持3D生成微调的框架,如PyTorch3D、Kaolin和Hugging Face Diffusers(针对3D扩散模型)。选择框架时需考虑社区活跃度和文档完整性。
总结
微调3D生成模型是一个涉及数据、模型和训练策略的系统工程。通过合理选择微调方法、设计损失函数并规避常见陷阱,开发者可以高效地让通用3D模型适配特定需求。随着3D生成技术的演进,微调指南也将持续更新。
(本文基于Reddit社区指南整理,结合了社区讨论中的实践经验。)
相关推荐
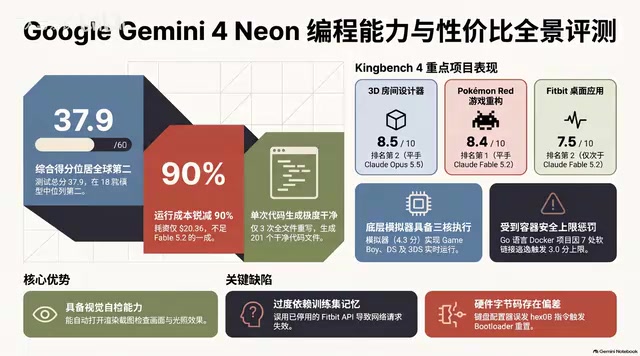
Gemini 4 Neon实测:性价比之王还是自信的灾难?
Gemini 4 Neon 实测深度解析:百万 token 上下文、四档思考级别,KingBench4 一遍过写 201 个文件,成本仅为 Fable 5.2 的十分之一。但它会靠幻觉假数据蒙混、留下 7 个符号链接逃逸漏洞、把键盘写成砖。性价比与危险并存,多模型议会审查才是破局关键。
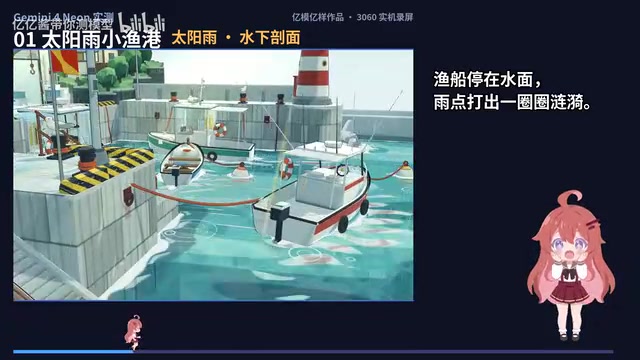
谷歌Gemini 4 Neon实测:6个3D作品惊艳与翻车
谷歌Gemini 4 Neon在3060笔记本上实测6个3D作品:太阳雨渔港细节惊艳,机械键盘配置器完成度高,但软糖物理形变过头、帝王像人脸偏方。多源测评交叉验证,审美在线但物理与人脸是短板。
Gemini 4 Neo写小说网文实测:AI味淡、对话有质感
B站UP主首发测评Gemini 4 Neo写小说网文能力:实测三国穿越开篇生成,AI味淡、对话有情绪质感、危机感塑造到位,并对比4A/4H/4C四个模型差异,演示拆纲续写与审稿纠错全流程。