#微调
共 4 篇相关文章
·6 分钟
支持微调模型为何大讲Python推理?一次LoRA训练翻车复盘
一位开发者为企业做LoRA微调时,replay数据中数学代码样本的token量反超全部工单,导致支持模型在回答账号锁定问题时输出Python推理代码。复盘数据配比、长度检查与修复方案。
阅读全文 →
·9 分钟
Prompting、RAG与微调怎么选?先诊断故障再定方案
大模型出错别急着换模型或微调。本文基于诊断优先的思路,对比 prompting、RAG 与 fine-tuning 的适用边界,附决策流程、架构职责划分与评估维护清单。
阅读全文 →
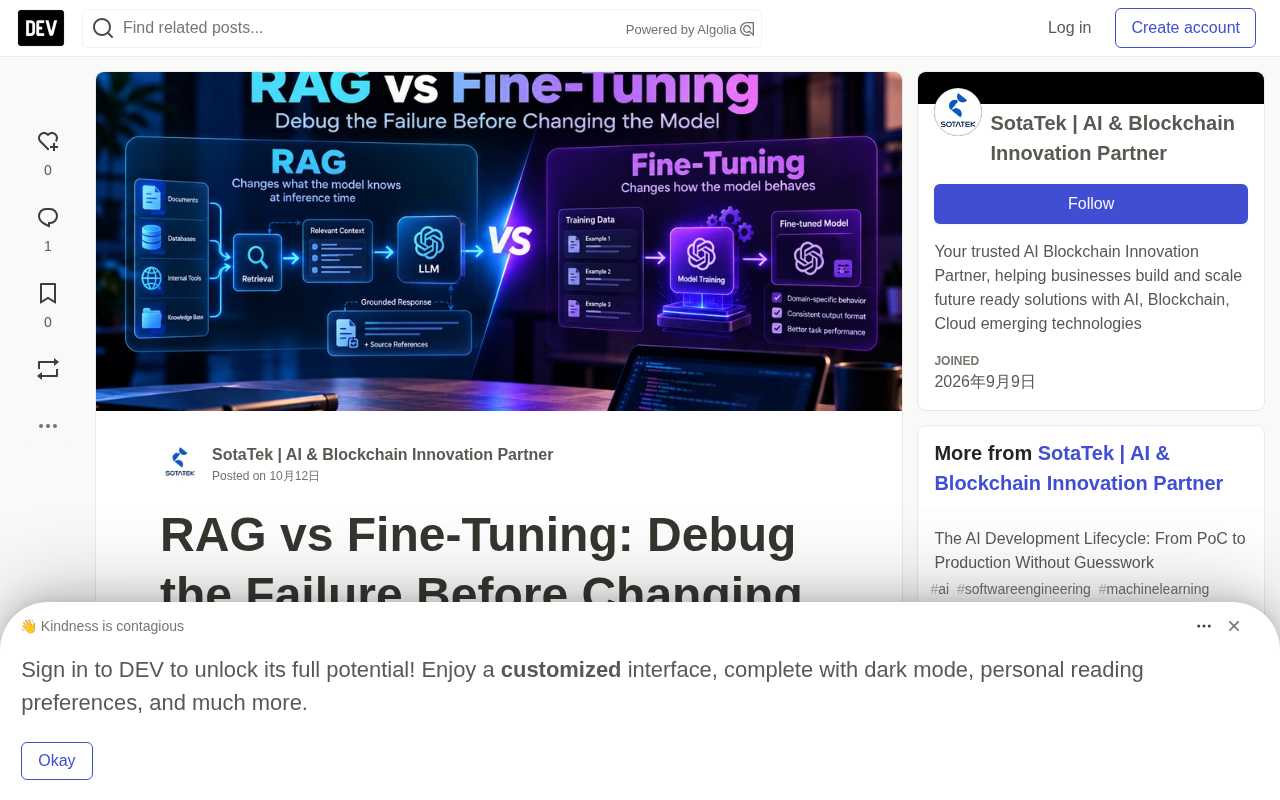
·7 分钟
RAG还是微调?先诊断故障再决定是否换模型
LLM 应用出错时该用 RAG 还是微调?本文提出先按检索、上下文、生成三层诊断故障,建立评估基线,再选择最小必要的干预,并给出成本权衡与可落地的决策框架。
阅读全文 →

·6 分钟
SFT为何比RFT更易遗忘?风格漂移揭示监督微调的隐性代价
新发布的arXiv论文通过线性-softmax模型,从数学上解释了监督微调(SFT)为何比强化微调(RFT)更容易灾难性遗忘。核心在于SFT会产生离轴风格漂移,导致即使语义正确也会丢失知识,而RFT能保持零语义误差。
阅读全文 →