3天构建公司大脑:图谱记忆如何让AI的每个答案有据可查

开源项目Recall用图数据库构建可溯源、按人隔离、需人类批准的公司记忆系统。
Recall是一个开源项目,旨在解决传统RAG在企业知识管理中的不足。它利用图数据库FalkorDB将公司知识建模为节点和边,支持因果链查询、依赖遍历和专家排序。系统要求每个结论必须可引用,记忆按人隔离并版本化,遗忘操作签发回执。Agent执行前必须暂停等待人类批准,审批动作持久化到图中。基准测试显示图检索优于扁平RAG,作者公开全部失分,并总结出七条原则,强调可见性和证据边界是可信度的来源。
大多数人对“公司大脑”的想象,是一个能回答文档问题的聊天机器人。但开发者Anshu在三天内构建的开源项目Recall,指向了一个更根本的问题:当工程师问“INC-231为什么会发生”时,系统需要的不是一段语义相似的文本,而是一条完整的因果链——哪个PR、哪个决策、哪次提交导致了事故,以及谁最了解相关系统。
这篇文章拆解Recall的设计思路:用图数据库FalkorDB承载公司知识的因果关系,让每个答案都可溯源,让记忆按人隔离并按版本管理,让Agent在执行前必须停下来等待人类批准。
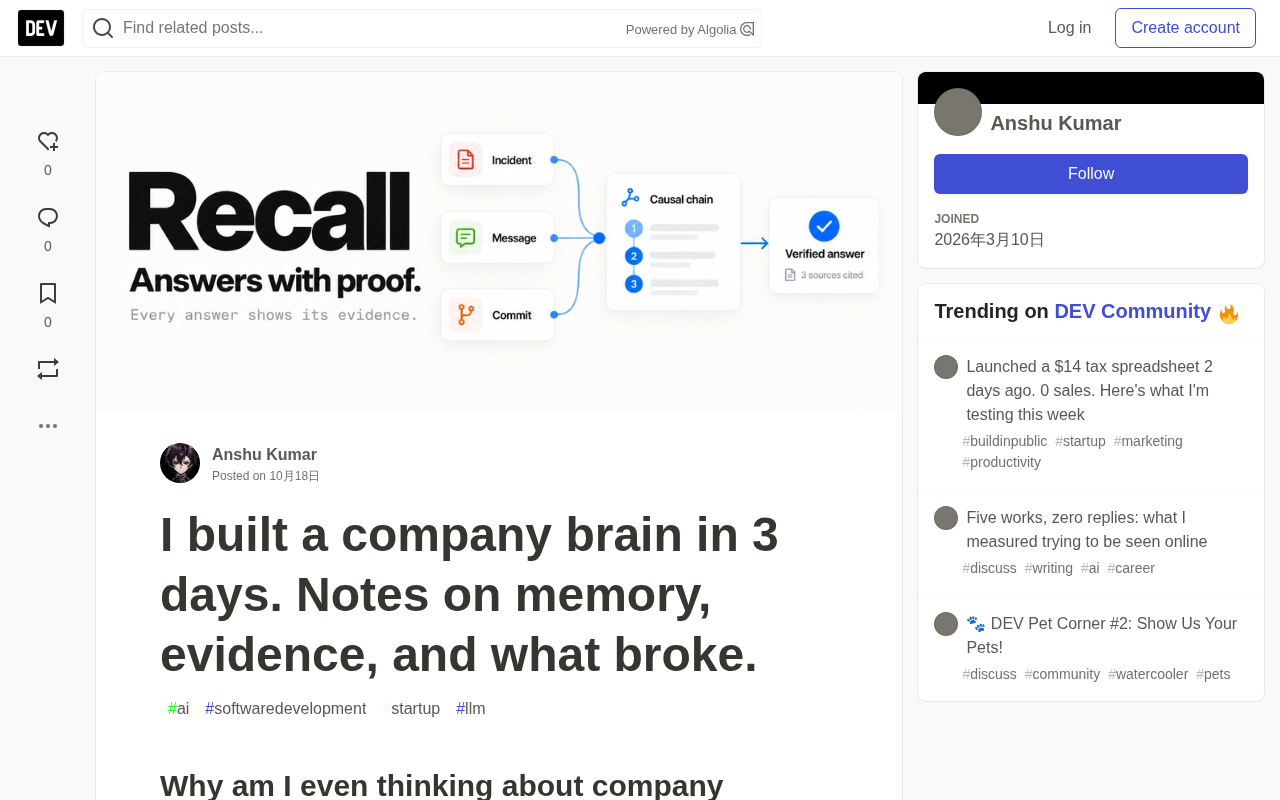
为什么RAG不够用
传统RAG把文档切块、向量化,再靠语义相似度检索。这套方法适合“找一段相关内容”,但公司里真正有价值的问题往往不是相似性问题,而是连接性问题。
“为什么发生”是路径问题;“改这个会破坏什么”是遍历问题;“谁懂这个系统”是排序问题。三类问题都指向同一件事:知识之间的关系比知识本身更重要。
因此Recall把公司知识建模为图:事件、PR、提交、架构决策记录(ADR)、服务、人员、团队、聊天消息都是节点,用带标签的边连接,全部可通过Cypher查询。作者特意声明,演示公司Meridian Pay是虚构的,人员与事故均为种子测试数据,但FalkorDB实例、查询语句和Agent行为是真实的——这种对证据边界的坦诚,本身就是项目设计哲学的一部分。
图数据库与Cypher查询
图数据库以节点和边为基本存储单元,天然适合表达实体间的多跳关系。与传统关系型数据库不同,图数据库在遍历深层次关联时无需昂贵的JOIN操作,而是通过指针直接跳转,因此“找到导致事故的PR”这类路径查询效率极高。FalkorDB是一款基于稀疏矩阵和线性代数的图数据库,支持属性图模型,并兼容OpenCypher查询语言。Cypher是一种声明式图查询语言,用类似ASCII艺术的模式描述路径,例如(e:Event)-[:CAUSED_BY]->(pr:PR)表示事件由PR导致。Recall利用Cypher实现因果遍历、依赖分析和专家排序,使每个结论都能沿着图中的边回溯到源节点。
每个结论都必须可引用
Recall的核心规则很硬:模型无法引用某个节点,就不能说出对应结论。当用户询问事故原因时,Agent执行的是因果遍历,而非文本生成:先定位事件,再追溯致因的PR与决策,展示完整路径,沿途标注来源,最后列出相关人员和最了解该系统的专家。
这与绝大多数AI产品的体验形成反差。通常你得到的是自信流畅的段落,却无法核查、无法追溯,只能选择相信模型。Recall把顺序倒过来:答案的质量取决于引用的质量,而引用就摆在答案旁边。
因果遍历与可溯源推理
因果遍历是指在图中有方向地探索“原因-结果”路径,而非简单的关键词匹配。在Recall中,当用户询问事故原因时,Agent从事件节点出发,沿着CAUSED_BY、DECIDED_BY、AUTHORED_BY等带标签的边逐层追溯,直到找到根因节点(如某个提交或ADR)。沿途每个节点都附带来源信息(如PR链接、聊天记录ID),这些来源构成引用链。可溯源推理则要求模型在生成答案时,只能使用遍历中实际访问到的节点作为依据,从而杜绝幻觉。这种机制将答案的可靠性从模型本身转移到图的结构和引用完整性上。
记忆有边界,也有生命周期
公司记忆不是全局的。如果Priya告诉系统“部署窗口是下午2点到4点”,这属于Priya的记忆,不应自动变成同事Anshu的事实。Recall为每个人建立独立的记忆图,运行在同一个FalkorDB实例中。
记忆还会演化。当Priya后来说“改成凌晨2点到4点”,旧事实不会被删除,而是标记为被取代(superseded),新事实成为活跃版本。过去被版本化,但从不被重写。若用户要求彻底遗忘某条事实,系统会执行遗忘操作并签发一份“擦除回执”,可以证明什么在何时被删除。
这个设计解决了许多企业AI落地时的隐性阻力:员工不信任一个会悄悄改写或混用记忆的系统。
版本化记忆与擦除回执
版本化记忆指对事实的每次变更保留历史版本,而非覆盖旧值。Recall采用“取代”策略:新事实标记旧事实为superseded,但旧事实仍存在于图中,仅状态改变。这使得系统可以回答“过去某个时间点的事实是什么”,满足审计和合规需求。擦除回执是用户要求彻底遗忘时系统签发的证明,记录被删除事实的标识、删除时间及操作者,但回执本身不包含事实内容。这种设计平衡了记忆的可用性与用户对数据控制的诉求,尤其适用于企业环境中员工对隐私和记忆归属的敏感场景。
暂停是功能,不是缺陷
当用户问“迁移账本数据库会破坏什么”,Agent会沿服务依赖向外遍历、排列影响面、给出迁移提案——然后停下来。
这个暂停是刻意的。没有人类点击批准,什么都不会发生。而批准动作本身会成为图中的一个节点,因此审计轨迹即使在后端重启后依然存在。作者通过在一次审批中途杀掉后端进程验证了这一点:执行器从FalkorDB读取已批准的提案,而非从进程内存读取,于是流程从中断处恢复。
这对应一条原则:Agent提议,人类处置。执行前的停顿是整个循环中最重要的环节。
人类在环与持久化审批
人类在环(Human-in-the-loop)指在自动化流程中设置必须由人类确认的检查点,以确保关键操作受控。Recall将审批动作建模为图中的一个节点(如Approval),并关联到提案节点。由于审批状态持久化在FalkorDB中,执行器在恢复时从图数据库读取已批准的提案,而非依赖易失的进程内存。这实现了审批的原子性和可恢复性:即使后端崩溃,已批准的提案不会丢失,未批准的也不会误执行。该模式将人类决策嵌入图结构,使审计轨迹成为知识图谱的一部分,而非旁路日志。
杀开关:拔掉数据库,产品就该诚实地说不知道
黑客松规则要求FalkorDB必须是核心而非装饰——“如果拿掉FalkorDB产品依然工作,那图就是装饰品”。
Recall把这个测试内建到演示里:断开FalkorDB,整个产品退化为诚实的“我不知道”。没有静默降级,没有假装还能回答。多数演示告诉你数据库很重要,Recall直接展示没有它会怎样。
基准测试,包括失分
作者运行了30个问题、五个类别,对比图检索与扁平RAG,同语料、同模型、同评分标准。结果:图检索24.667分,扁平RAG 19.251分。
但重点在于坦诚:图检索丢了5.333分,其中两个硬零分是因为评分器要求精确措辞而模型做了改写,其余是各分类的零散部分得分损失。README记录了每一处失分。作者本可以调整问题或删掉零分项,但没有这样做——一个以“展示工作过程”为卖点的系统,其基准测试也必须展示自己的工作过程。复跑验证中,图检索再次胜出,25.0对19.251,差距一致。
最难的Bug在测试套件里
最棘手的问题不在图数据库,而在测试代码。一个端到端检查断言模型回答中必须包含字面字符串“Ledger freeze ends Friday”,结果在四次运行中以四种方式失败:小写、Markdown加粗、不可见的窄不换行空格、以及改写为“ends on Friday”。数据每次都是正确的,错的是断言。
作者的结论干脆利落:永远不要对LLM的散文做断言,要对结构化数据做断言。重写后的测试检查结构化的证据块,稳定性问题消失。
另一条经验是:搜索记忆之前先划定范围。不要把整个记忆库倒进模型指望它自己分辨相关性,先解析用户、解析作用域,只检索适用的部分,再做排序。
一句话概括与七条原则
Recall可以概括为:把公司的因果历史保存在图中并基于它推理,让每个答案追溯路径、每段记忆尊重归属、每个行动等待人类。
作者提炼的七条原则值得任何构建企业AI系统的人参考:每个结论需要引用;记忆按人划分作用域;过去被版本化而非重写,删除要签发回执;Agent提议、人类处置;图是基础而非功能,断开后产品应诚实停止;展示失分,隐藏零分的基准是营销,记录零分的基准才是证据;不要断言LLM的散文,断言结构化数据。
这些原则的共同指向是可见性——包括失败在内的所有环节都可见,而这正是可信度的来源。项目代码与演示视频已在GitHub和YouTube公开。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。